Geminiの回答が遅いとき、まず疑うべき原因は何か
遅さの原因はサーバー混雑・モデルと思考レベル・指示の重さの3系統に分かれる
 室谷代表取締役
まず整理したいのが、反応が遅い原因って一つじゃないんですよね。Google側のサーバーが混んでいるのか、使っているモデルや思考レベルの設定なのか、こちらの指示が重いのか。
この3系統で見ると、切り分けが一気に楽になります。
この3系統で見ると、切り分けが一気に楽になります。
 テキトー教師DotAI 認定講師
現場でよく聞くのは「とにかく遅いんです」で全部ひとまとめになっちゃってるケースですね。原因が違えば打ち手も全く変わるので、そこを分けるだけで迷いが減ります。
室谷代表取締役サーバー側は待つしかない。でも設定と使い方は自分で触れる。
コントロールできない外部要因に時間を溶かすより、動かせる変数を先に動かす方が合理的なんですよ。
コントロールできない外部要因に時間を溶かすより、動かせる変数を先に動かす方が合理的なんですよ。
テキトー教師DotAI 認定講師たしかに。順番としては、まずモデルと思考レベルを見る、次にプロンプトの長さを見る、それでもダメなら外側を疑う。
この流れが一番早いですね。
この流れが一番早いですね。
長い会話・長いプロンプト・ファイル添付で処理時間が伸びる理由
テキトー教師DotAI 認定講師ここ、ハマる人多いんですよ。一つのチャットで何十往復も続けたまま、さらに長い資料を貼り付けて要約を頼む。
これだけで待ち時間は伸びます。
これだけで待ち時間は伸びます。
室谷代表取締役計算量が増えるから、というシンプルな話なんですよね。公式の説明でも、多角的な分析や複雑なプログラム生成、長文の要約はAIの思考プロセスが増えて処理時間が長くなるとされています。
テキトー教師DotAI 認定講師しかも長い会話は、一回のやり取りで読む量そのものが育っていく。初めて触る人は、会話が長引くほど重くなる感覚を持っておくと納得しやすいです。
話題を変えるときは新しいチャットに移すのが基本ですね。履歴の扱いはGemini(ジェミニ)の履歴の見方|確認・検索・削除と消えたときの対処で細かく解説しています。
話題を変えるときは新しいチャットに移すのが基本ですね。履歴の扱いはGemini(ジェミニ)の履歴の見方|確認・検索・削除と消えたときの対処で細かく解説しています。
室谷代表取締役あとファイル添付。画像やPDFを何個も入れると、それだけで処理対象が増えます。
まず本文だけで聞いて、必要なら添付する。この順番の方が速いことが多いです。
まず本文だけで聞いて、必要なら添付する。この順番の方が速いことが多いです。
Google側の障害かどうかはステータスダッシュボードとXで確認する
室谷代表取締役次は外側を疑う番です。Google側の障害や広い範囲の遅延かどうかは、Google Workspace ステータスダッシュボード(google.com/appsstatus/dashboard)で確認できます。
テキトー教師DotAI 認定講師ここで「自分の環境が悪いのかも」と延々設定をいじるのが一番もったいない。ダッシュボードに異常が出ていれば、待つ以外に打ち手はほぼないですからね。
室谷代表取締役X を見るのも有効で。速度が遅い、回答もおかしいという声が同時多発しているときは、個別の環境要因より全体の状態を疑った方がいい。
ただ投稿は利用者の実感なので、公式見解というわけではないです。
ただ投稿は利用者の実感なので、公式見解というわけではないです。
テキトー教師DotAI 認定講師たしかに。X は「他の人も同じ状況か」を見る温度計としては便利ですね。
ダッシュボードが正常で X も静かなら、次は自分の設定側を見に行く。
ダッシュボードが正常で X も静かなら、次は自分の設定側を見に行く。
時間帯で速度が変わるのはなぜ?混雑しやすい時間の考え方
テキトー教師DotAI 認定講師時間帯で変わるのは、世界中のアクセスが同じ場所に集中するからです。日本が夜でも地球の裏側が昼なら、どこかしら混んでいます。
室谷代表取締役だから空いている時間を探すより、混んでいる時間に重い処理を投げないという発想の方が現実的で。急ぎじゃない長文要約をピーク時に回すのは、時間の使い方としてもったいないんですよね。
テキトー教師DotAI 認定講師公式の案内でも、対処として時間帯を変えることが挙げられています。加えて、待ちきれないときは軽いモデルに切り替える、思考レベルが「拡張」なら「標準」に戻す、指示を細かく分ける。
この3つは効きが早いです。
この3つは効きが早いです。
室谷代表取締役なるほど。時間帯は最後の調整弁くらいに考えておくのがよさそうですね。
回線が悪いのかPCが重いのか、自分で見分けるチェック手順
回線かPCかを見分ける切り分けフロー
下り50Mbpsと10Mbps、まず回線の目安を知る
室谷代表取締役切り分けの順番なんですけど、回線と端末のどっちが原因かで打つ手がまるで変わるんですよね。回線なら時間帯を変えるしかないし、端末側なら今日中に直せますから。
テキトー教師DotAI 認定講師たしかに。最初に見てもらうのは下りの速度です。
50Mbps以上出ていれば快適な範囲、10Mbpsを切ると遅延が出やすいと言われてます。
50Mbps以上出ていれば快適な範囲、10Mbpsを切ると遅延が出やすいと言われてます。
室谷代表取締役ただこれ、Google公式の基準ではなくて、PC販売サイトやブログが独自に示してる目安なんですよ。数字は参考程度に捉えてほしいんですよね。
テキトー教師DotAI 認定講師そうなんです。測って明らかに遅いなら時間帯を変える、測って問題ないなら端末を疑う。
この一行で半分は絞れます。
この一行で半分は絞れます。
WindowsでCPU・メモリ・ディスクの張り付きを見る
Ctrl+Shift+Escを押してタスクマネージャーを開く- 「パフォーマンス」タブでCPU・メモリ・ディスクの使用率を見る
- 80〜100%近辺で張り付いていないか確認する
- 張り付いていれば、重いアプリを閉じてもう一度試す
テキトー教師DotAI 認定講師現場でよく聞くのは「回線は速いはずなのに遅い」というケースで、実際に開いてもらうとCPUが常時ほぼ満タンだったりするんですよ。
室谷代表取締役それ、Geminiの問題じゃなくて端末が限界って話ですもんね。ディスクがHDDだとAIを使うときの遅延が出やすい、SSDは比較的ボトルネックになりにくいというのも目安としてよく言われます。
テキトー教師DotAI 認定講師あと見落としがちなのが、裏で別のアプリが動きっぱなしになっているパターンです。閉じるだけで体感が変わることは普通にあります。
タブと拡張機能を減らす、メモリ16GBはあくまで目安
室谷代表取締役ブラウザのタブを何十個も開いたまま、拡張機能も盛りだくさん、みたいな状態だとメモリが足りなくなりますよね。うちの現場でも端末のスペックは一度棚卸ししたほうがいいなと感じてて。
テキトー教師DotAI 認定講師そうですね。快適に使うためのメモリの目安として16GB程度と言われることが多いんですが、これも公式の数値ではないんですよ。
8GBでも軽い設定なら動きますし、16GBあってもタブで埋まれば同じです。
8GBでも軽い設定なら動きますし、16GBあってもタブで埋まれば同じです。
室谷代表取締役つまり容量より「空き」を見ろってことですね。
テキトー教師DotAI 認定講師そこです。拡張機能を一時的にオフにして比べると、原因が自分で特定できます。
スマホアプリが遅いときは再起動・更新・回線切り替え
- アプリを完全に終了して起動し直す
- アプリとOSのアップデートを確認する
- Wi-Fiとモバイル回線を切り替えて同じ質問を試す
テキトー教師DotAI 認定講師スマホのときはこの3つで大体の切り分けがつきます。Wi-Fiで遅くてモバイル回線だと普通、なら回線側の問題だと判断できますから。
室谷代表取締役逆に両方ダメなら端末かアカウント側ですよね。設定アイコンから使用量上限を見る場所もあるので、そっちの線も疑ったほうがいい。
テキトー教師DotAI 認定講師そうなんです。端末を疑って直らないときは、原因が別のところにあると思って切り替えるのが早いです。
使うモデルと思考レベルを変えると、実際どれくらい速くなる?
モデル・思考レベルを切り替える操作順
- 1PC(ブラウザ)gemini.google.comを開く → 上部メニューの設定アイコン → 「モデル」や定期購入の管理から切り替え
- 2モバイルアプリ左側メニュー → プロフィール → 設定 → 「モデル」や定期購入の管理を開いて切り替え
- 3使用量上限の確認gemini.google.com左下の設定アイコン → 「使用量上限」のアイコンを選ぶ
- 4思考レベルを「標準」に戻す「拡張」になっていたら「標準」に戻す。項目名や置き場所は画面・バージョンで変わるため公式ヘルプで確認
- 5手動切り替えの前提Geminiアプリは基本自動選択。手動で切り替えるにはログインが必要(未ログインだと選択肢が出ない)
Pro系が重いのは「考える量」が違うから
室谷代表取締役ここ、まず前提を揃えたいんですけど。Pro系のモデルは高度な推論をするために計算量そのものが多くて、生成に時間がかかる傾向があるんですよ。
Flash-Liteみたいな軽量・高速処理に特化したモデルとは、そもそも処理する仕事量が違うんですよね。
Flash-Liteみたいな軽量・高速処理に特化したモデルとは、そもそも処理する仕事量が違うんですよね。
テキトー教師DotAI 認定講師そこ、混同されがちなんですよ。「同じGeminiなのに急に遅い」ってなるのは、裏で動いてるモデルが違うからで。
初めて触る人は「アプリが重い」だと思い込んでしまうんですよね。
初めて触る人は「アプリが重い」だと思い込んでしまうんですよね。
室谷代表取締役昨日は速かったのに今日は遅い、っていうなら設定か混雑か使用量のどれかですから。まあ最初に見るべきは「今どのモデルで走ってるか」なんですよ。
重いモデルで軽い相談をしてるなら、切り替えるだけで体感は変わりますから。
重いモデルで軽い相談をしてるなら、切り替えるだけで体感は変わりますから。
テキトー教師DotAI 認定講師たしかに。そこを確認せずに回線のせいにして、延々とルーターを再起動してる人、現場でよくいます。
思考レベルを「標準」に戻すときの操作順
まず設定画面の開き方から。ログインした状態で、次の順に進みます。
PC(ブラウザ)
- gemini.google.com を開く
- 画面上部メニューの設定アイコンを選ぶ
- 「モデル」や定期購入の管理から、使うモデルを切り替える
モバイルアプリ
- 左側メニューを開く
- プロフィール → 設定 の順に選ぶ
- 「モデル」や定期購入の管理を開いて切り替える
使用量上限の確認
- gemini.google.com の左下にある設定アイコンを選ぶ
- 「使用量上限」のアイコンを選ぶ
テキトー教師DotAI 認定講師思考レベルが「拡張」になっていたら「標準」に戻す、というのが公式回答でも挙がってる対処なんですよね。ただ、思考レベルの項目名や置き場所は画面やバージョンで変わることがあるので、そこは公式ヘルプで確認してほしいです。
室谷代表取締役ああ、そこは断言しない方がいいですね。設定画面の導線だけ押さえておけば、あとは公式の記載どおりに辿ればいい。
テキトー教師DotAI 認定講師そうですね。拡張だと多角的な分析や長文の要約で思考プロセスが増えるので、軽い質問には標準で十分なんですよ。
モデルを手動で切り替えるにはログインが要る
室谷代表取締役で、地味な落とし穴がこれで。Geminiアプリは基本、自動で最適なモデルを選ぶ仕様なんですよ。
手動で切り替えたいならログインが必要なんですよね。
手動で切り替えたいならログインが必要なんですよね。
テキトー教師DotAI 認定講師そうなんです。ログインしてない状態だと選択肢そのものが出てこないので、「切り替えボタンがない」って相談になるんですよ。
まずログイン、が最初の一歩ですね。
まずログイン、が最初の一歩ですね。
室谷代表取締役Pro系のモデルが今どういう扱いなのか、料金も含めて先に知っておきたい人は、Gemini 3.1 Proは今もプレビュー?性能・料金・使えない時の対処までを読んでおくと判断が早いと思います。切り替え先を選ぶ材料になりますから。
テキトー教師DotAI 認定講師軽いモデルに逃がすのが常套手段ではあるんですけど、品質が要る作業まで全部軽くしちゃうと本末転倒なので、そこは使い分けなんですよね。
有料プランにすれば速くなる?料金と利用枠の違いを数字で見る
プラン別の料金・使用量上限・コンテキストウィンドウ
| プラン | 月額(日本) | 上限倍率 | コンテキストウィンドウ | 利用モデル |
|---|---|---|---|---|
| プランなし | 0円 | 標準 | 32,000トークン | — |
| Google AI Plus | 725円 | 標準の2倍 | 128,000トークン(※) | Gemini 4 Hydrogen |
| Google AI Pro | 2,900円 | 標準の4倍 | 100万トークン | Gemini 4 Neon |
| Google AI Ultra | 14,500円〜 / 32,000円 | Proの5倍または20倍 | 100万トークン | Gemini 4 Carbon |
お金で買えるのは「速さ」ではなく「余裕」
室谷代表取締役ここ、誤解されやすいんですけど、有料プランにしても生成スピードそのものが上がるわけじゃないんですよね。買っているのは使用量の余裕で、上限に引っかかって軽いモデルに落ちる回数が減る、というイメージなんです。
テキトー教師DotAI 認定講師現場でも「有料にしたのに速くならない」という声は聞きます。ただ話を聞いていくと、上限に当たってFlash-Liteに切り替わっていたパターンが多いんですよ。
そこは料金とは別の話なんです。
そこは料金とは別の話なんです。
室谷代表取締役そう、それが混ざるんですよね。無料で使っていて急に軽くなった人は、まず残量を疑う。
料金は速度の課金じゃなくて計算資源の課金なんです。
料金は速度の課金じゃなくて計算資源の課金なんです。
テキトー教師DotAI 認定講師たしかに。残量を見る、それでも遅いなら回線やモデルを見る。
この順番が無駄がないですね。
この順番が無駄がないですね。
月額・倍率・コンテキストウィンドウを数字で並べる
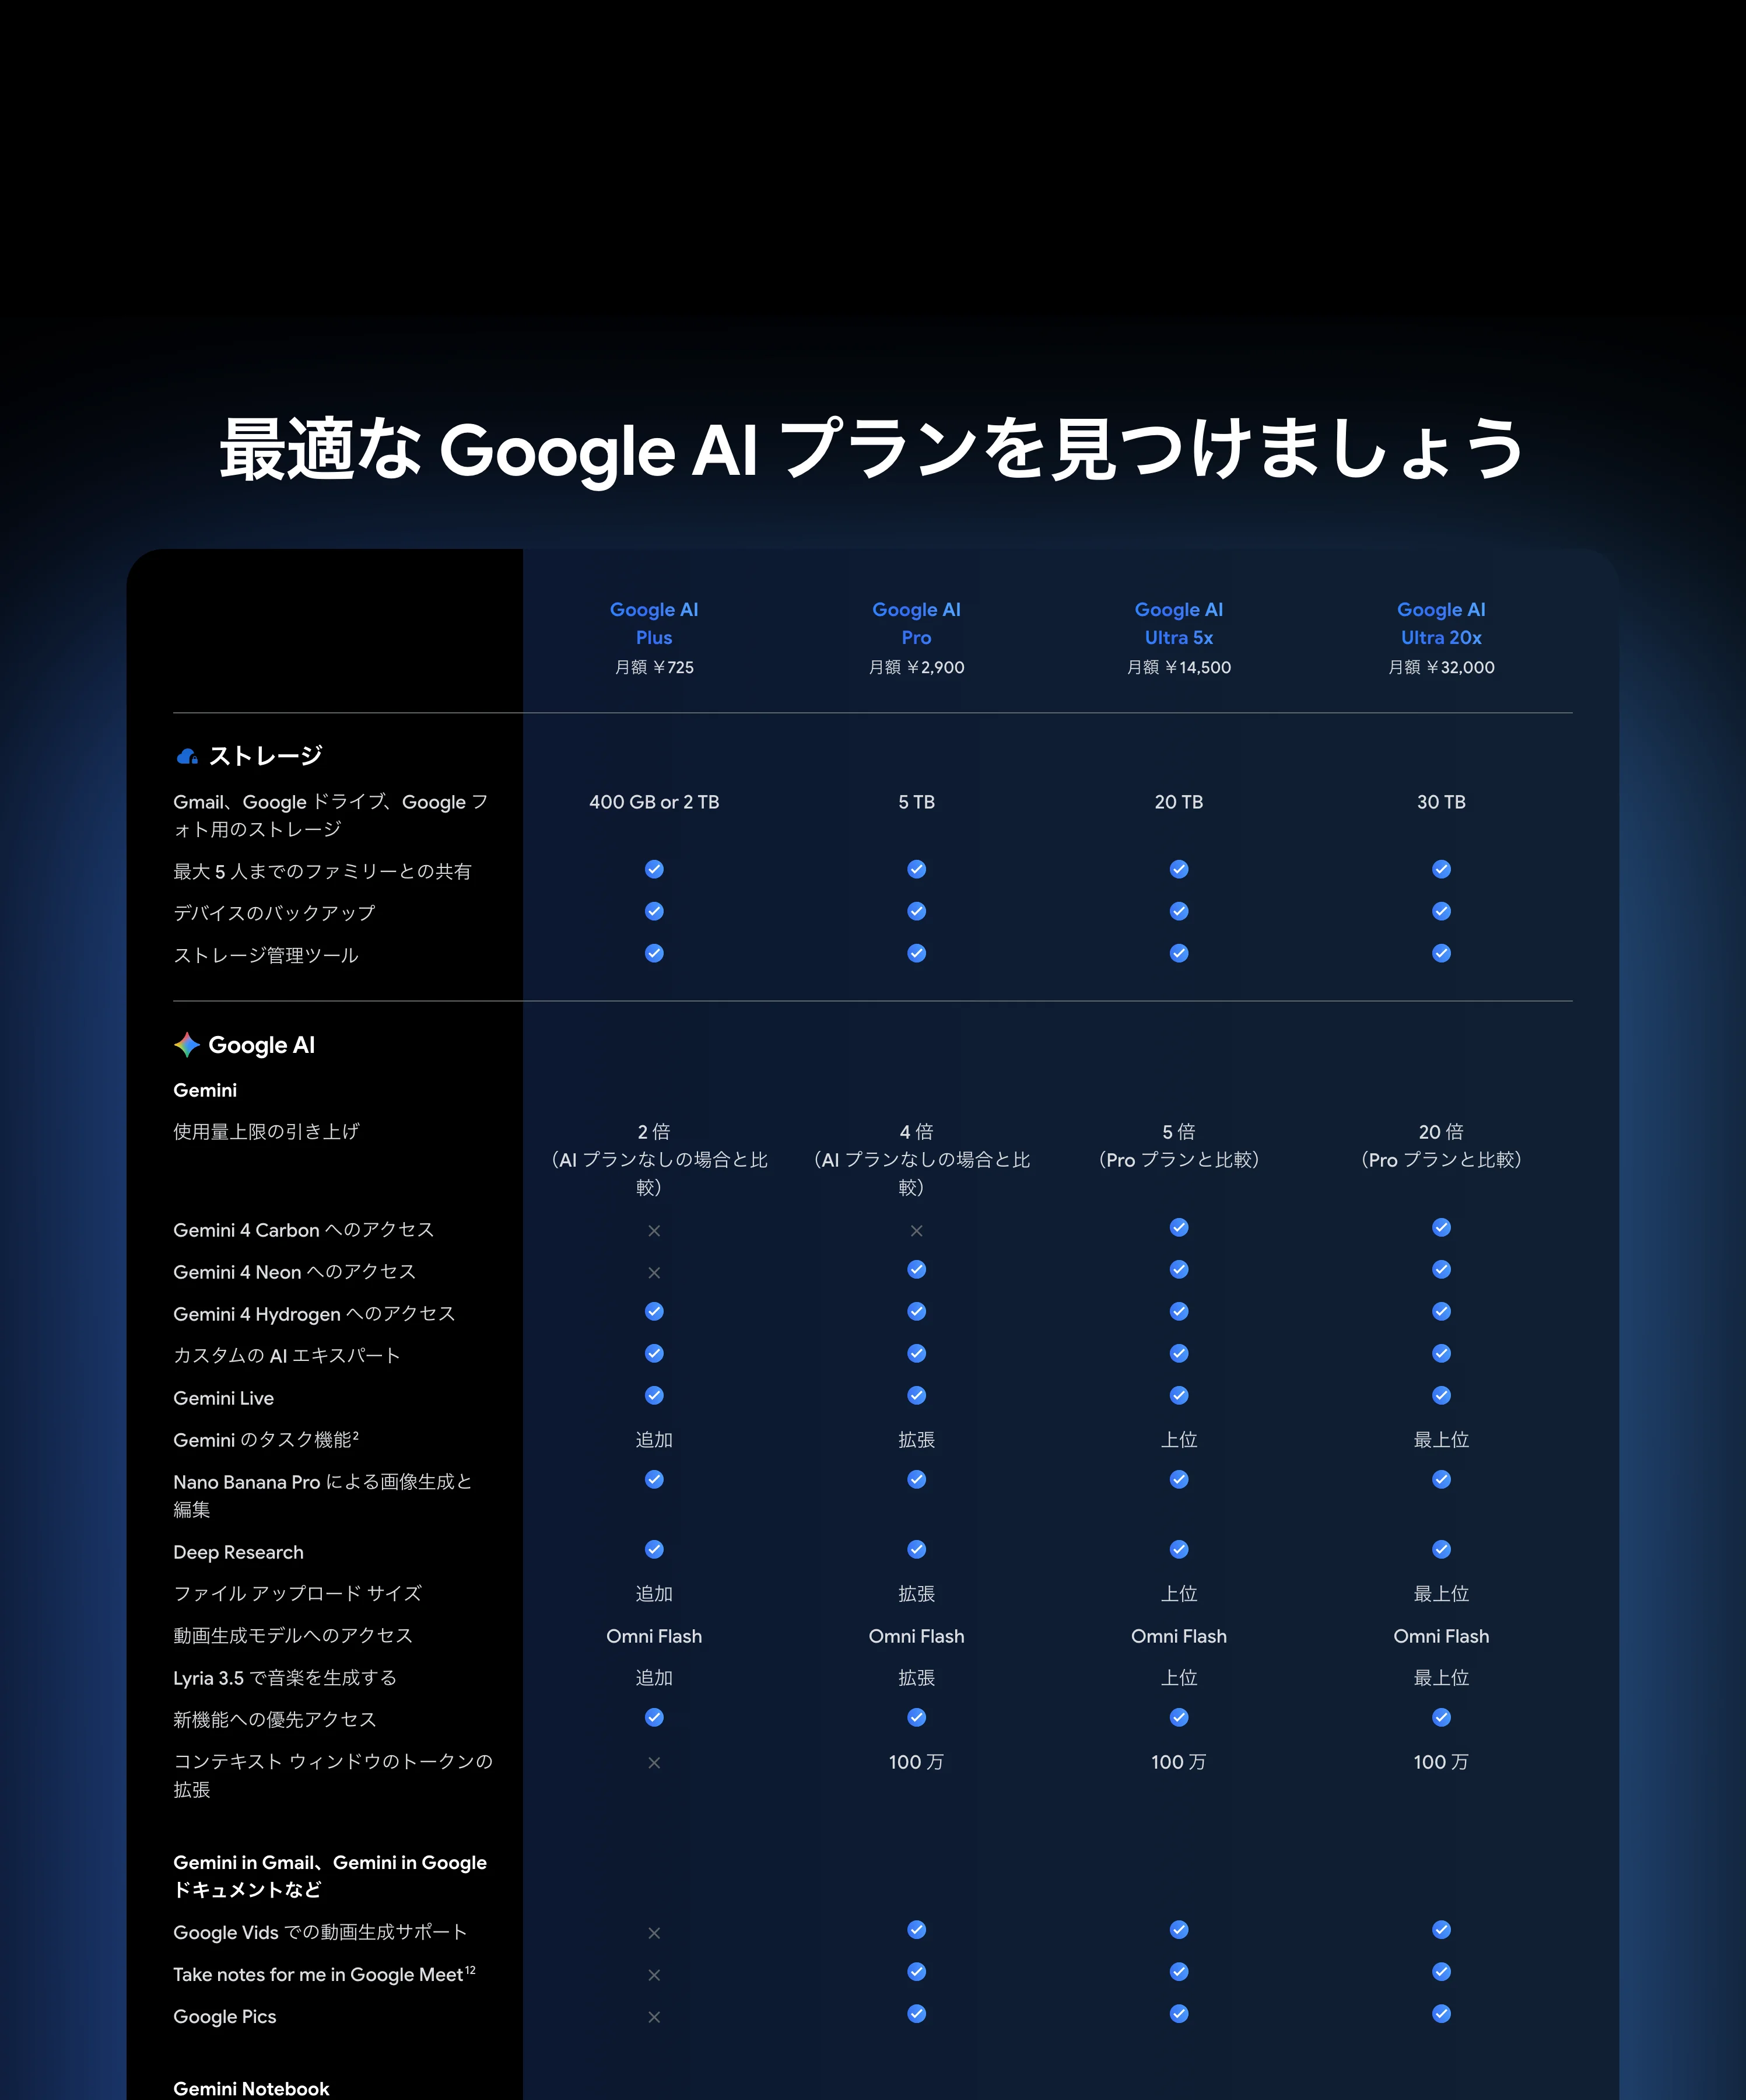
室谷代表取締役数字を一度並べますね。使用量上限は5時間ごとにリセットされて、週の上限に達するまで使える仕組みです。
| プラン | 月額(日本) | 使用量上限の倍率 | コンテキストウィンドウ |
|---|---|---|---|
| プランなし | 0円 | 標準 | 32,000トークン |
| Google AI Plus | 725円 | 標準の2倍 | 128,000トークン(※) |
| Google AI Pro | 2,900円 | 標準の4倍 | 100万トークン |
| Google AI Ultra | 14,500円〜 / 32,000円 | Proの5倍または20倍 | 100万トークン |
テキトー教師DotAI 認定講師Plusの128,000トークンは公式ヘルプに明記されている数字なんですが、公式のプラン比較ページだと「コンテキストウィンドウの拡張」がPlusには付かない表記になっていて。食い違ってるので、契約前に公式で確認したほうがいいです。
室谷代表取締役Ultraの倍率も、料金ページは「Proの5倍または20倍」、ヘルプは「Proの4倍または20倍」と揺れてるんですよ。だから数字は目安として見て、直前に公式を見るのが確実ですね。
あと使えるモデルも違って、PlusはGemini 4 Hydrogen、ProはGemini 4 Neon、UltraはGemini 4 Carbonです。
あと使えるモデルも違って、PlusはGemini 4 Hydrogen、ProはGemini 4 Neon、UltraはGemini 4 Carbonです。
テキトー教師DotAI 認定講師モデルが違えば体感も変わりますからね。料金表の金額だけ見てると、そこが抜け落ちるんですよ。
上限の残りは設定画面から確認する
- gemini.google.com にアクセスしてログインする
- 画面左下の「設定」アイコンを選ぶ
- 「使用量上限」アイコンを選ぶ
テキトー教師DotAI 認定講師手順はこれだけなんですが、最初に戸惑うのが「どこにあるのか分からない」なんですよね。左下の設定アイコンから入る、と覚えておくと早いです。
室谷代表取締役残量が少ない状態で重いプロンプトを投げると、途中で軽いモデルに切り替わって「あれ?」となる。作業前に一度見ておく、これが一番コスパのいい使い方ですね。
Proへ上げる前提なら、Google AI Proを安く使う方法も合わせて見ておくと判断が早いです。
Proへ上げる前提なら、Google AI Proを安く使う方法も合わせて見ておくと判断が早いです。
急に回答が軽く・遅く・質が落ちたと感じるのはなぜ?上限到達後の自動切り替え
上限に達すると、会話は「軽いモデル」で続く
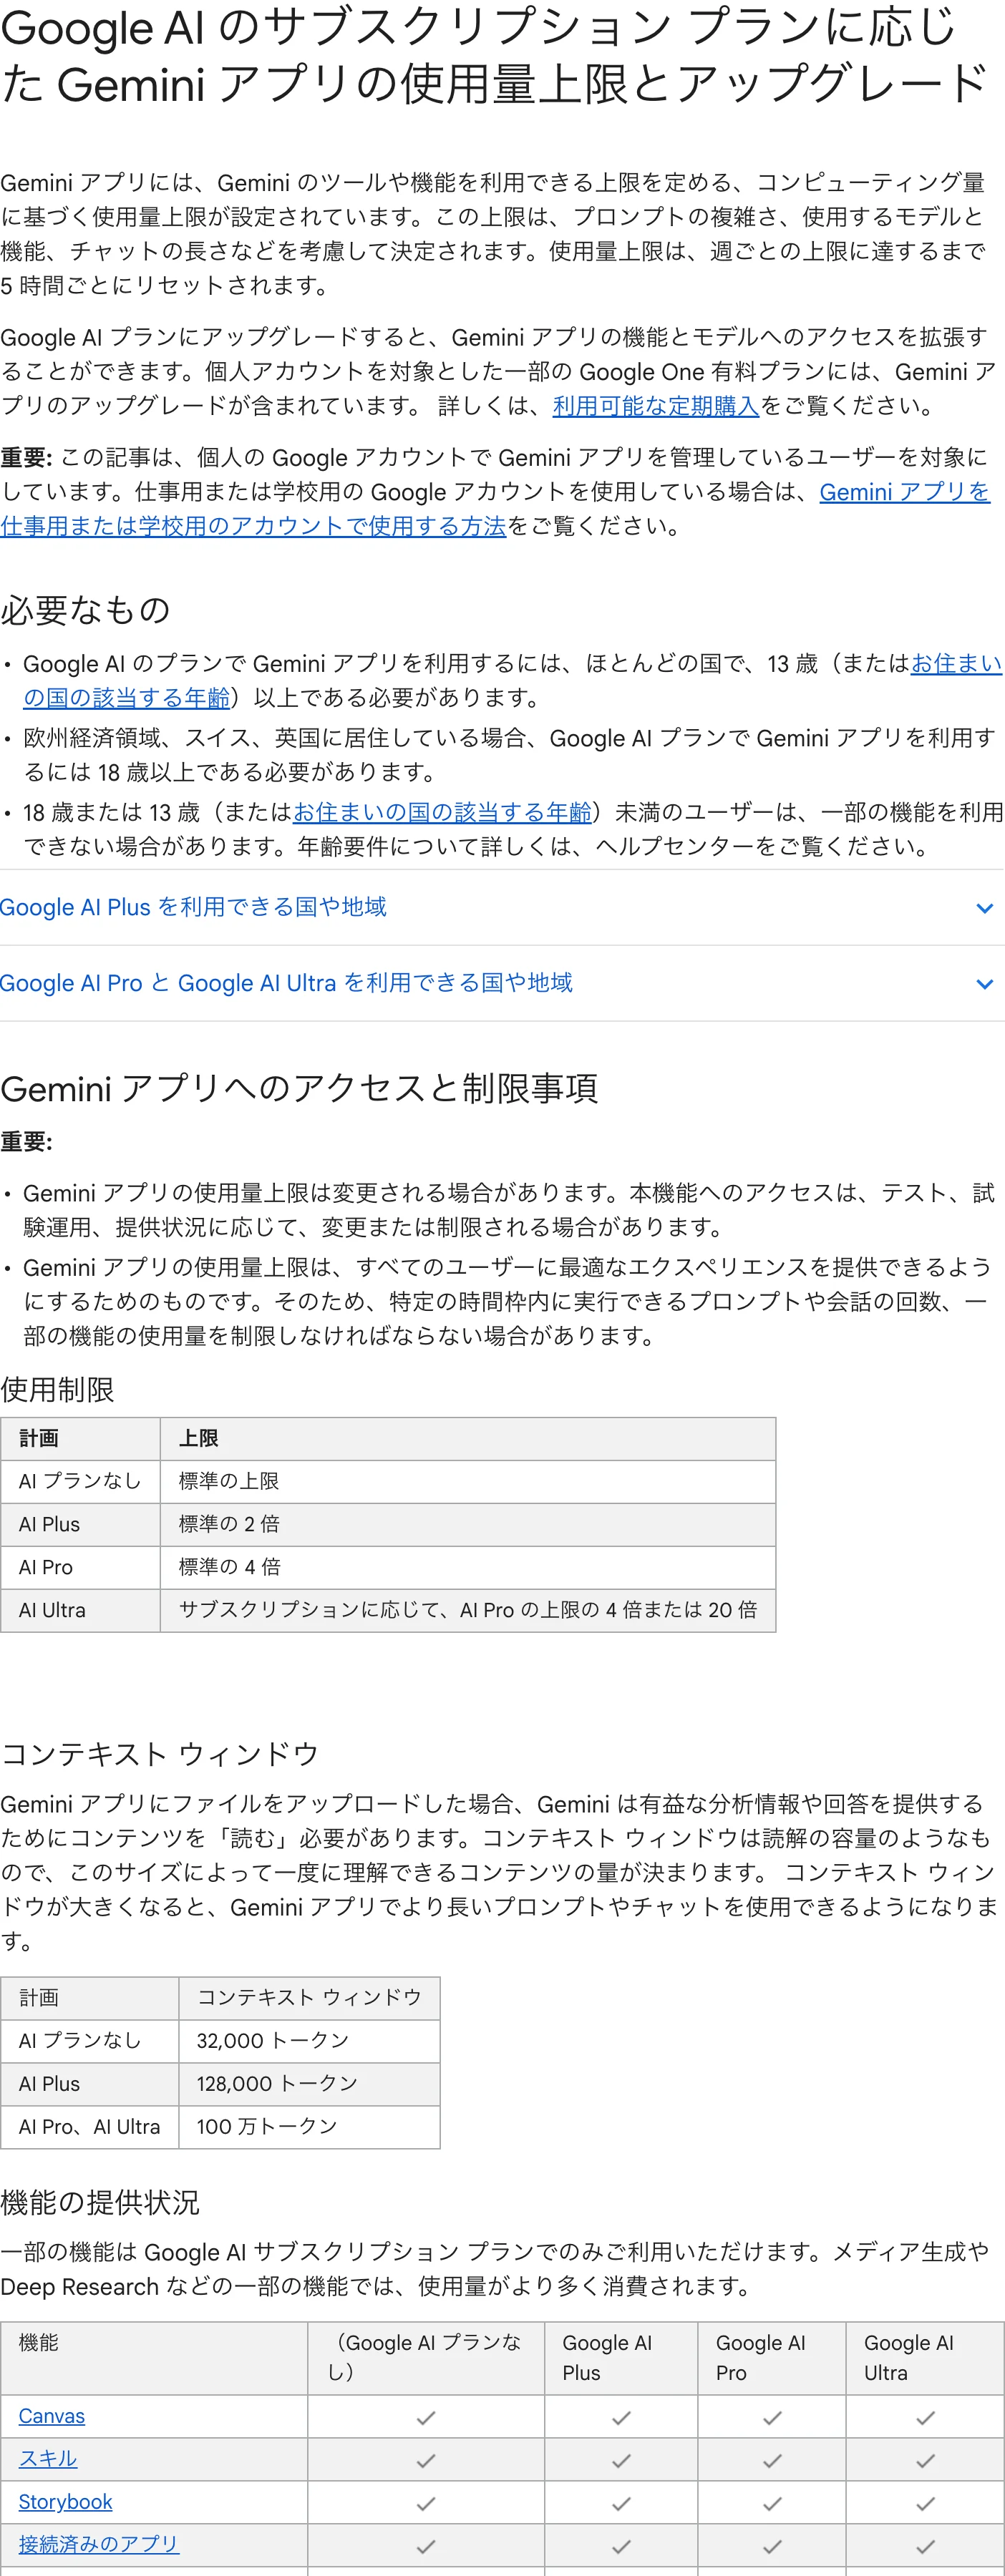
室谷代表取締役Geminiアプリの使用量上限って、回数じゃなくてコンピューティング量なんですよね。プロンプトの複雑さ、使うモデルと機能、チャットの長さで消費が変わる。
だから同じ1回でも、重い頼み方ほど減り方が早いんです。
だから同じ1回でも、重い頼み方ほど減り方が早いんです。
テキトー教師DotAI 認定講師現場でよく聞くのは「昨日と同じことを聞いたのに、急に答えが軽くなった」という感覚です。エラーで止まるわけじゃないので、自分では原因に気づきにくいんですよね。
室谷代表取締役そこは公式ヘルプに書いてあって、サブスクリプションを利用していて上限に達した場合は、Flash-Liteモデルで会話を続けられる、と。止まるんじゃなくて、応答を返すためのモデルが変わるわけです。
テキトー教師DotAI 認定講師なるほど。そこで「なんか薄いな」と感じる人が多い、と。
品質が落ちたというより、返す側が切り替わっている可能性があるんですね。
品質が落ちたというより、返す側が切り替わっている可能性があるんですね。
「劣化した」という声と、切り替えの見分け
室谷代表取締役実際、スピードが遅いし回答もおかしい、明らかに劣化している、という声はSNSでも見かけます。ただこれは利用者の実感であって、Googleが品質を落としたと説明しているわけではないんですよね。
テキトー教師DotAI 認定講師体感としてはすごく分かります。重いモデルと軽いモデルでは、返ってくる答えの厚みが違いますから。
「遅い」と「浅い」が同時に起きると、余計に原因が見えにくくなります。
「遅い」と「浅い」が同時に起きると、余計に原因が見えにくくなります。
室谷代表取締役だから切り分けの順番としては、設定を疑う前に使用量を見る。ここを飛ばすと、回線やPCの問題をずっと探し続けることになる。
限られた計算資源をどう配分するかという設計の話なので、上限が近づけば軽い方へ寄せるのは自然な挙動なんです。
限られた計算資源をどう配分するかという設計の話なので、上限が近づけば軽い方へ寄せるのは自然な挙動なんです。
テキトー教師DotAI 認定講師上限の確認方法と、ログインなしの制限
- gemini.google.com にアクセスする
- 左下の設定アイコンを選ぶ
- 使用量上限のアイコンを選ぶ
テキトー教師DotAI 認定講師確認はこの3ステップで終わります。まずここで「もう上限に近いのか」を見るだけで、原因の切り分けが一気に進みます。
室谷代表取締役上限は5時間ごとにリセットされて、週の上限に達するまでそれが続く仕組みなんですよね。だから時間帯を変えると戻ることもある。
テキトー教師DotAI 認定講師あと見落としやすいのが、Googleアカウントなしで使っている場合です。公式には、アカウントなしのユーザーの方が先に制限が適用される場合があると書かれています。
ログインしているかどうかで体感が変わるんですね。
ログインしているかどうかで体感が変わるんですね。
室谷代表取締役ログインしておく、プランを確認する。地味ですけど、そこが一番効く。
上限は予告なく変わる場合もあるとされているので、古い前提で判断しない方がいいですね。
上限は予告なく変わる場合もあるとされているので、古い前提で判断しない方がいいですね。
Gemini APIが遅いのはなぜ?開発者向けにthinkingConfigの挙動を解説
Thinking設定の比較
アプリのチャット画面と、API経由の呼び出しは別の論点
室谷代表取締役ここで一回分けておきたいんですけど、Geminiアプリの画面が遅いのと、API経由でモデルを呼んだときが遅いのは、原因がまったく別なんですよね。
テキトー教師DotAI 認定講師たしかに。現場でもごっちゃになってる人が多くて、「アプリが遅いんです」という相談にAPIの設定の話を返すと、余計に混乱させるんですよ。
室谷代表取締役アプリ側はサーバーの混雑とか回線の話で、API側はコードの設定の話。どっちの話をしてるのか決めないと、打ち手が全部ずれるんですよね。
テキトー教師DotAI 認定講師分けてもらえると助かります。開発者向けの話は、そこから先ですもんね。
Thinking Capabilityが既定で有効になっている
室谷代表取締役で、API側の遅さの主因がThinking Capability、つまりモデルが答える前に考える工程がデフォルトで入ってることなんですよ。
テキトー教師DotAI 認定講師初めて触る人がまず戸惑うのがそこで。「同じようなプロンプトなのに、別のモデルより明らかに遅い」となるんですよね。
室谷代表取締役開発者による実測だと、軽量なモデルをVercel AI SDK経由で呼んだときに、別ベンダーの小型モデルより3倍以上遅かったケースがあったそうです。スペックの差というより、考える工程が挟まってるかどうかなんですよね。
テキトー教師DotAI 認定講師なるほど、モデルの性能を疑う前に設定を見る、と。順番を間違えると遠回りになりますね。
実測7,643msと1,739ms、Thinkingを切る指定
指定はリクエストのthinkingConfigに、次の2つを明示するだけです。デフォルトに任せると切れないのがポイントです。
code
thinkingConfig: {
  thinkingBudget: 0,
  includeThinking: false,
}同じ実測記事に数字が出ていて、「県庁所在地を全てリストアップ」という質問で、Thinkingありが7,643ミリ秒、オフにすると1,739ミリ秒まで縮んだと。
テキトー教師DotAI 認定講師体感で言うと、数秒待たされるだけで「固まった?」と思うので、これはかなり効きますね。
室谷代表取締役書き方はSDKやライブラリで変わるので、そこは公式ドキュメントで確認するのが確実です。設定自体はこの2行に集約される、というのが面白いところなんですよね。
テキトー教師DotAI 認定講師明示しないと有効のまま、という仕様は覚えておきたいですね。
Thinkingを切ると、複雑な質問で網羅性が下がる場合がある
室谷代表取締役ただ、無条件に切ればいいってものでもなくて。同じ記事だと、オフにすると複雑な質問で回答の網羅性が落ちる場合があったと。
県庁所在地の例では、Thinkingありのときだけ全問正解だったそうです。
県庁所在地の例では、Thinkingありのときだけ全問正解だったそうです。
テキトー教師DotAI 認定講師現場感覚で言うと、雑談や要約はオフで十分、調査や分析はオンに戻す、みたいに用途で分けるのが現実的ですね。
室谷代表取締役遅いから全部オフ、だと品質で事故る。プロダクトのレスポンス速度は離脱に直結するので、速度と精度のどちらを優先するかを仕様として決める話なんですよね。
テキトー教師DotAI 認定講師そう考えると、設定をいじる前に、どの質問にどれだけ精度が要るかを決めるほうが早いですね。
それでも遅いときに試す順番と、公式にフィードバックを送る方法
軽いモデル→思考レベル→指示の細分化、の順で試す
室谷代表取締役ここまでで原因の見当はついてきたので、最後は実際に手を動かす順番を決めておきましょう。遅くなる理由はサーバーの混雑、使うモデル、思考レベル、指示の長さの4つに大体分かれるので、上から順に潰すのが早いんですよね。
テキトー教師DotAI 認定講師現場でも「あれもこれも同時に変えて、どれが効いたのか分からなくなった」という人が多いんですよ。なので順番を固定するのが大事で。
まずは軽いモデルに落とす。手順はこうです。
まずは軽いモデルに落とす。手順はこうです。
- ウェブなら gemini.google.com の上部メニューの設定アイコンからモデルを開き、Flash-Lite など軽いモデルを選ぶ
- モバイルアプリなら左側メニュー→プロフィール→設定から同じくモデルを選ぶ(手動切り替えにはログインが必要です)
- 思考レベルが「拡張」になっていれば「標準」に戻す(項目の位置は公式ヘルプで確認を)
- それでも待たされるなら、1回の指示を分けて投げる
室谷代表取締役軽いモデルに替えるだけで体感が変わるケースは確かに多いですよね。Flash-Lite 系がどういう位置づけなのかは、Gemini 4 Hydrogenとは?Google DeepMindが発表した高速実行特化モデルのあたりを読むと解像度が上がると思います。
テキトー教師DotAI 認定講師で、次が思考レベルと指示の長さなんですよ。多角的な分析や長文の要約を一度に頼むと、AIの思考プロセスが増えて処理時間が伸びます。
最初に戸惑うのがまさにここで、頼む内容を削るより「分けて頼む」方が効くんです。
最初に戸惑うのがまさにここで、頼む内容を削るより「分けて頼む」方が効くんです。
時間帯を変えても改善しないなら、公式の窓口に届ける
室谷代表取締役時間帯を変えても同じように遅い、となったら原因はもう別のところにあるわけです。うちの現場だとチャットの待ち時間だけでメンバーの手が止まるので、時給で換算すると普通にコストなんですよね。
だから切り分けが済んだら次は外に確認します。
だから切り分けが済んだら次は外に確認します。
テキトー教師DotAI 認定講師その確認先が2つあって。ひとつは Google Workspace ステータスダッシュボード(google.com/appsstatus/dashboard)で、ここで障害が出ていれば自分側の問題じゃないと判断できます。
もうひとつは X で、同じ時間帯に遅いという声が出ていないか見るのも目安になります。
もうひとつは X で、同じ時間帯に遅いという声が出ていないか見るのも目安になります。
室谷代表取締役なるほど、X は一次情報じゃないですけど、体感のズレを確かめるには手っ取り早いと。で、それでも何も出てこないときはどうするんですか。
テキトー教師DotAI 認定講師その場合はアプリ内のフィードバックから送るしかないですね。即時解決が保証されている窓口ではないので、送ったうえで普段の使い方を工夫しておく、という順番になります。
上限は予告なく変わるので、公式ヘルプを最後に確認する
室谷代表取締役あと見落としがちなのが、使用量上限のルール自体が動くことなんですよ。上限は予告なく変更される場合があるので、昔の記事の数字を信じて判断するとズレます。
テキトー教師DotAI 認定講師しかも Google アカウントなしで使っている人の方が先に制限がかかる場合もあるので、「昨日まで平気だったのに」が起きるんですよ。上限の確認は gemini.google.com の左下の設定アイコン→使用量上限アイコンから見られます。
室谷代表取締役じゃあ最後は公式ヘルプの最新情報を見る、で締めですね。数字が変わる前提で、疑う順番だけ体に入れておけば十分なんじゃないかと。
よくある質問
Q1. スマホアプリとPCのブラウザで、速さが違うことはある?
テキトー教師DotAI 認定講師現場でよく聞くのが「アプリよりブラウザのほうが速く感じる」という声です。端末の性能や裏で動いているアプリの状態でも体感は変わるので、条件を揃えないと判断を誤ります。
室谷代表取締役そうなんですよね。移動中にスマホで触って「遅いな」と思ったら、ただ電波が弱かっただけ、みたいなことが何度もあって・・・比べるときは同じ回線・同じ質問で、が基本ですね。
Q2. 画像や長いファイルを添付すると遅くなる?
室谷代表取締役長い資料を丸ごと投げると、明らかに待たされる時間が伸びるんですよ。読む量が増えているんだから当たり前なんですけど、体感では「急に遅くなった」に見える。
テキトー教師DotAI 認定講師たしかに。最初に戸惑うのがそこなんですよ。
貼り付ける量を分けるだけで印象はかなり変わるので、要約してから渡す、章ごとに切る、みたいな工夫で十分だったりします。
貼り付ける量を分けるだけで印象はかなり変わるので、要約してから渡す、章ごとに切る、みたいな工夫で十分だったりします。
Q3. ChatGPTなど他のAIと比べて遅いと感じるのは気のせい?
テキトー教師DotAI 認定講師他社と比べて「Geminiは遅い」と言われることはありますが、何を聞いたかで全然違うんですよ。長い推論を投げているのか、一言の雑談なのかで意味が変わります。
室谷代表取締役比較って条件を揃えないと意味がないんですよね。同じプロンプトを何回か投げて真ん中の値を見る、くらいでちょうどいい。
そこまでやれば「気のせい」かどうかは大体わかります。
そこまでやれば「気のせい」かどうかは大体わかります。
Q4. 回答が途中で止まるのは、遅さと同じ話?
室谷代表取締役途中で止まるのは、遅さとは別の話のことが多いんですよね。出力が長すぎた、内容が引っかかった、みたいな要因が絡みます。
テキトー教師DotAI 認定講師待ち時間が長いのと返ってこないのは分けて考えたほうがよくて、まず「返ってきているか」を見る。そこで止まっているなら、質問を分割して試すのが早いですね。
Q5. アプリを更新したら急に重くなった、ということはある?
テキトー教師DotAI 認定講師更新の直後に「急に重い」と感じる人はいます。ただ原因が端末側なのか提供側なのかは外からは分からないので、再起動や再ログインで戻るかを見るくらいが現実的です。
室谷代表取締役そういうとき、いきなり設定をあちこち触らないほうがいいんですよね。まず再起動して同じ質問で比べる。
それで戻らないなら環境じゃなくて中の話、と切り分けられます。
それで戻らないなら環境じゃなくて中の話、と切り分けられます。
まとめ
室谷代表取締役遅い原因って、ざっくり「回線や端末」「モデルと思考の量」「混雑と利用枠」に分かれるんですよね。闇雲に設定をいじるより、どこに当たるかを先に切り分けたほうが早い。
テキトー教師DotAI 認定講師たしかに。最初に戸惑う人が多いのは、全部同じ「遅い」に見えてしまうことなんですよ。
切り分けさえできれば、あとはやることが決まってきます。
切り分けさえできれば、あとはやることが決まってきます。
室谷代表取締役待ち時間を時給で換算すると、たぶん思っているより高いんですよね。だから「遅いな」で済ませず、原因を一度特定しておく価値はあると思います。
テキトー教師DotAI 認定講師まずは同じ質問で条件を変えて比べるところからですね。それでも変わらなければ公式にフィードバックを送る。
順番を決めておくと迷わないです。
順番を決めておくと迷わないです。