Qwen-Image-2.1-Turbo(クウェン・イメージ・ツー・ポイントワン・ターボ)は、AlibabaのQwenチームが2026年10月9日に公開した画像生成・編集モデルで、わずか8デノイジングステップで2K画像の生成と自然言語による画像編集ができます。重みはHugging Faceで公開され(研究・評価目的のみ無償、商用は別途ライセンスが必要)、APIはAlibaba CloudのModel Studioで1枚0.016ドル(約2.5円、シンガポールの国際版)、日本(東京)などのリージョンでは1枚0.014133ドル(約2.2円)です(1ドル=156.8円で換算、2026年10月25日時点)。編集部が同じプロンプトで生成したところ、上位版Proの5.5〜7割の時間(1枚22〜33秒)で、日本語の文字も崩れずに描けました。
 室谷代表取締役
Qwenチームが「Qwen-Image-2.1-Turbo」を公開ウェイトとしてリリースしました。ベースは9月20日にオープンソース化されたQwen-Image-2.1で、その高速版チェックポイントという位置づけなんですよね。
あわせてProとTurboのホスト型APIも正式に提供開始になっています。
あわせてProとTurboのホスト型APIも正式に提供開始になっています。
 テキトー教師DotAI 認定講師
これは単に「速くなった版が出た」という話じゃないんですよ。同じ7Bの視覚生成アーキテクチャを使いながら、推論のステップ数をぐっと減らして実用速度に持ってきた、という設計の話なんです。
講座でも「拡散モデルはステップ数との戦い」とよく話すんですが、まさにその最前線です。
講座でも「拡散モデルはステップ数との戦い」とよく話すんですが、まさにその最前線です。
室谷代表取締役今回は発表内容の整理に加えて、編集部で実際にTurbo・Pro・FLUX 3 Image Kleinに同じプロンプトを投げて、速度と費用と出来を比べてきました。生成した画像もそのまま載せます。
Qwen-Image-2.1-Turboとは?何が8ステップで変わるのか
まとめ
Qwen-Image-2.1-Turbo の要点
- ベースは Qwen-Image-2.1(7Bの視覚生成アーキテクチャ)
- 生成は8デノイジングステップに圧縮した加速チェックポイント
- ステップを減らしても品質は落ちないよう調整(Fewer steps does not mean lower quality)
- テキストから強い2K画像を生成できる
- デフォルト設定は CFG=1
- 高速化の仕組みはプレフィックスKVキャッシュでテキスト・参照画像のコンテキストを各ステップ間で再利用
- 推奨8ステップのスケジュールがチェックポイントに保存され自動適用
- num_inference_steps を設定しただけでは保存済みスケジュールを上書きしない
- まずはデフォルトのまま回すのが安全
室谷代表取締役まず前提として、拡散モデルはノイズから少しずつ画像を彫刻するように生成する方式で、この繰り返し回数がステップ数です。一般にステップが多いほど高品質だけど遅い。
Turboはそこを8ステップに圧縮した加速チェックポイントなんですよね。
Turboはそこを8ステップに圧縮した加速チェックポイントなんですよね。
テキトー教師DotAI 認定講師ここで大事なのは、ステップを減らしても品質が落ちないように調整されている点です。公式の説明でも「Fewer steps does not mean lower quality」、つまりステップが少ないからといって低品質ではない、と明言されています。
テキストから強い2K画像を生成できると。
テキストから強い2K画像を生成できると。
室谷代表取締役Hugging Faceのモデルカードによると、チェックポイントには推奨の8ステップのサンプリングスケジュールが保存されていて、手動でスケジューラを設定しなくてもそのまま使えるようになっています。生成はデフォルトでCFG=1、そしてプレフィックスKVキャッシュでテキストと参照画像のコンテキストをデノイジングの各ステップ間で再利用する、と。
テキトー教師DotAI 認定講師整理するとこうです。
- ベース: Qwen-Image-2.1(7Bの視覚生成アーキテクチャ)
- 生成ステップ: 8デノイジングステップ
- デフォルト設定: CFG=1
- 高速化の仕組み: プレフィックスKVキャッシュでテキスト・参照画像のコンテキストを再利用
- スケジューラ: 推奨8ステップのスケジュールがチェックポイントに保存され自動適用
室谷代表取締役ここ、運用でハマりやすいポイントがあって。モデルカードには「num_inference_stepsを設定しただけでは保存済みスケジュールを上書きしない」と書かれているんですよ。
実験で明示的にsigmas引数を呼び出し時に渡せば上書きできるけど、それ以外のスケジュールはこのチェックポイントでは評価されていない、と。
実験で明示的にsigmas引数を呼び出し時に渡せば上書きできるけど、それ以外のスケジュールはこのチェックポイントでは評価されていない、と。
テキトー教師DotAI 認定講師つまり「いつもの感覚でステップ数をいじる」と意図した挙動にならない可能性がある、ということですね。受講生さんもここで混乱しがちなので、まずはデフォルトのまま回すのが安全です。
Qwen-Image-2.1-Turboでできること — 2K画像生成と自然言語での画像編集
Qwen-Image-2.1-Turboでできること
テキストからの画像生成
プロンプトから画像を生成。公式スレッドでは継続的な編集にも対応
自然言語による画像編集
「アクセサリーを足す」「シーンを変える」などの編集指示に対応
生成と編集を1モデルに統合
ベースのQwen-Image-2.1がテキスト生成と画像編集を統合
ネイティブな透過画像(RGBA)生成・編集
プロンプトで通常画像か透過画像かを決めて出力。透過レイヤー内のテキスト編集や被写体のRGBA抽出も可能
最大10枚の参照画像を使った編集
集合写真の合成、バーチャル試着、家具画像からの部屋レイアウト生成など
ローカル編集・忠実な保持
円やペイント注釈、別途マスクで編集範囲を指定。人物や商品を忠実に保持
タイポグラフィ・ポートレート品質
タイポグラフィやポートレートのライティング、細部の質感向上
室谷代表取締役できることの中心は2つで、テキストからの画像生成と、自然言語による画像編集です。公式スレッドでは「アクセサリーを足す」「シーンを変える」といった継続的な編集に対応すると説明されています。
テキトー教師DotAI 認定講師ベースのQwen-Image-2.1の特徴も押さえておきたいです。Qwen-Image-2.1のブログによると、テキストからの画像生成と画像編集を1つのモデルに統合していて、ネイティブで透過画像(RGBA)の生成・編集ができる。
最大10枚の参照画像を使った編集、ローカル編集、人物や商品の忠実な保持、そしてタイポグラフィやポートレートのライティング、細部の質感向上が挙げられています。
最大10枚の参照画像を使った編集、ローカル編集、人物や商品の忠実な保持、そしてタイポグラフィやポートレートのライティング、細部の質感向上が挙げられています。
室谷代表取締役透過まわりは実務で効いてきますよね。プロンプトで通常画像か透過画像かを決めて出力できる。
透過レイヤー内のテキスト編集、たとえば「BLOOM」を「Qwen-Image」に置き換える、なんて例もブログで示されています。実写写真から被写体をRGBAレイヤーとして抽出して、後続のデザインやコンポジションに再利用する、という使い方もできます。
透過レイヤー内のテキスト編集、たとえば「BLOOM」を「Qwen-Image」に置き換える、なんて例もブログで示されています。実写写真から被写体をRGBAレイヤーとして抽出して、後続のデザインやコンポジションに再利用する、という使い方もできます。
テキトー教師DotAI 認定講師編集のバリエーションも具体的です。円やペイント注釈、別途マスクで編集範囲を指定できる。
ブログの例だと、青い円の金属ウォッチを消して、赤い円の髪を黒に変えて、緑の円の領域をグレーの半袖リネンパジャマに置き換える、という3箇所同時の指示を1回で処理しています。
ブログの例だと、青い円の金属ウォッチを消して、赤い円の髪を黒に変えて、緑の円の領域をグレーの半袖リネンパジャマに置き換える、という3箇所同時の指示を1回で処理しています。
室谷代表取締役参照画像を最大10枚まで使えるのも大きい。集合写真の合成、モデル・服・靴・バッグ・帽子を組み合わせたバーチャル試着、家具の画像から部屋のレイアウトを生成する、といった例がブログで紹介されています。
MYUUUでも商品画像まわりは毎回試行錯誤するので、この参照枚数の多さは素直にありがたいです。
MYUUUでも商品画像まわりは毎回試行錯誤するので、この参照枚数の多さは素直にありがたいです。
テキトー教師DotAI 認定講師モデルカードのTurboショーケースでも、ポートレート写真、人物のポーズと動き、透過画像生成、タイポグラフィとポスターデザイン、UIと情報レイアウト、単一画像の変換、マルチ参照のコンポジション、4画像のインテリア合成、といったカテゴリの8ステップ出力例が並んでいます。
室谷代表取締役編集の例も出ていますね。スケッチからフォトリアルなモーターヨットを生成する例がモデルカードに載っていて、入力スケッチの構造を保ちながら写真のように仕上げています。
編集部で試した結果——Claude Codeで生成させ、Pro・FLUX 3 Image Kleinとも比べた
室谷代表取締役数字の前に、実際に生成させた作業画面から見てもらいます。Qwen-Image-2.1-Turboは画像のモデルなので、Claude Codeの頭脳にはできません。
そこでClaude CodeにOpenRouterの画像APIを呼ばせて、FLUX 3 Image Kleinとの比較ページを作らせました。
そこでClaude CodeにOpenRouterの画像APIを呼ばせて、FLUX 3 Image Kleinとの比較ページを作らせました。
テキトー教師DotAI 認定講師試した環境はこうです。
- 日時: 2026年10月25日の午後(日本時間)
- ツール: Claude Code 2.1.310(ターミナル版)。Claude Code自体のモデルはClaude Haiku 5.5(OpenRouter経由)
- 画像の生成: OpenRouterの画像API。モデルは
qwen/qwen-image-2.1-turboとblack-forest-labs/flux-3-image-klein - 作業フォルダ: 画像APIの呼び方(エンドポイント・モデルID・応答の形)を書いたメモだけを置いた。APIの鍵は環境変数で渡した
室谷代表取締役入力したプロンプトはこれです。生成のプロンプトは、後半の数字と同じ黒板メニューです。
code
OpenRouter の画像API(https://openrouter.ai/api/v1/images、鍵は環境変数 OPENROUTER_API_KEY)で、次のプロンプトを Qwen-Image-2.1-Turbo と FLUX 3 Image Klein で1枚ずつ生成して、かかった秒数と費用を並べた比較ページ compare.html を作って。プロンプト:カフェの店先に置かれた黒板メニューの写真。黒板には白いチョークの手書き文字で、上から「本日のおすすめ」「抹茶ラテ 480円」と日本語で書かれている。自然光、写真風。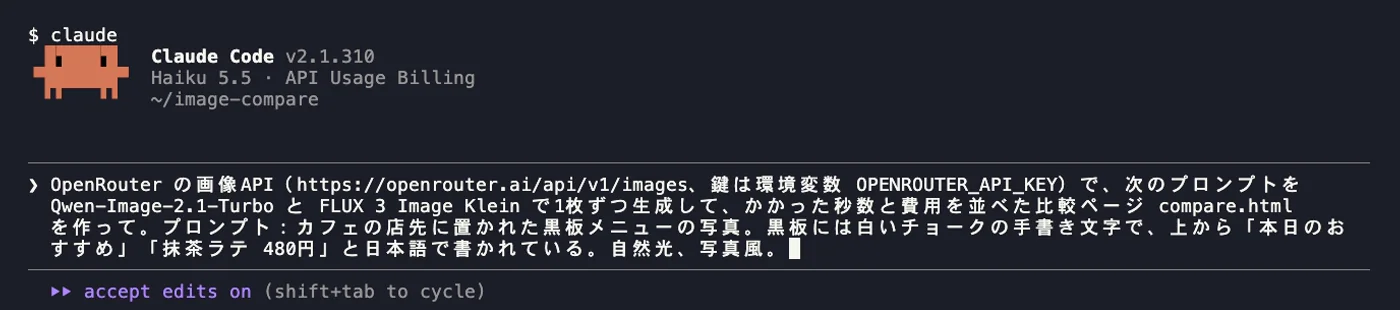
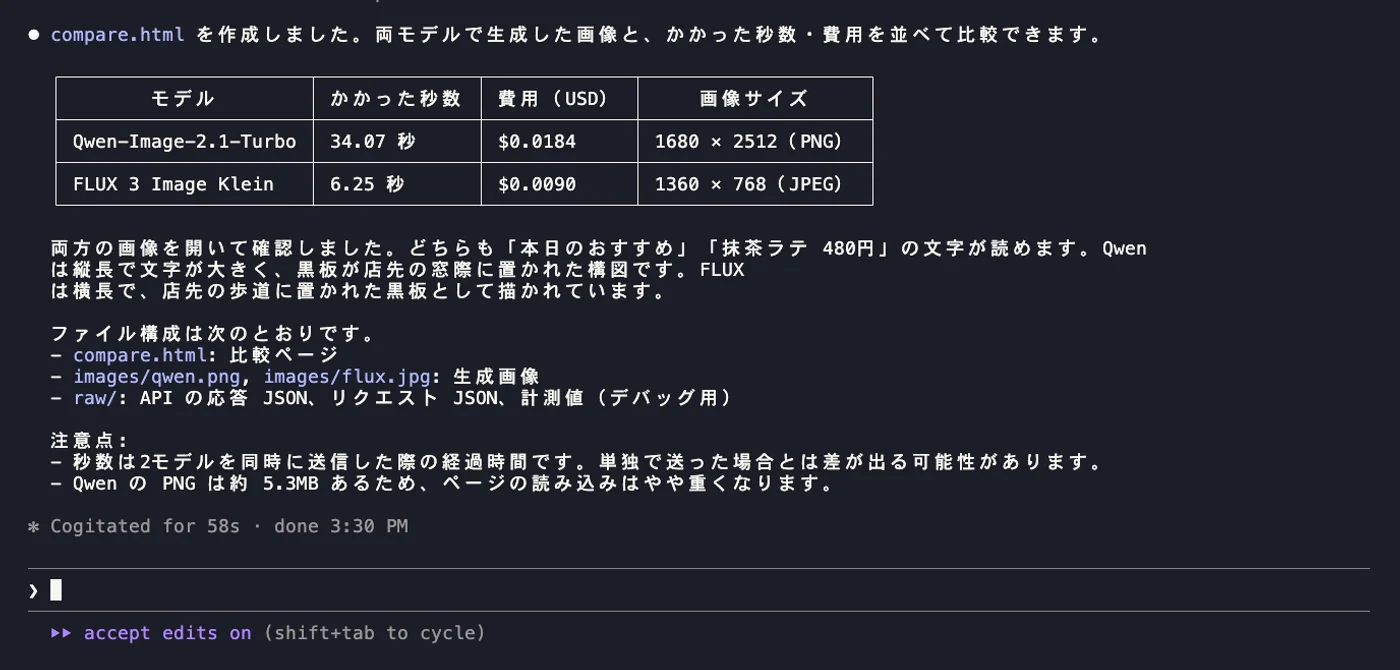
テキトー教師DotAI 認定講師作業中の画面です。鍵が設定されているかを確かめてから、2つのモデルに同時にリクエストを送って、画像が返ってくるのを待っています。
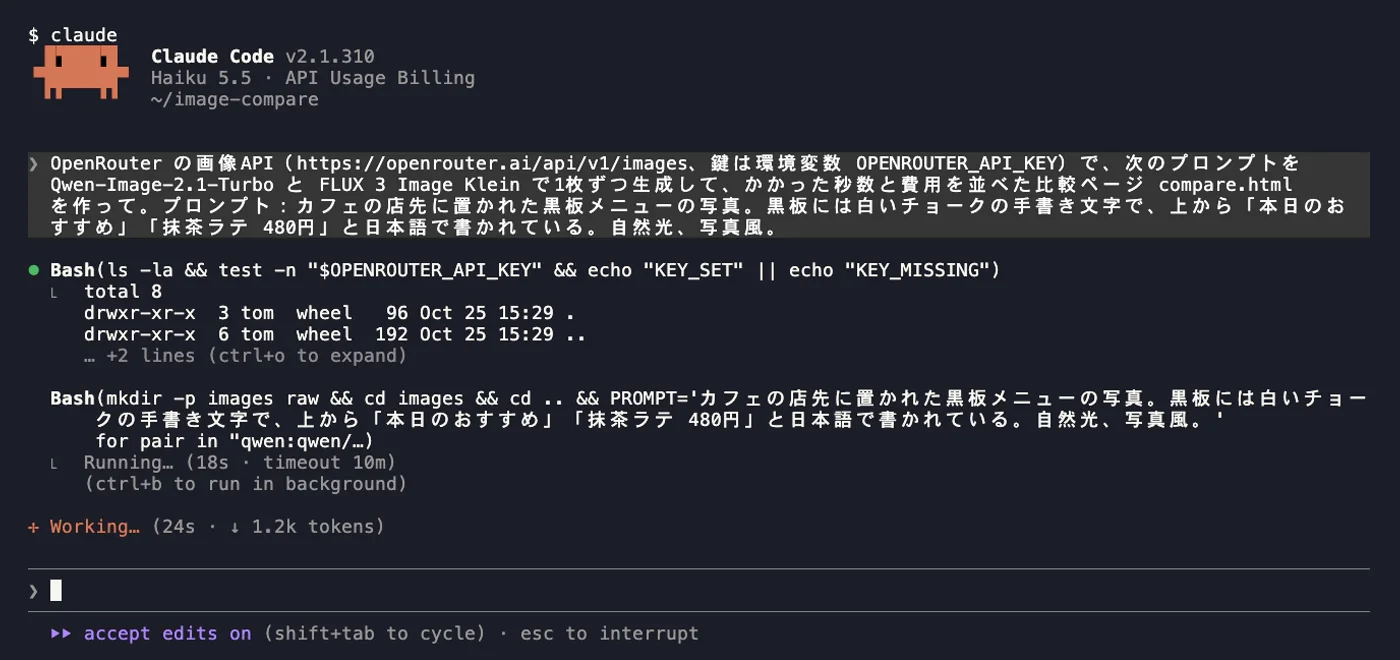
室谷代表取締役58秒で完了しました。Claude Codeは生成した2枚を自分で開いて、文字が読めるかを確かめてから報告しています。
テキトー教師DotAI 認定講師できた比較ページがこちらです。
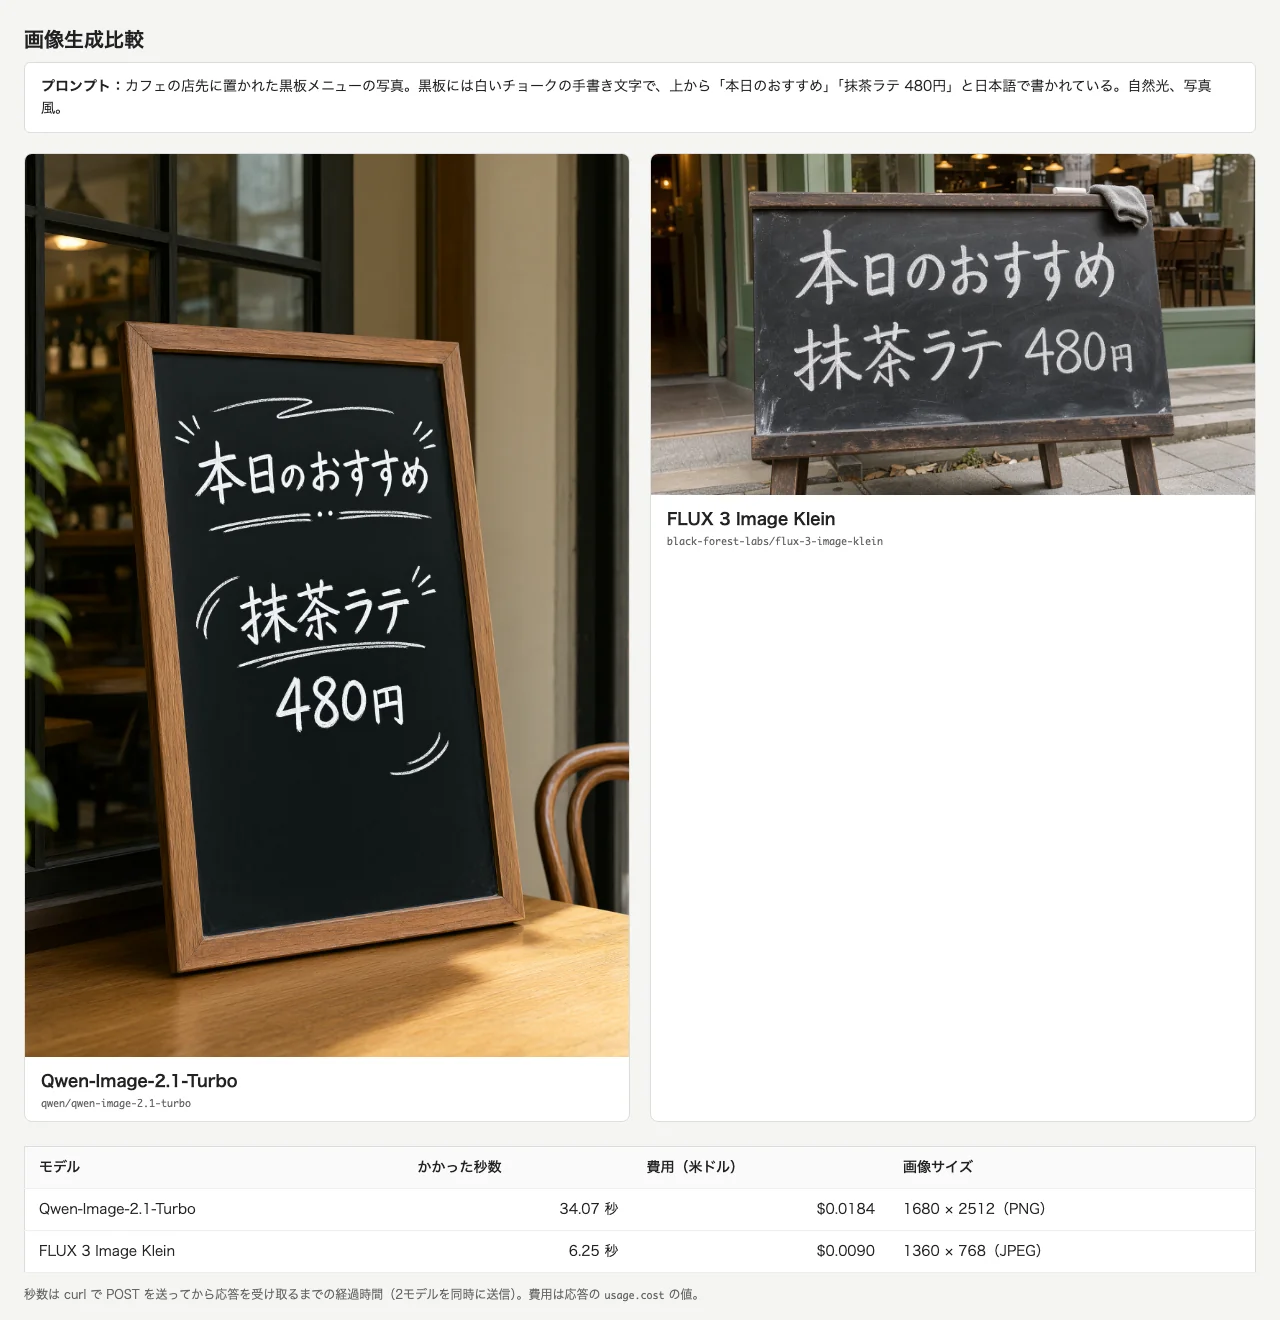
室谷代表取締役違いを整理するとこうです。
- 時間: Qwen-Image-2.1-Turboが34.07秒、FLUX 3 Image Kleinが6.25秒(2つを同時に送ったときの、送信から受信までの時間)
- 費用: Turboが0.0184ドル(約2.9円)、Kleinが0.009ドル(約1.4円)
- 画像: Turboは1680×2512の縦長で、窓際の黒板に飾り線つきの大きな文字。Kleinは1360×768の横長で、店先の歩道に置いた黒板
- 日本語の文字: どちらも「本日のおすすめ」「抹茶ラテ 480円」を崩さずに描いた
テキトー教師DotAI 認定講師これも1回の実行例です。撮影のやり直しを含めて同じ指示を3回出したところ、Turboは27〜34秒、Kleinは6〜8秒で、費用は3回とも同じ(0.0184ドルと0.009ドル)でした。
解像度を指定していないので、出てくる画像の大きさも回によって変わります。
解像度を指定していないので、出てくる画像の大きさも回によって変わります。
室谷代表取締役ここからは補足として、Claude Codeを通さずAPIを直接呼んで、3つのプロンプトを3回ずつ生成した結果です。
テキトー教師DotAI 認定講師条件を整理するとこうです。
- 実施日: 2026年10月25日(日本時間)。OpenRouterの画像生成APIで、解像度などは指定せずプロンプトだけを渡した
- 比べたモデル: Qwen-Image-2.1-Turbo、上位版のQwen-Image-2.1-Pro、Black Forest LabsのFLUX 3 Image Klein
- プロンプト1: カフェの黒板メニュー。「本日のおすすめ」「抹茶ラテ 480円」と日本語で書かせる
- プロンプト2: 木のテーブルの白いマグカップの商品写真
- プロンプト3: 「Monthly Budget」の見出しと1〜6月の棒グラフがある家計簿アプリの画面
- 各プロンプト3回ずつ、計27枚。時間は中央値、費用はOpenRouterが返した実費。円換算は1ドル=156.8円(欧州中央銀行の参照レート、2026年10月23日)
室谷代表取締役まず数字から。
| 項目 | Qwen-Image-2.1-Turbo | Qwen-Image-2.1-Pro | FLUX 3 Image Klein |
|---|---|---|---|
| 1枚の生成時間(黒板) | 22.6秒 | 41.2秒 | 5.6秒 |
| 1枚の生成時間(マグカップ) | 22.2秒 | 40.0秒 | 5.6秒 |
| 1枚の生成時間(アプリ画面) | 33.1秒 | 47.6秒 | 7.0秒 |
| 出力の解像度(初回) | 2048×2048ほか | 2048×2048ほか | 1360×768ほか |
| 1枚の費用(実費) | 0.0184ドル(約2.9円) | 0.046ドル(約7.2円) | 0.009ドル(約1.4円) |
| 日本語の文字(3枚中、目視) | 3枚とも正しい | 3枚とも正しい | 3枚とも正しい |
※時間はリクエストから画像を受け取るまでの中央値(通信を含む)。解像度は指定していないため、モデルごとに自動で選ばれた。
テキトー教師DotAI 認定講師TurboはProの5.5〜7割の時間で、費用は約4割です。一番速くて安いのはKleinですが、出力が約100万画素で、Qwenの2モデル(約400万画素)より小さいので、単純な比較はできません。
室谷代表取締役一番知りたかったのは、日本語の文字なんですよ。公式の資料には日本語の文字が描けるかの記載がないので、黒板メニューで試しました。
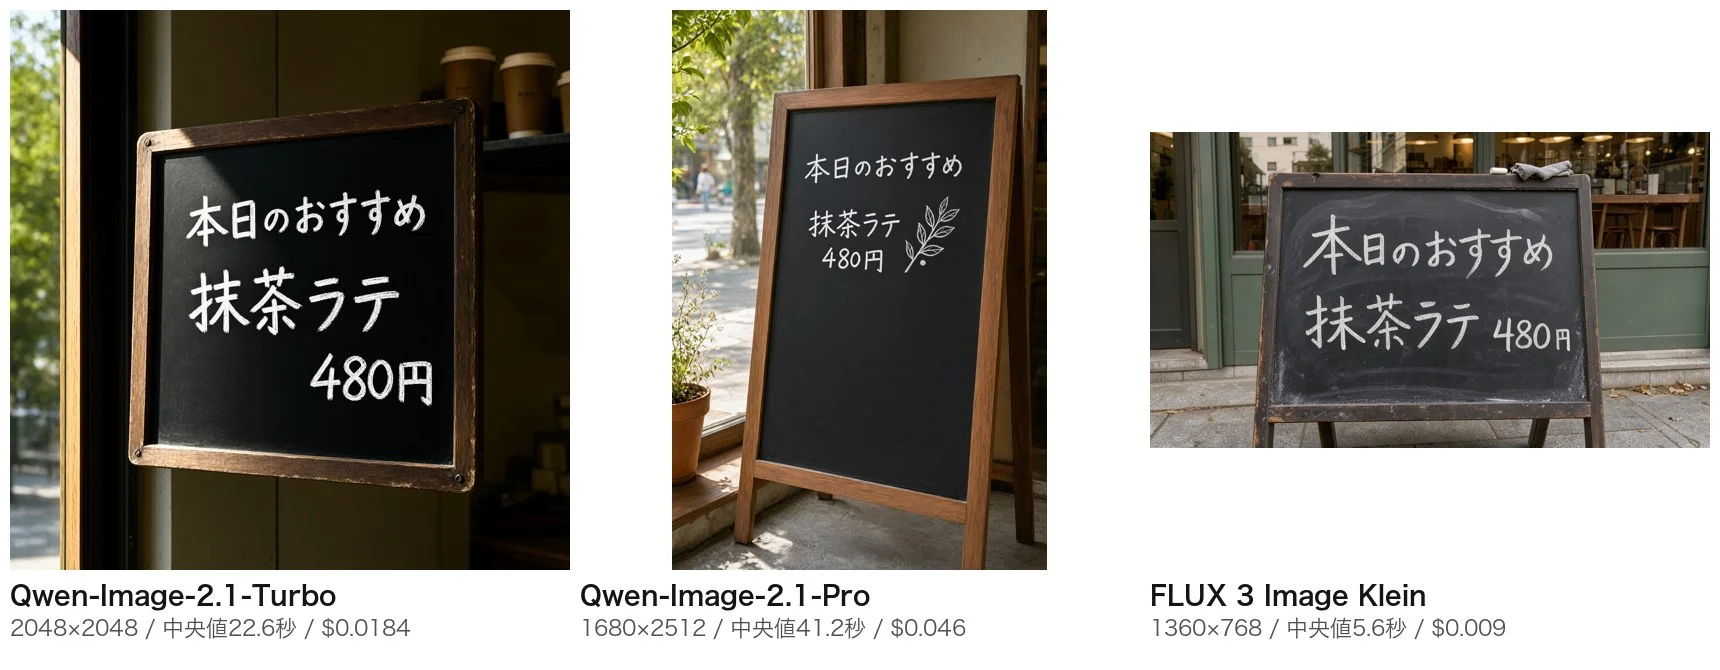
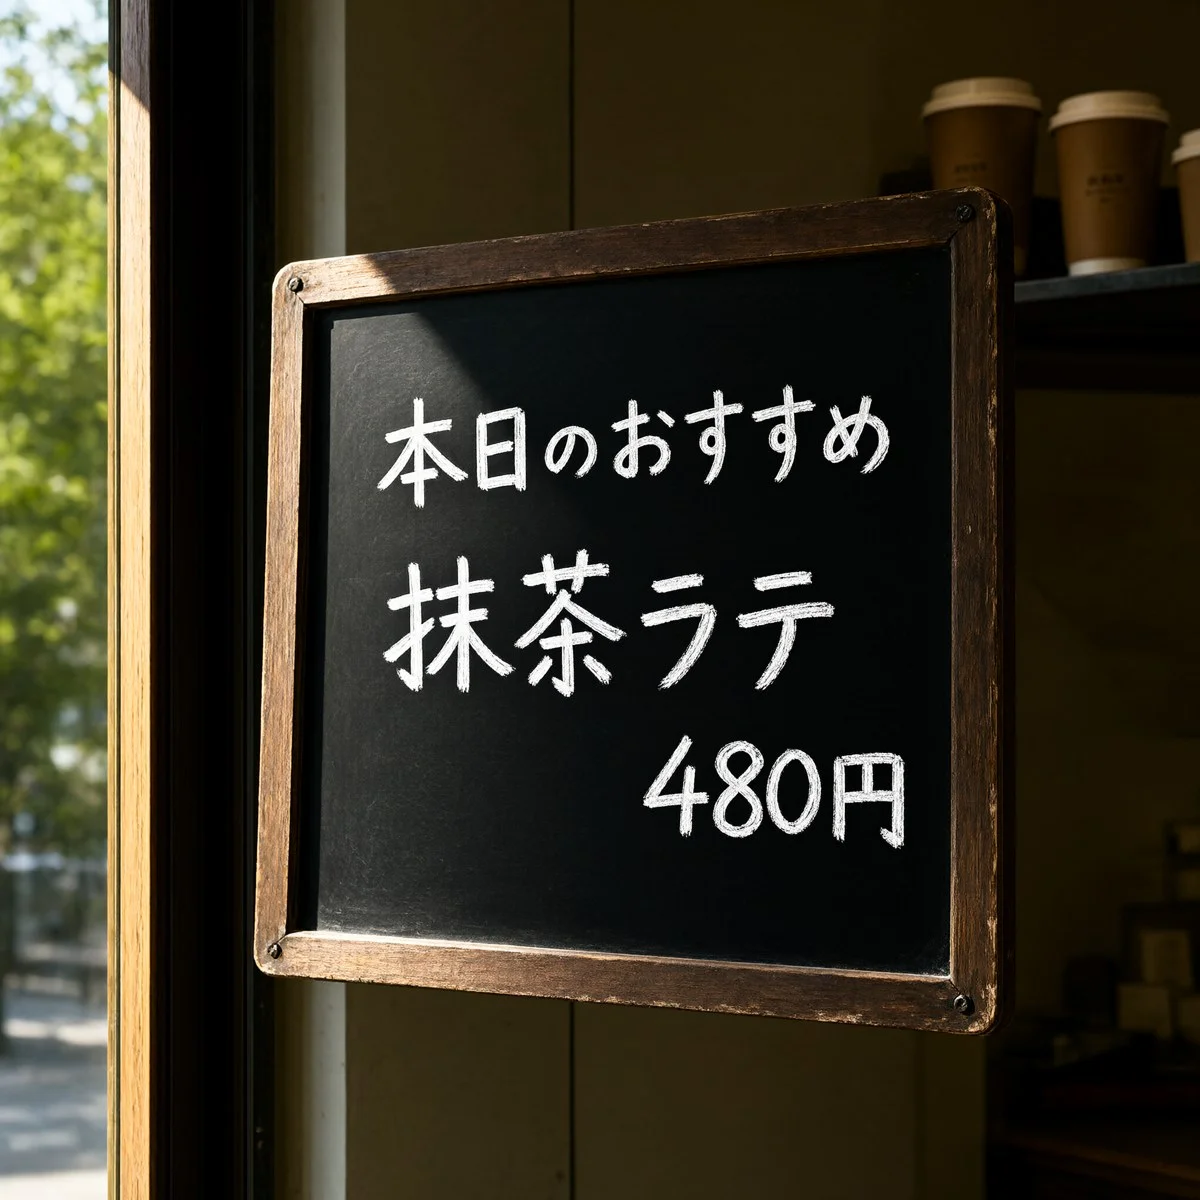
テキトー教師DotAI 認定講師3モデルとも「本日のおすすめ」「抹茶ラテ」「480円」を、3回すべて崩れずに描けました。Turboの1枚目を大きく載せておきます。
チョークの質感と手書き風の文字がそのまま出ています。
チョークの質感と手書き風の文字がそのまま出ています。
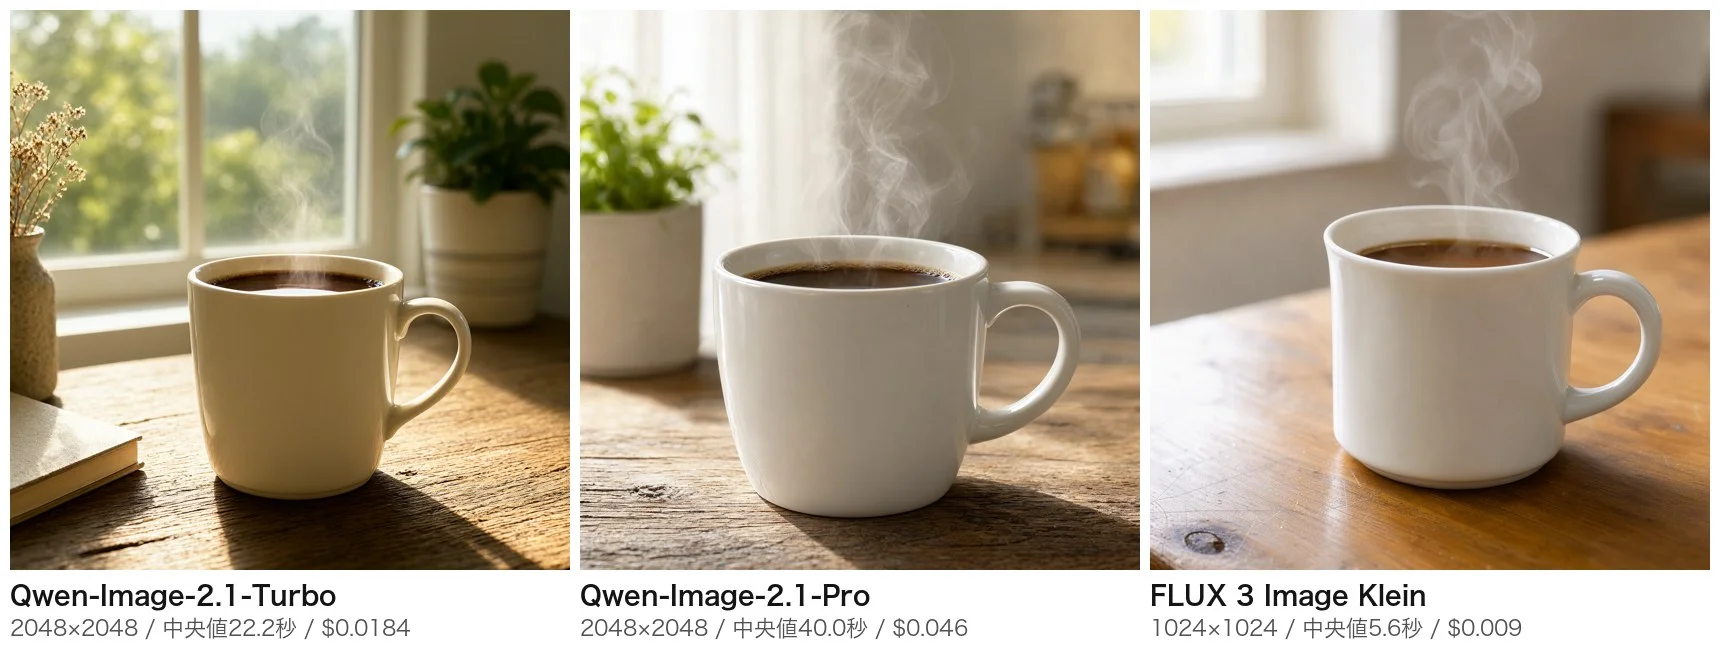
室谷代表取締役商品写真はこちら。3モデルとも指示どおりの写真になりました。
Kleinは3回ともほぼ同じ構図で、Qwenの2モデルは回ごとに構図や小物が変わります。
Kleinは3回ともほぼ同じ構図で、Qwenの2モデルは回ごとに構図や小物が変わります。
テキトー教師DotAI 認定講師差が出たのはアプリ画面です。
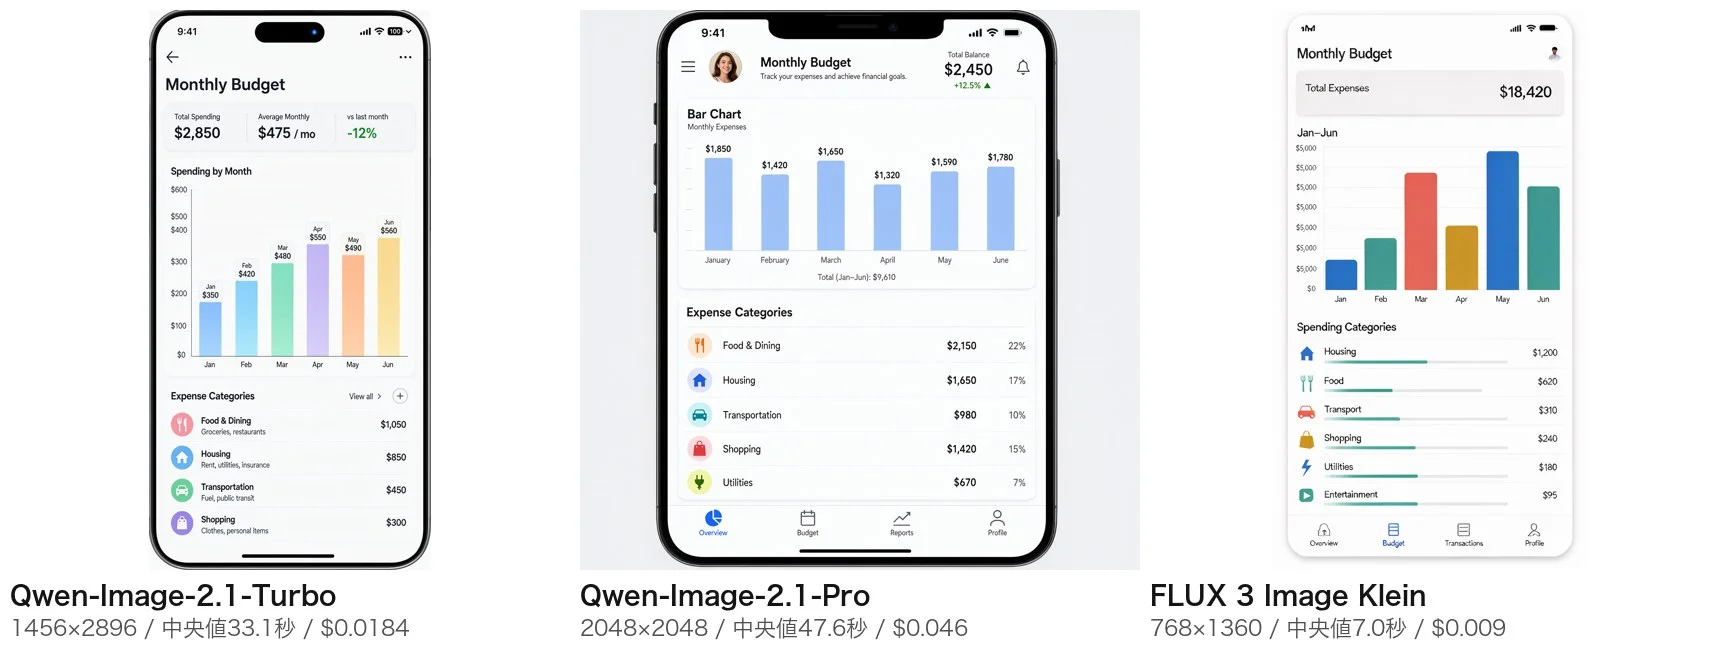
室谷代表取締役見出しの「Monthly Budget」は全モデル正しく描けました。ただ、グラフの数字に弱点があって、Kleinは3回とも縦軸の目盛りが全部「$5,000」になっていました。
Turboも1回目は目盛りの間隔が不ぞろいで、棒の高さと書かれた金額が合っていない回が3モデルともありました。
Turboも1回目は目盛りの間隔が不ぞろいで、棒の高さと書かれた金額が合っていない回が3モデルともありました。
テキトー教師DotAI 認定講師グラフや表の数字を画像生成に任せるのは、まだ危ない、ということですね。数字が大事な図は、元データから描いて、画像生成は飾りに使うのが安全です。
室谷代表取締役費用についても補足すると、OpenRouter経由の実費は、Alibaba Cloud公式の単価(Turbo 0.016ドル、Pro 0.04ドル)より15%高くなりました。大量に作るなら、公式のModel Studioで直接契約したほうが安く済みます。
編集部の生成で分かったこと
TurboはProの5.5〜7割の時間(1枚22〜33秒)・約4割の費用で、日本語の黒板メニューも3回とも崩れずに描けた。グラフの目盛りや棒の高さは3モデルとも不正確な回があり、数字が大事な図には向かない。
テキトー教師DotAI 認定講師注意点も書いておきます。各プロンプト3回の小さな試行で、出来の良し悪しは編集部の目視です。
解像度をそろえていないので、細部の比較もしていません。ローカルで動かした場合の速度やVRAMは測っていません。
解像度をそろえていないので、細部の比較もしていません。ローカルで動かした場合の速度やVRAMは測っていません。
Qwen-Image-2.1-Turboの使い方・始め方 — Diffusersでの読み込みと推論設定
DiffusersでQwen-Image-2.1-Turboを動かす手順
- 01PyTorch(CUDA対応)をインストールCUDA対応のPyTorchを入れる
- 02Diffusersソースと依存関係をインストールpip install git+https://github.com/huggingface/diffusers.git / pip install "transformers>=5.17.0" accelerate pillow
- 03最新Diffusersを使うサンプリングsigmas対応が必要(PR #14950で追加)。古いDiffusersだと動かない可能性がある
- 04QwenImage21Pipelineで読み込むQwenImage21Pipeline.from_pretrainedで「Qwen/Qwen-Image-2.1-Turbo」を指定し、dtype=torch.bfloat16でcudaに載せる
- 05テキストto画像を実行width 1696・height 2528の縦長、use_kv_cache=True、generatorにシードを渡す
- 06画像編集を実行入力画像をRGBAで読み込み、width/heightを2048にして同じパイプラインにimageとして渡す
室谷代表取締役使い方はDiffusers経由が基本です。モデルカードのクイックスタートでは、CUDA対応のPyTorchを入れたうえで、最新のDiffusersソースと依存関係をインストールする手順が示されています。
テキトー教師DotAI 認定講師整理するとこうです。
code
pip install git+https://github.com/huggingface/diffusers.git
pip install "transformers>=5.17.0" accelerate pillow注意点として、このチェックポイントはパイプライン設定のサンプリングsigmasに対応したDiffusersが必要で、それはPR #14950で追加されたものだと明記されています。古いDiffusersだと動かない可能性があるので、そこは素直に最新を入れるのが吉です。
テキトー教師DotAI 認定講師読み込みは、モデルカードの例どおり
QwenImage21Pipeline.from_pretrainedで「Qwen/Qwen-Image-2.1-Turbo」を指定し、dtypeをtorch.bfloat16にしてcudaに載せる、という流れです。室谷代表取締役テキストto画像の例では、幅1696、高さ2528の縦長で生成していて、use_kv_cache=True、generatorにシードを渡す構成です。編集の例では入力画像をRGBAで読み込んで、幅・高さを2048にして同じパイプラインにimageとして渡す形になっています。
テキトー教師DotAI 認定講師解像度プリセットもベースと同じものが使えます。1:1が2048×2048、4:3が2400×1792、3:4が1792×2400、3:2が2528×1696、2:3が1696×2528、16:9が2752×1536、9:16が1536×2752の7種類です。
室谷代表取締役GUIで組みたい人向けには、ComfyUIの公式組織(Comfy-Org)のQwen-Image-2.1のリポジトリに、Turbo用の重み(bf16とint8)と、ベースモデルを8ステップで動かすためのLoRAが置かれています(10月25日時点)。Turboはベースと同じ7Bの構造なので、Qwen-Image-2.1向けのワークフローを土台に重みを差し替えて試す、という考え方になります。
テキトー教師DotAI 認定講師ただし、Diffusersではチェックポイントに保存された8ステップのスケジュールが自動で使われますが、ComfyUIでサンプラーやスケジューラを手で選ぶ場合は、その前提とずれないかを確かめながら試すのが安全です。どのサンプラーが最適かは、公式には書かれていません。
室谷代表取締役料金と提供範囲 — Pro/Turbo APIの価格と日本から使えるか
室谷代表取締役APIも見逃せません。Qwen-Image-2.1 ProとTurboのホスト型APIが、Alibaba CloudのModel Studioで正式に提供開始になりました。
Model Studioの料金ページを見ると、10月25日時点でこうなっています。
Model Studioの料金ページを見ると、10月25日時点でこうなっています。
| モデル | シンガポール(国際版) | 東京・フランクフルト・バージニアなどのリージョン | 無料枠(国際版) |
|---|---|---|---|
| qwen-image-2.1-turbo | 1枚0.016ドル(約2.5円) | 1枚0.014133ドル(約2.2円) | 10枚 |
| qwen-image-2.1-pro | 1枚0.04ドル(約6.3円) | 1枚0.035333ドル(約5.5円) | 10枚 |
テキトー教師DotAI 認定講師料金は生成した画像1枚ごとです。料金ページの画像生成の項には「日本(東京)」のタブがあり、そこを含むシンガポール以外のリージョンでは上の右側の単価(デプロイ範囲は「Global」)が並んでいます。
1,000枚作ると、Turboはシンガポールで約2,500円、Proで約6,300円の計算です。
1,000枚作ると、Turboはシンガポールで約2,500円、Proで約6,300円の計算です。
室谷代表取締役この記事の初版では無料枠を「提供なし」と紹介していましたが、10月25日時点の料金ページでは国際版に10枚の無料枠が書かれています。料金ページは更新されることがあるので、使う前に最新の表示を確認してください。
テキトー教師DotAI 認定講師編集部の計測で使ったOpenRouterでも、TurboとProの両方がAlibabaの提供で使えました。ただし実費は公式の単価より15%高かったので、量が多いならModel Studioの直接契約のほうが安くなります。
室谷代表取締役一方で、オープンウェイトがHugging Faceで公開されているので、自前環境で動かす道もあります。APIを使うか、Turboのウェイトを自分のワークフローに組み込むか、両方選べるのが今回のポイントなんですよね。
編集モデル側の進化とローカル実行の注意点はQwen-Image-Edit-2511とは?2509からの進化とローカル実行・商用利用の注意点で整理しています。
編集モデル側の進化とローカル実行の注意点はQwen-Image-Edit-2511とは?2509からの進化とローカル実行・商用利用の注意点で整理しています。
ベースモデルQwen-Image-2.1との違いとTurbo化の狙い
室谷代表取締役ここが一番聞かれそうなところです。TurboはQwen-Image-2.1と同じ7Bの視覚生成アーキテクチャを使う、加速チェックポイントです。
ベースモデルはテキストto画像と画像編集を1モデルに統合し、透過画像の生成・編集にネイティブ対応しています。
ベースモデルはテキストto画像と画像編集を1モデルに統合し、透過画像の生成・編集にネイティブ対応しています。
テキトー教師DotAI 認定講師ベースモデルの技術的な特徴も押さえておきましょう。ブログによると、視覚生成コンポーネントは32のSingle-Stream DiTレイヤーと7Bパラメータで構成されています。
推論効率の最適化は混在粒度のアテンションアーキテクチャによるもので、テキスト(システムプレフィックスと編集指示を含む)はトークンレベルの因果マスク、画像生成はチャンクレベルのマスクを使う、という設計です。
推論効率の最適化は混在粒度のアテンションアーキテクチャによるもので、テキスト(システムプレフィックスと編集指示を含む)はトークンレベルの因果マスク、画像生成はチャンクレベルのマスクを使う、という設計です。
室谷代表取締役Turbo化の狙いはシンプルで、「品質を保ちつつ、いかに速く・安く回すか」という画像生成AIの永遠の課題への回答です。編集部の試行でも、同じAPI経由でProの5.5〜7割の時間・約4割の費用でした。
テキトー教師DotAI 認定講師ただし注意点として、Turboがベースモデルからどれだけ品質が劣化するかを示すベンチマークの数値は、公式には示されていません。編集部の3つのプロンプトでは目立つ差は見えませんでしたが、これも少数の目視です。
室谷代表取締役ライセンスも重要です。このモデルはQwen Research License Agreementで提供されていて、本文では無償で使えるのは「研究または評価の目的」に限られます。
商用で使う場合は、Qwenに申請して別途の商用ライセンスを取得する必要がある、と明記されています。
商用で使う場合は、Qwenに申請して別途の商用ライセンスを取得する必要がある、と明記されています。
テキトー教師DotAI 認定講師ここは誤解しやすいので強調しておきます。重みが無料でダウンロードできても、業務の制作物に使うなら、ライセンスを取るか、商用利用の条件で提供されているModel StudioのAPIを使う、という整理になりますね。
よくある質問 — ステップ数・CFG・料金・日本語・ライセンスの疑問
Q. 何ステップで生成しますか?
室谷代表取締役8ステップが推奨で、チェックポイントに保存されたスケジュールが自動適用されます。num_inference_stepsを設定しただけでは上書きされないので注意です。
Q. CFGはどう設定しますか?
テキトー教師DotAI 認定講師公式にはデフォルトでCFG=1と説明されています。CFGを明示的にいじる前提ではなく、そのまま使う設計です。
Q. API料金はいくらですか?
室谷代表取締役Model Studioのシンガポール(国際版)で、Turboが1枚0.016ドル(約2.5円)、Proが1枚0.04ドル(約6.3円)。東京などのリージョンではTurboが0.014133ドル(約2.2円)です(10月25日時点)。
Q. 日本語の文字は描けますか?
テキトー教師DotAI 認定講師公式の資料には記載がありませんが、編集部が日本語のプロンプトで黒板メニューを3回生成したところ、「本日のおすすめ」「抹茶ラテ 480円」を3回とも正しく描けました。
Q. 生成にかかる時間は?
室谷代表取締役編集部がOpenRouter経由で生成した中央値は、1枚22〜33秒でした。Proは40〜48秒です。
ローカルで動かした場合の時間は測っていません。
ローカルで動かした場合の時間は測っていません。
Q. VRAMはどれくらい必要ですか?
テキトー教師DotAI 認定講師公式の資料に具体的な数値の記載はありません。モデルカードの表示では、テンソルタイプはBF16です。
Q. 商用利用できますか?
室谷代表取締役重みはQwen Research License Agreementで、無償で使えるのは研究・評価目的だけです。商用利用には、Qwenに申請して別途ライセンスを取得する必要があります。
テキトー教師DotAI 認定講師まとめると、Qwen-Image-2.1-Turboは「8ステップで2K生成と自然言語編集ができる、7Bのオープンウェイト加速チェックポイント」で、APIは1枚0.014〜0.016ドル(約2.2〜2.5円)。編集部の試行ではProの5.5〜7割の時間で、日本語の文字も描けました。
室谷代表取締役画像生成のコストと速度は、プロダクトに組み込むかどうかを左右する要素なので、Turboの登場は地味に大きいんですよね。グラフのように数字が大事な画像はまだ任せきれないので、そこだけ気をつけて使ってみてください。