GLMとは何か、開発元のZ.aiはどんな会社なのか
GLMとZ.aiの歩み
- 2019年Z.ai設立旧社名Zhipu AI(智谱AI)。清華大学の研究成果をベースに設立。本社は北京、CEOはZhang Peng氏
- 設立後GLMを中核に研究開発中国初の100億パラメータモデル、最初のオープンソース100億パラメータモデルを発表
- 2026年1月8日香港証券取引所メインボード上場銘柄コード02513.HK、公開価格116.2香港ドル、調達額約43億香港ドル。世界初の上場LLM企業
- 最新GLM-5.3(フラッグシップ)ベースモデルはGLM-5.2と同じままで、事後学習だけを拡大して性能を伸ばした世代
GLMシリーズは何を指す呼び名なのか
 室谷代表取締役
GLMって、単体のモデル名だと思われがちなんですけど、Z.aiが手がけるモデルシリーズ全体の総称なんですよね。
 テキトー教師DotAI 認定講師
そうなんですよ。初めて触る人は「GLM-5.3がGLMというモデル名なのか」で混同しがちで。
シリーズ名と個別モデル名に同じ言葉が入るので、そこが最初の戸惑いポイントなんです。
シリーズ名と個別モデル名に同じ言葉が入るので、そこが最初の戸惑いポイントなんです。
室谷代表取締役中核がGLMで、そこから業界特化だったり用途を絞ったものだったりに枝分かれしてる。汎用モデルだけじゃないんですよ。
法律特化のモデルも出してて、詳しくはGLM-Legalとは?Z.aiが発表した法律特化モデルで解説しています。
法律特化のモデルも出してて、詳しくはGLM-Legalとは?Z.aiが発表した法律特化モデルで解説しています。
テキトー教師DotAI 認定講師なるほど、ひとつの型番ではなくシリーズとして広げていってるんですね。
開発元Z.aiはどこから来た会社なのか
室谷代表取締役運営元のZ.aiは、旧社名がZhipu AI、智谱AIですね。2019年に清華大学の研究成果をベースに設立された会社で、本社は北京、CEOはZhang Peng氏です。
テキトー教師DotAI 認定講師大学の研究室がそのまま会社になったタイプなんですね。
室谷代表取締役そう。設立からGLMを中核に据えて、中国初の100億パラメータモデルを出したり、最初のオープンソース100億パラメータモデルを発表したりしてる。
研究色の強い組織がそのままプロダクトを出してる構造なんですよ。
研究色の強い組織がそのままプロダクトを出してる構造なんですよ。
テキトー教師DotAI 認定講師使う側からすると、その研究色の強さがモデルの更新テンポに出てる感じがします。
2026年1月の香港上場で見えてきたこと
室谷代表取締役この会社、2026年1月8日に香港証券取引所のメインボードに上場してるんですよね。銘柄コードは02513.HK、公開価格116.2香港ドル、調達額は約43億香港ドル。
世界初の上場LLM企業という扱いです。
世界初の上場LLM企業という扱いです。
テキトー教師DotAI 認定講師それは大きい話ですね。私たち使う側にとって何が変わるんでしょう。
室谷代表取締役経営目線で言うと、非上場のラボと上場企業では継続性の見え方が全然違うんですよ。開示義務があるぶん、事業が突然なくなるリスクは読みやすくなる。
中長期で業務に組み込む判断をするとき、そこは地味に効きます。
中長期で業務に組み込む判断をするとき、そこは地味に効きます。
テキトー教師DotAI 認定講師たしかに、ツール選びって性能の数字だけで決められない部分ですもんね。
最新のGLM-5.3は何世代目の位置づけなのか
室谷代表取締役最新のフラッグシップがGLM-5.3で、位置づけがちょっと面白いんですよ。ベースモデルはGLM-5.2と同じままで、事後学習だけを拡大して性能を伸ばしてる。
テキトー教師DotAI 認定講師土台を作り直すんじゃなくて、仕上げを厚くした世代なんですね。
室谷代表取締役そう。だから「また新しいモデルが出た」というより「同じ土台の伸びしろを掘った」という見方のほうが実態に近い。
ここを取り違えると、乗り換えの判断を間違えるんですよね。
ここを取り違えると、乗り換えの判断を間違えるんですよね。
テキトー教師DotAI 認定講師なるほど。世代を数字の大きさだけで追うと、見落としそうなところです。
GLM-5.3のAPI仕様はどうなっている?
コンテキスト1M・最大出力128Kで何が変わるのか
室谷代表取締役まず仕様の骨格から。テキスト入力のみ対応で、コンテキストは最大100万トークン、出力は最大128Kトークンまでなんですよね。
この数字、実務だと効き方がはっきりしてるんです。
この数字、実務だと効き方がはっきりしてるんです。
テキトー教師DotAI 認定講師100万トークンって言われてもピンとこない人が多くて。リポジトリを丸ごと渡せる感覚なんですよ。
分割して貼り直す手間が消えるのが一番大きいです。
分割して貼り直す手間が消えるのが一番大きいです。
室谷代表取締役出力128Kも地味に効くんです。長い設計書やテスト一式を一気に吐かせる時、途中で切れると人が継ぎ接ぎすることになる。
時給で換算すると、その手戻りが一番高くつくんですよ。
時給で換算すると、その手戻りが一番高くつくんですよ。
テキトー教師DotAI 認定講師あー、切れた続きを人が繋ぐ作業、現場で本当に嫌がられますね。
reasoning_effortのlow・high・maxはどう選ぶのか
reasoning_effortの3段階と使い分け
low
- 思考トークンの消費を抑えたい雑務向け
- 旧モデルでthinking.type=disabledを使っていた場合の移行先
high
- 設計やレビュー向け
- 公式社内ベンチ: 出力約5万トークンで正解率31.4%
室谷代表取締役reasoning_effortはlow・high・maxの3段階で、既定はmax。ここ、コスト設計の話なんですよ。
テキトー教師DotAI 認定講師最初に戸惑うのがここで。「既定がmaxなら何もしなくていいんですか」とよく聞かれます。
ただ、常にmaxで回すと思考トークンをしっかり食うので。
ただ、常にmaxで回すと思考トークンをしっかり食うので。
室谷代表取締役公式の社内ベンチだと、Max effortは出力約7.5万トークンで正解率34.5%、High effortは約5万トークンで31.4%なんです。要はMaxはその分粘る設計で、安いから落とすという話でもないんですよね。
テキトー教師DotAI 認定講師なるほど。雑務はlow、設計やレビューはhigh、難所だけmax、みたいな配分が現実的ですね。
常時思考になったことで旧モデルからの移行は何が必要か
室谷代表取締役一番ハマりやすいのがここ。thinking.typeがenabled固定で、思考を切れないんですよ。
旧モデルでdisabledを使っていた場合は、enabledに切り替えてreasoning_effortをlowに落とす移行が要ります。
旧モデルでdisabledを使っていた場合は、enabledに切り替えてreasoning_effortをlowに落とす移行が要ります。
テキトー教師DotAI 認定講師これ、ハマる人多いんですよ。「速く安く回すために思考オフ」という前提で組んでいた設定が、そのままでは通らなくなりますから。
室谷代表取締役逃げ道が塞がれたわけで、ワークフロー自体の設計を見直す必要がある。これが実務インパクトとして一番大きいんですよね。
テキトー教師DotAI 認定講師逆に言うと、思考を切る前提だった処理を棚卸しするいい機会でもありますね。
3種類の互換プロトコルはどう使い分けるのか
室谷代表取締役最後に接続の話。対応プロトコルは3つあって、OpenAI Chat Completion互換、OpenAI Response互換、Anthropic Message互換なんです。
テキトー教師DotAI 認定講師既存の開発環境をそのまま活かせるのが大きいですね。ただ、GLM Coding Planで契約している場合はOpenAI Chat Completion互換の経路だけなので、そこは先に押さえておきたいところです。
室谷代表取締役Anthropic互換まで用意しているの、構造として面白くて。乗り換えコストを下げにいっているわけですよ。
テキトー教師DotAI 認定講師エンドポイントが3つに分かれているので、環境変数の向き先を間違えないようにしたいですね。
GLM-5.3はGLM-5.2から何がどう進化したのか
コーディング系ベンチマークはどこまで伸びたのか
室谷代表取締役GLM-5.3、Z.aiの最新フラッグシップなんですけど、中身を見るとベースモデルはGLM-5.2と同じなんですよね。事後学習だけを拡大して性能を伸ばしてる、という設計なんです。
テキトー教師DotAI 認定講師そこが面白くて。土台を替えずに仕上げだけでここまで来るのか、という感じですよ。
Terminal-Bench 3.0が4.6から28.3、DeepSWE v1.1が46.2から66.9ですからね。
Terminal-Bench 3.0が4.6から28.3、DeepSWE v1.1が46.2から66.9ですからね。
室谷代表取締役Z.ai Code Benchで前世代比50%の性能向上、Terminal Bench 3.0とAgents' Last Examはオープンソースモデル中でSOTA。数字だけ並べると、もう別モデルですよ。
テキトー教師DotAI 認定講師Agents' Last Examの23.8から28.5という伸びも、並べられる相手がClaude Fable 5やGPT-5.6 Solになってくるあたり、立ち位置が一段変わった証拠ですね。
サイバーセキュリティ能力の数値は何を示しているのか
室谷代表取締役セキュリティ領域が一番象徴的で。脆弱性発見のCyberGymが77.2%から84.5%に上がって、Mythos5の83.8%とGPT-5.6 Solの83.6%を抜いて最高値なんですよ。
テキトー教師DotAI 認定講師一方で、悪用の深い推論を問うExploitBenchは24.4%から54.4%で倍増してるんですが、Mythos5の78.0%には届いていないんですよね。ここは正直に押さえておきたいところです。
室谷代表取締役時限内の悪用達成数も伸びてはいるけど、Mythos5の方がまだ上。守る側が伸びて、攻める側も伸びたけど差は残る、という構図なんですよね。
テキトー教師DotAI 認定講師Z.aiは複数のセキュリティチームと269件のOSSプロジェクトを検証して2,436件の脆弱性を見つけてる。最長で約40年潜伏していたものもあったらしく、これは実務に効く話ですよ。
事後学習だけで伸ばした設計とはどういうことか
室谷代表取締役ベースを固定して事後学習を厚くする設計、これコスト構造で見るとかなり合理的なんですよね。新規の事前学習は桁違いに重いので、そこを抑えて伸ばせるなら投資効率がまるで違ってくる。
テキトー教師DotAI 認定講師現場感覚で言うと、「モデルを替える」より「育て方で伸ばす」イメージなんですよ。初めて触る人は、同じ系列なのに急に別物になったように見えて戸惑うんです。
室谷代表取締役しかも複数のベンチでオープンソース中SOTAを取ってくる。規模を大きくしなくても競争力が出せる、という業界の構造が透けて見えるんですよね。
テキトー教師DotAI 認定講師ただ、伸び方にムラがあるのも事実なんですよ。セキュリティの攻撃側の数値みたいに、まだ届いていない領域も残ってますから、万能になったわけではないです。
トークンあたりの正答率はどう変わったのか
室谷代表取締役社内ベンチのトークン効率が地味に効くんですよ。Max effortだと約7.5万トークンで正解率34.5%、前世代は約9.6万トークンで23.4%。
同じ正解に使うトークンが減ってるんです。
同じ正解に使うトークンが減ってるんです。
テキトー教師DotAI 認定講師ここ、コストを見ている人には一番大事なところです。High effortだと約5万トークンで31.4%で、Claude Opus 4.8が約12万トークンで29.5%なんですよね。
室谷代表取締役だから同じ予算でも回せる回数が変わってくる。時給で換算するまでもなく、トークンあたりの正答率はそのまま請求額に効いてきますから。
テキトー教師DotAI 認定講師ただ、Claude Fable 5はMaxで39.5%なので、絶対値で上を取りに行く場面ではまだ差がある。期待値と用途で見極めたいところですね。
GLM Coding Planの料金とLite・Pro・Maxの上限はどう違う?
月額18ドルからの3プランは何が違うのか
室谷代表取締役個人向けのプラン、Lite・Pro・Maxの3段階で月額18ドルからなんですよね。エンジニアの時給で換算すると数分で消える金額なので、ここで長く悩むのはもったいない。
テキトー教師DotAI 認定講師そうですね。ただ最初に戸惑うのが、金額より「ポイントの枠」のほうなんですよ。
初めて触る人は料金だけ見て判断しちゃいがちで。
初めて触る人は料金だけ見て判断しちゃいがちで。
室谷代表取締役枠は二重構造で、5時間ごとの上限と週の上限が別々にある。単位はポイントで、Liteが2,000と10,000、Proが12,000と60,000、Maxが28,000と140,000です。
テキトー教師DotAI 認定講師数字を並べるとこうなります。
| プラン | 5時間の上限 | 週の上限 |
|---|---|---|
| Lite | 2,000 | 10,000 |
| Pro | 12,000 | 60,000 |
| Max | 28,000 | 140,000 |
ポイント消費はどう計算されるのか
室谷代表取締役消費の式が独特で、(入力トークン×入力係数+キャッシュ入力トークン×キャッシュ係数+出力トークン×出力係数)÷10,000、これが1回の消費量なんですよ。
テキトー教師DotAI 認定講師はい、ここで効くのが出力の重みです。GLM-5.3だと入力6.9・キャッシュ入力1.7・出力24。
出力が入力の3倍以上あるので、長く喋らせるほど減りが速いんです。
出力が入力の3倍以上あるので、長く喋らせるほど減りが速いんです。
室谷代表取締役Flashは入力2.3・キャッシュ入力0.56・出力8で、かなり軽い。Web SearchやZreadみたいなツールも呼び出し1回ごとに1.2を食うので、地味に積み上がります。
テキトー教師DotAI 認定講師リセットの感覚も大事です。5時間ぶんは使い切ったあと5時間で戻る、週ぶんは契約から7日ごと。
週の頭に固めて走らせる人ほど週の枠で止まりやすいんですよ。
週の頭に固めて走らせる人ほど週の枠で止まりやすいんですよ。
ピーク時間とオフピークで消費はどう変わるのか
室谷代表取締役実務で一番効くのがここで。平日のシンガポール時間14時〜18時、日本時間だと15時〜19時がピークで、消費が2倍になります。
テキトー教師DotAI 認定講師逆に平日のピークを外した時間帯と土日は終日50%なんですよ。同じ作業でも、いつ走らせるかで減り方が倍違う。
室谷代表取締役経営目線で言うと、重い処理をオフピークに寄せるだけで原価が変わるのは大きい。従量課金のAPIと比べて最大92%節約、という数字も出ています。
テキトー教師DotAI 認定講師ただ日本の夕方ってちょうど稼働時間なので、チームで回すなら時間をずらす判断が要りますね。
旧モデル名を指定するとどうルーティングされるのか
室谷代表取締役既存のコードに古いモデル名を書いたままの人、結構いるんですよね。GLM-5.2やGLM-5.1を指定すると、裏でGLM-5.3に自動で振り分けられます。
テキトー教師DotAI 認定講師現場でも「指定が古いままで性能が出ない」と悩むケースがありますが、実際は新しいモデルに飛んでいるので、そのままで動くとも言えます。
室谷代表取締役ただGLM-4.7を指定した場合はGLM-5.3-Flashに飛ぶ。ここは行き先が違うので、意図せず軽いほうに流れていないか一度確認したほうがいいです。
テキトー教師DotAI 認定講師全プランでGLM-5.3とGLM-5.3-Flashが使えるので、明示的に書き換えておくのが素直ですね。
Claude CodeやClineでGLMを使うにはどう設定する?
GLMをClaude Code/Clineで使う設定手順
- 01Z.AI Open Platformでアカウント作成まずアカウントを作成する
- 02プランを契約GLM Coding Plan または 従量課金API のどちらかを選ぶ。Coding PlanはOpenAI Chat Completion互換の経路のみ利用可能
- 03APIキーを発行管理画面でAPIキーを発行する
- 04キーを控える発行したキーを控えておく
- 05Claude Codeの場合: 環境変数を設定ANTHROPIC_AUTH_TOKEN にAPIキー、ANTHROPIC_BASE_URL に https://api.z.ai/api/anthropic を入れる。手書きが面倒なら npx @z_ai/coding-helper の自動設定を使う
- 06Clineなどの場合: エンドポイントを指定OpenAI互換のエンドポイントを指定する。Chat Completion互換とResponse互換があり用途で選ぶ
APIキー発行から契約までの流れ
- Z.AI Open Platformでアカウントを作成する
- GLM Coding Plan または 従量課金API のどちらかを契約する
- 管理画面でAPIキーを発行する
- 発行したキーを控えておく
室谷代表取締役設定で最初に止まるのは、実は契約のところなんですよ。Z.AI Open Platformでアカウントを作って、そこからCoding Planか従量課金APIを選ぶ、という流れになります。
テキトー教師DotAI 認定講師最初に戸惑うのが、プランによって後から使えるエンドポイントが変わる点なんですよね。先に契約してから「この経路は使えないのか」と気づくパターンです。
室谷代表取締役そう、Coding Planの契約者はOpenAI Chat Completion互換の経路のみ、という制限があるんですよ。だから契約の前に、自分の使い方でどの入口が開くのか確認しておくのが大事で。
テキトー教師DotAI 認定講師そこを見ずに進む人、現場でよく聞きます。キーは管理画面で発行するだけなので、契約の時点で経路を決めておく方が結局早いですね。
Claude Codeで使う場合の環境変数の設定
ANTHROPIC_AUTH_TOKENに発行したAPIキーを入れるANTHROPIC_BASE_URLにhttps://api.z.ai/api/anthropicを入れる- 手書きが面倒なら
npx @z_ai/coding-helperの自動設定を使う
室谷代表取締役Claude Codeから使う場合は、環境変数を2つ入れるだけなんですよね。キーと接続先、この2つです。
テキトー教師DotAI 認定講師ここでハマるのが、キーは入れたのに接続先を書き換え忘れるパターンです。片方だけで「動かない」と止まる人が多いんですよ。
室谷代表取締役自動設定のコマンドもあるので、そこは楽になってます。ただ、中で何を書き換えているかは一度見ておいた方がいい。
テキトー教師DotAI 認定講師そうですね。後で別のツールと併用したときに、どこに何が入っているか分からなくなるので。
Clineなど他のツールから使う場合の考え方
室谷代表取締役Clineのようなツールから使う場合は、OpenAI互換のエンドポイントを指定する形になります。Chat Completion互換とResponse互換があって、そこは用途で選ぶ感じですね。
テキトー教師DotAI 認定講師ツール側の設定画面にAPIの形式を選ぶ欄があることが多くて、そこを間違えるとまず動かないんですよね。キーが同じでも、形式が違うと反応しません。
室谷代表取締役だからツールごとに、どの方式を前提にしているかを先に見る。入口が違うだけで、契約しているプランは同じですから。
設定でつまずきやすいポイント
室谷代表取締役つまずきの半分は、契約プランとエンドポイントの対応を後から知るパターンなんですよね。手戻りが出ると地味に痛いので、先に経路を固めておきたいところです。
テキトー教師DotAI 認定講師あと、キーは発行できたのにモデル名の指定で迷う人も多いです。プランによって振り分けられるモデルが決まっているので、そこは公式の一覧を見た方が早いです。
室谷代表取締役画面の文言や最新の手順は公式が一次情報なので、そこは素直に確認するのが確実ですね。
テキトー教師DotAI 認定講師手順そのものは1回通せば終わりなので、最初に少し時間をかけて経路を確認しておくのが一番速いと思います。
法人向けのTeam Planは何が違う?
席単位のサブスク、StandardとPremiumで何が変わる?
Standard Seat と Premium Seat の違い
Standard Seat
- 5時間で15,000ポイント
- 週66,000ポイント
- 新モデル早期アクセスなし
- ピーク時間の優先権なし
Premium Seat
- 5時間で35,000ポイント
- 週155,000ポイント
- 新モデルへの早期アクセス
- ピーク時間の優先権
室谷代表取締役GLMを法人で契約するときに出てくるのがTeam Planで、要は席単位のサブスクなんですよね。Standard Seatが5時間で15,000ポイント、週66,000。
Premium Seatが5時間35,000で週155,000。上限だけ見ると2倍以上差がある。
Premium Seatが5時間35,000で週155,000。上限だけ見ると2倍以上差がある。
テキトー教師DotAI 認定講師その2倍という数字より、最初に戸惑うのが「ポイントって何なのか」なんですよ。トークンの消費量にモデルごとの係数をかけて1万で割った値で、入力より出力のほうが重く数えられます。
室谷代表取締役出力のほうが重い、というのは予算を組む側からするとかなり効きますよね。長いコードを吐かせる使い方ほど減りが早い。
だから全員に同じ席を配っておけば安心、という組み方だと、ほとんど回さない席から順に無駄が出る。
だから全員に同じ席を配っておけば安心、という組み方だと、ほとんど回さない席から順に無駄が出る。
テキトー教師DotAI 認定講師そこは均等に配るより、実際にエージェントを並走させる人へPremiumを寄せる発想のほうが合いますね。
最低シート数と、学習に使われないという既定
室谷代表取締役法人で一番聞かれるのがそこなんですよ。最低2シートからで、1メンバー1シート。
そして既定で、コードやプロンプト、会話内容はモデル学習に使われない。
そして既定で、コードやプロンプト、会話内容はモデル学習に使われない。
テキトー教師DotAI 認定講師個人で使っている人が社内に持ち帰ると、必ずここで止まります。「自分の書いたコードが学習に入るんじゃないか」と。
既定で入らないと決まっているのは、稟議資料に一行で書ける強さがあります。
既定で入らないと決まっているのは、稟議資料に一行で書ける強さがあります。
室谷代表取締役逆に最低2シートというのは、1人では契約できないということでもある。個人で足りなくなった人がそのまま流れてくる導線ではなく、最初から組織として入る前提の設計なんですよね。
テキトー教師DotAI 認定講師小さく試してから広げる、という進め方はしにくい形なんですね。
Premiumだけが使える機能は何か
室谷代表取締役Premiumの差分は2つで、新モデルの早期アクセスと、ピーク時間の優先権。前者は性能の問題じゃなくて、発表された日に触れるかどうかの差なんですよ。
テキトー教師DotAI 認定講師新モデルが出たときに試せる人と試せない人が混ざるのは、現場だと少し困ります。検証を誰が担当するのか、という話に飛びますから。
室谷代表取締役そこは経営判断で、全席Premiumにするか、検証する人だけに寄せるか。費用は席数かける単価で読みやすいので、判断材料としては素直なんですよね。
テキトー教師DotAI 認定講師ピークの優先権も、締切が重なる時期に効いてきます。混んでいる時間に枠が取れない、という体験は一度すると尾を引くので。
社内稟議で確認されるポイントはどこか
室谷代表取締役稟議で止まるのはだいたい3か所で、学習に使われないか、席の上限が業務量に足るか、そして契約経路。Z.aiと直接契約する以外に、Amazon Bedrock経由という選択肢もある。
詳しくはZ.aiの「GLM-5.3」とは?Amazon Bedrockで企業向け提供開始で解説しています。
詳しくはZ.aiの「GLM-5.3」とは?Amazon Bedrockで企業向け提供開始で解説しています。
テキトー教師DotAI 認定講師契約経路の話は実務で効きますね。既存のクラウド契約に寄せられるなら、新しいベンダーを立てるより通しやすいですから。
室谷代表取締役あとは期間限定で、オーバー利用分がAPI定価の10%引きになる。上限を超えたときの逃げ道が用意されているかどうかで、現場の安心感が変わるんですよね。
テキトー教師DotAI 認定講師上限が厳しすぎると使われなくなるので、そこは現実的な落としどころだと思います。
GLM-5.3のライセンスはどうなっている?
コードと重みでライセンスが違う
GLM-5.3のライセンス二層構造
推論・学習コード(リポジトリ)
- リポジトリ側のLICENSEファイル
- Apache License 2.0
- コードを触る場合はApacheの条件が別で乗る
モデルの重み
- 公式の発表文でMITと明記
- 「pure open、MIT open-source license、地域制限なし」
- 重みを使った検討はMITの枠で読む
室谷代表取締役ライセンスの話、ここが一番誤解されてるんですよね。GLM-5.3って「オープンなのか独自ライセンスなのか」で情報が割れてて・・・
テキトー教師DotAI 認定講師たしかに。初めて調べる人はそこで止まりがちです。
見ている場所が違うだけで、推論・学習コードのリポジトリと、モデルの重みは別物なんですよ。
見ている場所が違うだけで、推論・学習コードのリポジトリと、モデルの重みは別物なんですよ。
室谷代表取締役そう、リポジトリ側のLICENSEファイルはApache License 2.0。一方でモデルの重みは、公式の発表文でMITと明記されてる。
ここを一括りにすると説明が破綻するんですよね。
ここを一括りにすると説明が破綻するんですよね。
テキトー教師DotAI 認定講師「コードはApache、重みはMIT」の二層構造ですね。片方だけ見て「独自ライセンス」と書いてしまうと、社内の確認で普通に突っ込まれます。
重みはMIT、コード側はApache License 2.0という整理
室谷代表取締役重みの方は公式の紹介文に「pure open、MIT open-source license、地域制限なし」と書かれている。だから重みを使った検討は、MITの枠で読むことになるんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのが「重みがMITなら何でも自由なんですか」なんですけど、そこはコード側と分けて考える必要があります。推論コードを触るならApache License 2.0の条件が別で乗ってきますから。
室谷代表取締役うちの法務に投げると、まず「どこのファイルを見たのか」を聞かれるんですよ。出典の粒度まで揃えないと、稟議の場で説明が通らない。
テキトー教師DotAI 認定講師そこは経営側の実感ですね。資料に一行入れておくだけで、確認の往復が一回減ります。
なぜ二層に見えるのか
室谷代表取締役なんで二層になってるかというと、配っている対象が違うからなんですよ。コードを置いているリポジトリと、配布されるモデルの重みでは、性質も責任の範囲も別物なんですよね。
テキトー教師DotAI 認定講師レシピ本と完成品が別々に売られている感じです。レシピ本には本の利用条件が、完成品には商品の条件が付いてくる。
同じブランドでも中身の規約は別々なんですよ。
同じブランドでも中身の規約は別々なんですよ。
室谷代表取締役だから「GLMは独自ライセンス」と断定している説明を見たら、だいたいどちらか片方しか確認していない。両方を見るのが最低ラインです。
引用や社内説明で気をつけること
テキトー教師DotAI 認定講師社内で説明するときは「コードはApache License 2.0、モデルの重みはMIT」と並べて書くのが安全です。片方だけ書くと、後から前提が食い違ってきます。
室谷代表取締役あと、重みは発表から2週間後に安全性評価と堅牢化を終えてから公開される運用なので、その時点のLICENSEを都度確認する。これが結果的に一番コストが低いやり方なんですよね。
テキトー教師DotAI 認定講師初めて触る人は、配布ページのライセンス表記とリポジトリのLICENSEファイル、両方の一次資料を見に行く癖をつけるといいです。最新の条件は公式で確認してください。
室谷代表取締役そうですね。引用するなら「コード側はこう、重み側はこう」と分けて書く。
それだけで説明の信頼度が変わります。
それだけで説明の信頼度が変わります。
重みはどこで配布され、ローカルではどう動かす?
Hugging FaceとModelScopeでの配布状況
室谷代表取締役ライセンスの話の流れで、実際どこから重みを取るのかも見ておきたいんですよね。GLM-5.3はHugging FaceとModelScopeの両方で配布されていて、BF16版も用意されてるんですよ。
テキトー教師DotAI 認定講師そこ、最初に戸惑うポイントですね。海外勢はHugging Face、中国圏の開発者だとModelScopeが定番で、同じモデルが2箇所にある状態なんです。
どっちから落とすかで手が止まる人、けっこういます。
どっちから落とすかで手が止まる人、けっこういます。
室谷代表取締役同じ重みが2箇所にあるって、地味に効くんですよね。片方が重くても別ルートで取れるので、調達の安定性という意味では見逃せないところです。
GLM-5.3とGLM-5.3-Flashでパラメータ規模はどう違うのか
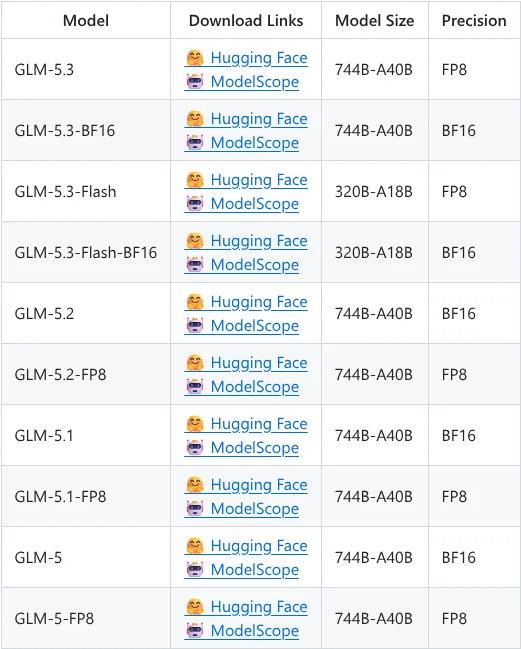
テキトー教師DotAI 認定講師規模の違いは数字で見たほうが早いので、先に置いておきますね。
| モデル | パラメータ | 精度 |
|---|---|---|
| GLM-5.3 | 744B-A40B | FP8 / BF16 |
| GLM-5.3-Flash | 320B-A18B | FP8 / BF16 |
室谷代表取締役Flashのほうが軽いぶん、手元に置く前提だと現実味があるんですよね。旗艦のほうは必要な計算資源の桁が違ってくるので、同じ「ローカルで動かす」でも覚悟が変わります。
テキトー教師DotAI 認定講師最初に触る人はFlashで動作確認してから旗艦に進む、という順番が無理しないと思います。動く感触を先に掴めると、その後の検証がぐっと進みますから。
室谷代表取締役経営目線だと、これはPoCの予算設計の話なんですよ。検証はFlash、性能が要る工程だけ旗艦、という配分はGPUコストの組み方として素直だと思います。
Transformers・vLLM・SGLangでの動かし方
- Hugging FaceまたはModelScopeから重みを取得する
- READMEのDownload Model表でGLM-5.3/GLM-5.3-Flash、FP8/BF16のどれを使うか決める
- READMEに案内されているTransformers・vLLM・SGLangの手順に沿って起動する
※具体的なコマンドや必要メモリはリポジトリの記載が最新なので、公式のREADMEで確認を。
室谷代表取締役手順自体はREADMEに3通りぶん載ってるんですよね。推論サーバーとして回すのか、手元で試すのかで選び方が変わる。
テキトー教師DotAI 認定講師そうなんですよ、そこは目的で分かれるところで。じっくり試すならTransformers、スループットを見たいならvLLMかSGLang、という選び方が現場感覚に近いです。
ただ実際に組むとメモリの話が絡むので、遠回りに見えて公式手順を素直に追うのが結局いちばん早いんですよ。
ただ実際に組むとメモリの話が絡むので、遠回りに見えて公式手順を素直に追うのが結局いちばん早いんですよ。
室谷代表取締役重みがFP8とBF16の両方あるのもありがたくて。手元のマシンに合わせて選べるので、検証の入口が下がるんですよね。
重みが公開されるまでの流れはどうなっているのか
室谷代表取締役もう一点、公開のタイミングに運用ルールがあって。重みは発表から2週間後、安全性評価と堅牢化を終えてから出る、という流れなんですよ。
テキトー教師DotAI 認定講師初めて触る人には意外なんですけど、モデルって発表と同時に重みが出るわけじゃないんですよね。評価が済むまで待つ。
この順番を知っておくと、公開直後に慌てずに済みます。
この順番を知っておくと、公開直後に慌てずに済みます。
室谷代表取締役企業の調達だと、この待ち時間をスケジュールに織り込めるかどうかが効いてくるんですよね。重みを自社環境に置く前提なら、なおさら。
日付の正確なところは公式ブログの一次情報で確認してほしいです。
日付の正確なところは公式ブログの一次情報で確認してほしいです。
よくある質問
Q1. GLMは日本語の文章でも実務で使える?
テキトー教師DotAI 認定講師現場でよく聞くのは「日本語の文章、大丈夫なんですか」なんですよね。ただ、これって用途で見方が変わるんですよ。
要約や推敲みたいに文脈を丸ごと渡す使い方と、社外に出す文章をゼロから書かせる使い方では、必要な精度がまったく違います。
要約や推敲みたいに文脈を丸ごと渡す使い方と、社外に出す文章をゼロから書かせる使い方では、必要な精度がまったく違います。
室谷代表取締役そこは分けて考えたほうがいいんですよね。下書きを作らせて人間が仕上げる前提なら、コストの差がそのまま効いてくる。
逆に、対外的な文面をそのまま出したいなら、確認の手間を前提に組み込む。文章の用途で線を引くのが現実的だと思います。
逆に、対外的な文面をそのまま出したいなら、確認の手間を前提に組み込む。文章の用途で線を引くのが現実的だと思います。
テキトー教師DotAI 認定講師たしかに。最初に戸惑うのが、「日本語は苦手らしい」という前評判だけで判断しちゃうパターンですね。
自分の業務の文章をいくつか食わせて見るのが、結局いちばん早いです。
自分の業務の文章をいくつか食わせて見るのが、結局いちばん早いです。
Q2. 複数のモデルを使い分ける意味はある?
室谷代表取締役これ、コストの話に見えて、実は可用性の話なんですよ。一つのモデルに寄せると、料金改定も利用上限も障害も、全部そのまま自社のリスクになる。
MYUUUでは、用途ごとに入口を分けておく前提で組んでます。
MYUUUでは、用途ごとに入口を分けておく前提で組んでます。
テキトー教師DotAI 認定講師現場感覚で言うと、乗り換え前提で作っておくと気が楽なんですよ。プロンプトの置き場所と、呼び出し部分を分けておくだけで、別のモデルに差し替えるときの作業量がかなり変わります。
室谷代表取締役そう、そこなんですよ。特定のツールに最適化しすぎると、次の選択肢が出たときに動けなくなる。
抽象化しておくのは、保険というより普通の設計判断ですね。
抽象化しておくのは、保険というより普通の設計判断ですね。
Q3. APIキーの管理や社内ルールはどう整える?
テキトー教師DotAI 認定講師初めて触る人がつまずくのが、キーをそのままコードに書いちゃうやつなんですよね。手元では動くので気づかない。
後から履歴に残っているのに気づいて青ざめる、という流れはよくあります。
後から履歴に残っているのに気づいて青ざめる、という流れはよくあります。
室谷代表取締役それは統制の話で、技術の話じゃないんですよ。誰がどのキーを持っているか、止めるときに誰が止めるか。
そこが決まっていないと、便利になった分だけ事故の上限も上がる。先に決めるべきはそこです。
そこが決まっていないと、便利になった分だけ事故の上限も上がる。先に決めるべきはそこです。
テキトー教師DotAI 認定講師たしかに。あと、入力していい情報とダメな情報を先に決めておくと、現場が迷わないんですよ。
ツールの設定より、そっちの合意のほうが効きます。
ツールの設定より、そっちの合意のほうが効きます。
Q4. 新しいバージョンが出たらすぐ乗り換えるべき?
テキトー教師DotAI 認定講師これ、現場でよく聞くんですよ。ただ、出た直後に飛びつく人と、しばらく様子を見る人で、その後の満足度が分かれる印象があります。
変わった点が自分の業務に効くのかどうかが基準ですね。
変わった点が自分の業務に効くのかどうかが基準ですね。
室谷代表取締役判断はシンプルで、乗り換えにかかる工数と得られる改善を比べるだけなんですよ。呼び出し部分が分かれていれば乗り換えは軽い。
逆にベタ書きだと、どんなに良くても動かせない。だから普段の設計が効いてくるんですよね。
逆にベタ書きだと、どんなに良くても動かせない。だから普段の設計が効いてくるんですよね。
テキトー教師DotAI 認定講師たしかに。あと、前のバージョンに戻れる状態を残しておくと、試すときの心理的なハードルが下がります。
Q5. GLMの最新情報はどこで追えばいい?
テキトー教師DotAI 認定講師一次情報に寄せるのが結局いちばん早いんですよ。まとめ記事は書かれた時点で止まるので、仕様や料金みたいに変わるものは、公式のドキュメントとリリースノートを見に行くのが確実です。
室谷代表取締役そうなんですよね。SNSの切り抜きは温度感は伝わるけど、条件が落ちていることが多い。
判断に使う数字は必ず原典に当たる。業務で使うなら、これは守ったほうがいいです。
判断に使う数字は必ず原典に当たる。業務で使うなら、これは守ったほうがいいです。
テキトー教師DotAI 認定講師たしかに。あと、追う対象を絞るのも大事で、全部を追うと疲れちゃうんですよ。
自分の用途に関わる部分だけ追うくらいで、ちょうどいいと思います。
自分の用途に関わる部分だけ追うくらいで、ちょうどいいと思います。
まとめ
室谷代表取締役ここまで読んでもらうと伝わると思うんですけど、GLMって「安いから選ぶ」より「選択肢を増やすために選ぶ」ものなんですよね。価格だけで寄せると、次の変更で一気に苦しくなる。
入口を分けておく、という発想のほうが長く効きます。
入口を分けておく、という発想のほうが長く効きます。
テキトー教師DotAI 認定講師たしかに。最初の一歩としては、いきなり全部を置き換えるより、コード補完みたいに失敗しても痛くないところから試すのがおすすめなんですよ。
慣れてきたら範囲を広げる、くらいの順番がちょうどいいです。
慣れてきたら範囲を広げる、くらいの順番がちょうどいいです。
室谷代表取締役そうですね。あと、試すときに「やめる条件」を先に決めておくといい。
何がどうなったらやめる、と決めておけば、判断が感情にならないんですよ。
何がどうなったらやめる、と決めておけば、判断が感情にならないんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、そのほうが続くんですよね。合う合わないは触ってみないと分からないので、小さく始めて、使えた分だけ広げる。
それが結局いちばん速いと思います。
それが結局いちばん速いと思います。