DeepSeek-V4.1-Flash-1017は、DeepSeekが2026年10月17日に公開した「DeepSeek-V4.1-Flash」のマイナーアップデート版で、API名deepseek-flashのまま中身が切り替わり、日本からもWeb・アプリ・APIで使えます。API料金は100万トークンあたり入力0.15ドル(約24円)・出力0.60ドル(約94円)で、日本時間の平日10〜13時と15〜19時のピーク時間は2倍になります(1ドル=156.8円で換算、2026年10月25日時点)。同じ日にSearch APIとFetch APIも全ユーザーに開放され、成功1,000回あたり0.75ドル(約118円)、Claude Code等経由の呼び出しも日本時間11月1日1時から課金が始まります。編集部が前版と同じ課題で比べたところ、出力トークンは3課題とも約1割短くなりました。
 室谷代表取締役
今日はDeepSeekの新しい発表を追いかけます。DeepSeek-V4.1-Flash-1017、名前が長いんですけど、これは2026年10月17日にDeepSeekが公開したV4.1-Flashのマイナーアップデート版なんですよね。
Web・アプリ・APIで利用可能で、APIは従来どおりモデル名
Web・アプリ・APIで利用可能で、APIは従来どおりモデル名
deepseek-flashで呼べる、と。 テキトー教師DotAI 認定講師
そうなんですよ。単に「新しいモデルが出た」という話じゃなくて、同時にSearch APIとFetch APIが一般開放されたのが今回のポイントです。
先に結論から言っておくと、モデル面は前版V4.1-Flashから推論・コーディング・エージェント・視覚の各ベンチマークが改善し、タスク実行時間と出力長は短くなった、いわゆる性能とコストのパレート改善です。APIはモデル名
先に結論から言っておくと、モデル面は前版V4.1-Flashから推論・コーディング・エージェント・視覚の各ベンチマークが改善し、タスク実行時間と出力長は短くなった、いわゆる性能とコストのパレート改善です。APIはモデル名
deepseek-flashのままで呼び出し方法も料金も変わらないので、既存利用者は設定変更なしで切り替わります。室谷代表取締役今回は発表の整理に加えて、編集部で前版と同じ課題を流して、出力の長さと費用を実際に比べてきました。そこは後半でじっくり見ていきます。
DeepSeek-V4.1-Flash-1017とは?何が発表されたのか
まとめ
DeepSeek-V4.1-Flash-1017 発表の要点
- V4.1 FlashがDeepSeek-V4.1-Flash-1017にアップグレードされ、公式Webとアプリのモデルも新バージョンに更新
- APIの呼び出し方法と料金は変わらず、`deepseek-flash`で最新モデルにアクセス可能
- 旧名の`deepseek-v4-flash`などで呼んでも1017が応答し、Flashの料金で課金される
- Hugging Faceのモデルカードでは前版の「マイナーアップデート」と説明。前版V4.1-Flashは2026年9月10日公開
- 同時にSearch APIとFetch APIが全ユーザーに開放された
- Search APIは自社検索エンジンで動作し、世界中で毎日数億件のリクエストを処理していると公式が説明
室谷代表取締役公式のチェンジログを見ると、V4.1 FlashがDeepSeek-V4.1-Flash-1017にアップグレードされて、公式Webとアプリのモデルも新しいバージョンに更新された、と。APIの呼び出し方法と料金は変わらず、
deepseek-flashを使えば最新モデルにアクセスできる、という案内なんですよね。テキトー教師DotAI 認定講師ここ大事です。モデル名を変えなくていい、つまり既存のAPI利用者は何も設定を変えずに新モデルの恩恵を受けられる、という設計です。
料金ページの注記によると、旧名の
料金ページの注記によると、旧名の
deepseek-v4-flashやdeepseek-v4-flash-vision-expで呼んでも受け付けられて、中身は1017が応答し、Flashの料金で課金されます。講座でも受講生さんから「バージョンが上がると呼び出し名が変わって困る」という声をよく聞くので、これは実務的にありがたいポイントですね。室谷代表取締役1017というサフィックスについて公式の説明はありませんが、公開日が10月17日なので日付を表していると見るのが自然です。Hugging Faceのモデルカードでも「DeepSeek-V4.1-Flashのマイナーアップデート」と書かれていて、前版のV4.1-Flashは2026年9月10日公開。
約1か月での更新なんですよね。
約1か月での更新なんですよね。
テキトー教師DotAI 認定講師前版のV4.1-FlashについてはDeepSeek V4.1 Flashとは?552B MoEとAA-AgentPerf首位のGB300を読み解くで詳しく解説していますが、今回はその延長線上にある位置づけです。新アーキテクチャ群で最小のモデル、という立ち位置は変わっていません。
室谷代表取締役で、今回の発表はモデルだけじゃないんですよ。Search APIとFetch APIが全ユーザーに開放された、というのが同時に来ているんです。
これはエージェントやRAGを作っている人にはかなり大きい。
これはエージェントやRAGを作っている人にはかなり大きい。
テキトー教師DotAI 認定講師しかも自社検索エンジンで動いていて、世界中で毎日数億件のリクエストを処理している、と公式が説明しています。そこが今回の発表の厚みなんですよね。
DeepSeek-V4.1-Flash-1017でできること——推論・コーディング・エージェント・視覚の進化
DeepSeek-V4.1-Flash-1017 ベンチマーク比較(前版→新版)
| ベンチマーク | 前版 | V4.1-Flash-1017 |
|---|---|---|
| HLE w/o tools | 36.8 | 42.6 |
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| ProgramBench | 20.3 | 29.1 |
| NL2Repo-Bench | 65.4 | 68.2 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 |
| Agents' Last Exam | 31.8 | 35.4 |
| Apex Bench v1.1 | 64.6 | 72.1 |
| Chartography (w/tools) | 78.9 | 83.0 |
| BabyVision (w/tools) | 89.6 | 92.5 |
| ZeroBench-main (w/tools) | 49.0 | 51.0 |
室谷代表取締役ベンチマークの数字を見ていくと、前版からの伸びがはっきり出ているんですよ。HLE w/o toolsが36.8から42.6、Terminal-Bench 4.0が31.2から42.3、DeepSWE v1.1が74.2から77.0、ProgramBenchが20.3から29.1。
テキトー教師DotAI 認定講師整理するとこうです。Hugging Faceのモデルカードの表から、前版と1017の数値を並べました。
- HLE w/o tools: 36.8(39.1†)→ 42.6(44.0†)
- Terminal-Bench 4.0: 31.2 → 42.3
- DeepSWE v1.1: 74.2 → 77.0
- ProgramBench: 20.3 → 29.1
- NL2Repo-Bench: 65.4 → 68.2
- Automation-Bench v1.0.6: 54.8 → 60.5
- Agents' Last Exam: 31.8 → 35.4
- Apex Bench v1.1: 64.6 → 72.1
- Chartography (w/tools): 78.9 → 83.0
- BabyVision (w/tools): 89.6 → 92.5
- ZeroBench-main (w/tools): 49.0 → 51.0
室谷代表取締役†はHLEのテキストのみのサブセット、Terminal-Bench 4.0はClaude Codeのハーネス、DeepSWE v1.1はMini-SWE-V2のハーネスで評価した、という注記も公式にあります。ZeroBench-mainはPass@5での評価ですね。
どれもDeepSeek自身が測った値です。
どれもDeepSeek自身が測った値です。
テキトー教師DotAI 認定講師この表で面白いのは、コーディング系の伸びが大きいところです。ProgramBenchが20.3から29.1で約9ポイント、Terminal-Bench 4.0が31.2から42.3で約11ポイント。
エージェント系のAutomation-BenchやAgents' Last Examも伸びています。
エージェント系のAutomation-BenchやAgents' Last Examも伸びています。
室谷代表取締役視覚系もChartographyが78.9から83.0、BabyVisionが89.6から92.5と伸びている。前版からネイティブな視覚理解を持っていたわけですけど、そこも着実に改善しているんですよね。
テキトー教師DotAI 認定講師公式スレッドでは「reinforcement learning with self-feedback」でエンドツーエンドのプロジェクト開発を改善した、と説明されています。ゲーム制作から3Dモデリングまで、という例が挙げられていますね。
室谷代表取締役あと見逃せないのが、性能を上げながらタスク実行時間と出力長を短くしている点です。これが「パレート改善」と呼ばれている部分で、速くて安く終わる、という方向に振っているんですよ。
ただ、どれだけ短くなったかの数値は公式に出ていません。そこで編集部で測ってみました。
ただ、どれだけ短くなったかの数値は公式に出ていません。そこで編集部で測ってみました。
編集部で試した結果——Claude Codeでの作業とAPIの計測で前版V4.1-Flash・GLM-5.3と比べた
室谷代表取締役数字の前に、実際の作業画面から見てもらいます。Claude Codeの中身を1017と前版V4.1-Flashに入れ替えて、社内資料からFAQページを作る作業を頼みました。
テキトー教師DotAI 認定講師試した環境はこうです。
- 日時: 2026年10月25日の午後(日本時間)
- ツール: Claude Code 2.1.310(ターミナル版)
- 接続: OpenRouter経由。Claude Codeの接続先をOpenRouterに切り替えて、モデルだけを入れ替えた(提供元はOpenRouterの自動選択)
- モデル: DeepSeek-V4.1-Flash-1017(
deepseek/deepseek-v4.1-flash-1017)と前版のV4.1-Flash(deepseek/deepseek-v4.1-flash) - 作業フォルダ:
docs/に社内資料6件を1件1ファイルで置いた。内容は後半の課題C(資料に基づく回答)と同じで、締め日が「25日」の古い通知と「20日」の新しい通知、領収書不要の上限が「5,000円」のFAQと「3,000円」の新しい通知が混ざっている
室谷代表取締役Claude CodeはAnthropic以外のモデルだと「認識できないモデル」という警告を出しますが、そのまま問題なく動きました。入力したプロンプトはこれです。
code
docs/ の社内資料を読んで、2026年11月分の経費精算の締め日と、11月10日の4,000円のタクシーで領収書が要るかを答えて。根拠の資料と、古い資料との食い違いも示した FAQ ページを index.html に作って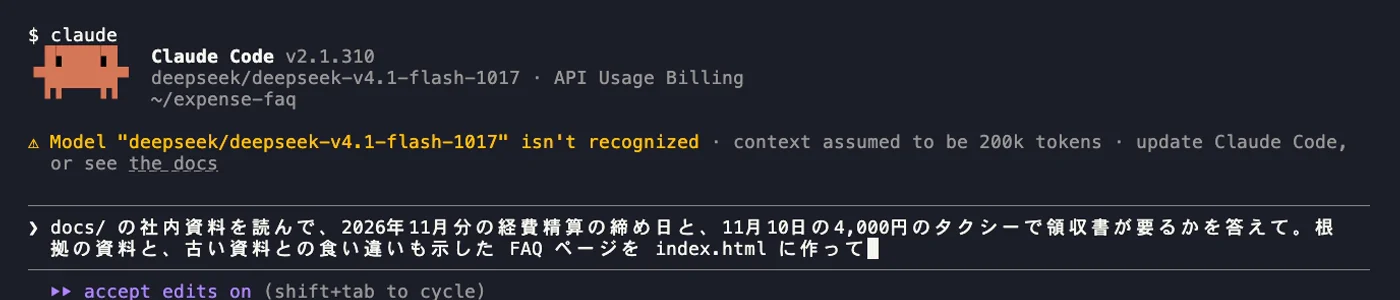
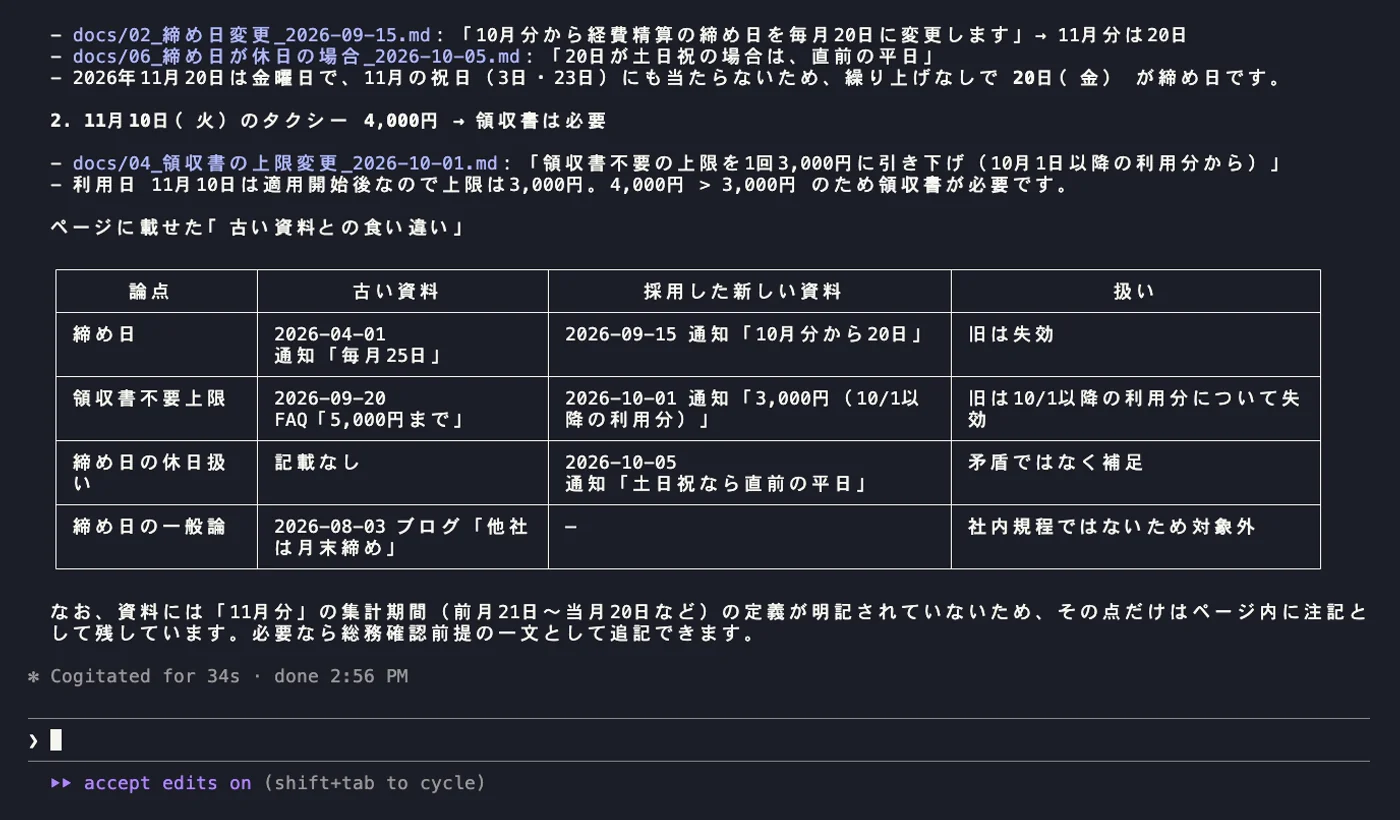
テキトー教師DotAI 認定講師作業中の画面です。1017は資料6件を読んだあと、Pythonで11月20日の曜日を確かめてから、ページを書き始めています。
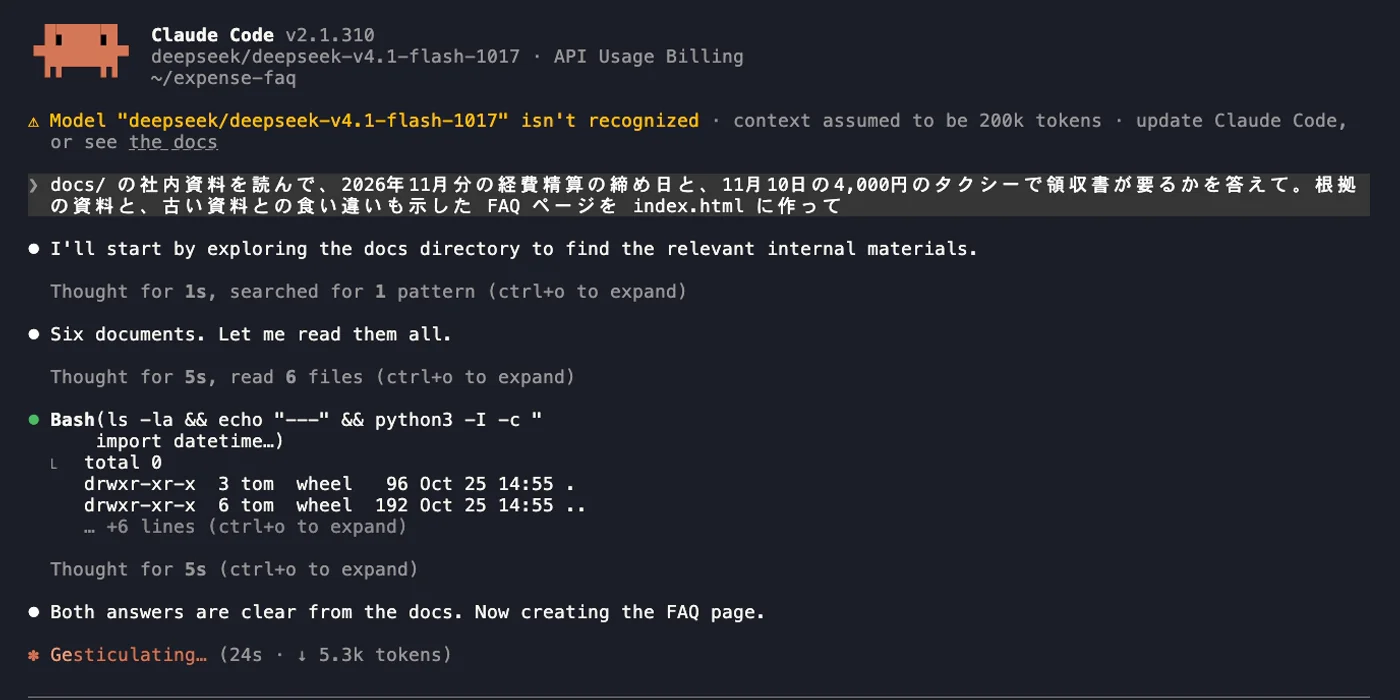
室谷代表取締役1017は34秒で完了しました。答えと、古い資料との食い違いを表にまとめて報告しています。
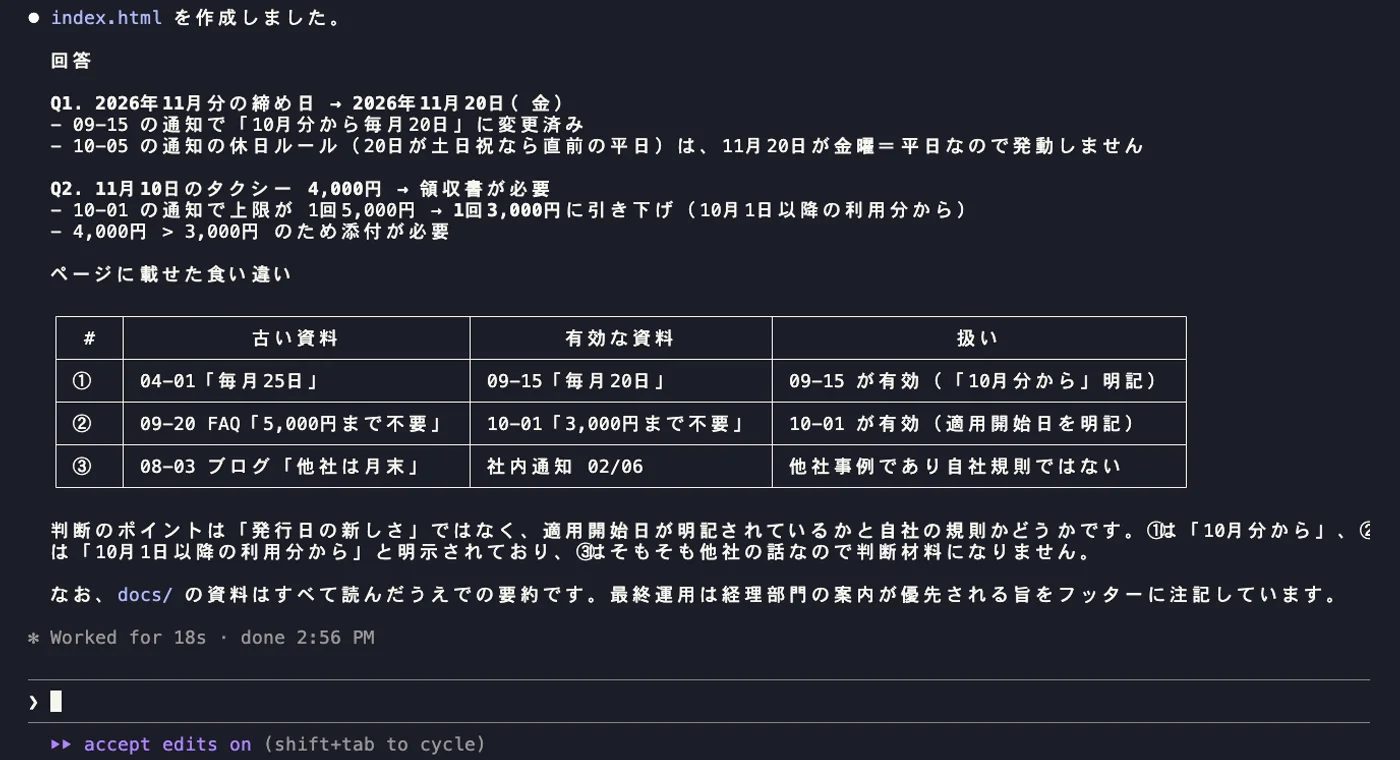
テキトー教師DotAI 認定講師前版は18秒で完了。答えは同じです。
室谷代表取締役作らせたFAQページを並べるとこうです。
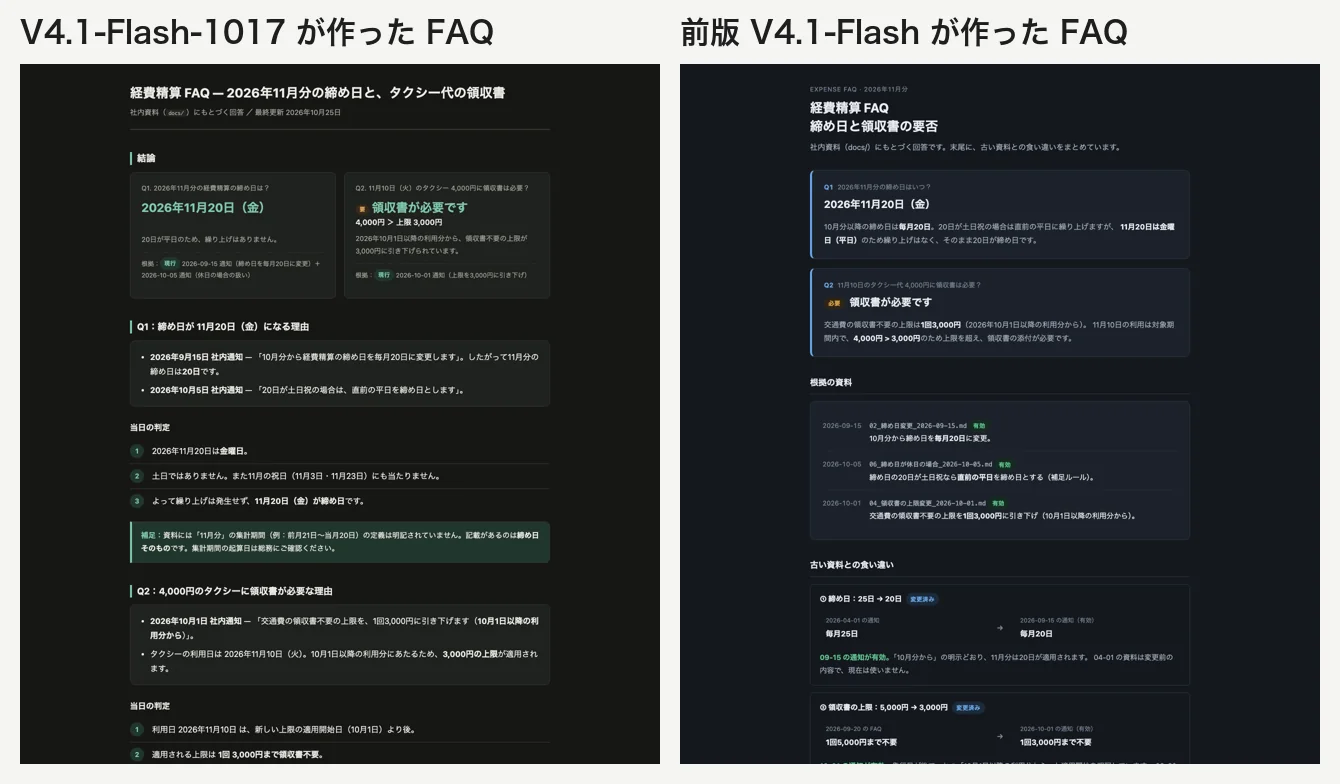
テキトー教師DotAI 認定講師違いを整理します。
- 正誤: どちらも正解。締め日は2026年11月20日(20日に変更した通知が有効で、休日の繰り上げは起きない)、上限は3,000円なので4,000円のタクシーは領収書が必要。根拠として02(締め日の変更)・04(上限の引き下げ)・06(休日の扱い)の通知を挙げた
- 時間: 1017が34秒、前版が18秒
- 確認の細かさ: 1017は11月の祝日(3日・23日)に当たらないことまで書き、作ったHTMLのタグの閉じ忘れをスクリプトで確かめた。さらに、資料に「11月分」の集計期間の定義がないことを注記した。前版は曜日を確かめたが、HTMLの検証はしなかった
- 古い資料の扱い: どちらも、他社の締め日を書いたブログは社内の決まりではないとして判断から外した。前版は根拠の資料3件をファイル名つきで並べ、変更前と変更後をカードで見せる作りだった
室谷代表取締役今回の1回では、1017のほうが時間をかけて確認を重ねました。公式の「出力長を短くした」という説明とは逆の向きですが、これは1回の実行例です。
同じ指示でも実行するたびに手順や時間は変わるので、速さの比較は後半のAPIでの計測を見てください。
同じ指示でも実行するたびに手順や時間は変わるので、速さの比較は後半のAPIでの計測を見てください。
室谷代表取締役ここからは補足として、Claude Codeを通さずAPIを直接呼んで、3つの課題を3回ずつ流した数字です。
テキトー教師DotAI 認定講師条件を整理するとこうです。
- 実施日: 2026年10月25日(日本時間・日曜)。OpenRouter経由で、1017と前版はどちらも同じ提供元(Together)に固定。比較のGLM-5.3(DeepSeekの公式表にも載っているモデル)はOpenRouterの自動選択で、応答したのはWafer
- 課題A(抽出): 架空のプレスリリースから3行要約と6項目をJSONで抜き出す。7点満点
- 課題B(コーディング): 「1万2,500円」のような日本語の金額表記を整数に変換するPython関数を書く。テスト12件で採点
- 課題C(資料に基づく回答): 日付の違う社内通知6件を渡し、「新しい資料を優先して」締め日と領収書不要の上限額を答え、根拠の資料IDを挙げる。3点満点(検索結果を読ませて答えさせるRAGの縮小版)
- 1017は既定の思考モードと、思考なし(non-thinking)の2通り
- 各課題3回、中央値。max_tokensは8,000に設定。円換算は1ドル=156.8円(欧州中央銀行の参照レート、2026年10月23日)
室谷代表取締役一つ断っておくと、DeepSeek公式のAPIそのものではなく、OpenRouter経由の別の提供元で測っています。編集部のOpenRouterアカウントは「入力を学習に使う提供元を除外する」設定にしていて、その設定だとDeepSeek公式の接続先がOpenRouter側で除外されたためです。
同じ設定で使っている会社は、ここに注意が必要です。
同じ設定で使っている会社は、ここに注意が必要です。
テキトー教師DotAI 認定講師まず正確さです。
| 課題(満点) | 1017(思考あり) | 1017(思考なし) | 前版V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|
| A 抽出(7) | 7(7・7・7) | 7(7・7・7) | 7(7・7・7) | 7(7・7・7) |
| B コーディング(12) | 12(0・12・12) | 11(11・11・8) | 12(12・12・12) | 11(10・12・11) |
| C 資料に基づく回答(3) | 3(3・3・3) | 3(3・3・3) | 3(3・3・3) | 3(3・3・3) |
※中央値(カッコ内は3回の内訳)。
室谷代表取締役課題Bの1017で1回だけ0点がありますよね。これは間違えたんじゃなくて、思考に8,000トークンを使い切って、回答のコードを出す前に止まったんです。
モデルカードの推奨設定は「max_tokensは256K以上」なので、思考モードで使うなら上限を小さくしないほうがいい、という実例ですね。前版も、提供元を固定しなかった予備の計測では同じように1回止まりました。
モデルカードの推奨設定は「max_tokensは256K以上」なので、思考モードで使うなら上限を小さくしないほうがいい、という実例ですね。前版も、提供元を固定しなかった予備の計測では同じように1回止まりました。
テキトー教師DotAI 認定講師思考なしの1017は速い代わりに、コーディングで取りこぼしが出ました。8点だった回のコードを見ると、単位を拾う正規表現に「億」ではなく中国語の簡体字「亿」が入っていて、「3億円」のような入力が全部失敗していたんですよ。
code
pattern = re.compile(r'([0-9,]+)([万亿千]?)')
...
        elif unit == "億":
total += num * 100000000正規表現は「亿」、分岐の条件は「億」なので、億の付いた金額だけ通らない。日本語の業務で使うなら、思考なしの出力はテストで確かめてから、ということですね。
テキトー教師DotAI 認定講師次が今回の本題、出力の長さです。思考ありの1017と前版を、同じ提供元・同じ課題で比べました。
| 課題 | 1017の出力トークン | 前版の出力トークン | 差 | 1017の総時間 | 前版の総時間 |
|---|---|---|---|---|---|
| A 抽出 | 404(思考259) | 446(思考298) | −9% | 1.5秒 | 1.1秒 |
| B コーディング | 5,031(思考4,649) | 5,500(思考5,230) | −9% | 20.0秒 | 10.1秒 |
| C 資料に基づく回答 | 682(思考646) | 789(思考747) | −14% | 3.1秒 | 1.9秒 |
※中央値。出力トークンは思考を含む。
室谷代表取締役出力は3課題とも9〜14%短くなりました。公式の「出力長を短くした」という説明と同じ向きです。
ただ、総時間は今回の計測ではむしろ1017のほうが長かったんですよね。提供元の混み具合にも左右されるので、時間については「短くなった」とは言えない結果でした。
ただ、総時間は今回の計測ではむしろ1017のほうが長かったんですよね。提供元の混み具合にも左右されるので、時間については「短くなった」とは言えない結果でした。
テキトー教師DotAI 認定講師3回ずつの小さな計測なので、差の大きさは目安です。思考なしにすると、課題Aが0.6秒(出力137トークン)、課題Cが0.35秒(出力37トークン)と、一気に速くなります。
室谷代表取締役費用も見ておきます。今回の実費はTogetherの単価(入力0.30ドル・出力1.20ドル)なので、トークン数をDeepSeek公式の単価に当てはめて計算し直しました。
| 課題 | 1017 思考あり(オフピーク) | 1017 思考あり(ピーク) | 1017 思考なし(オフピーク) | 1017 思考なし(ピーク) |
|---|---|---|---|---|
| A 抽出 | 0.046円 | 0.092円 | 0.020円 | 0.041円 |
| B コーディング | 0.48円 | 0.96円 | 0.033円 | 0.066円 |
| C 資料に基づく回答 | 0.074円 | 0.15円 | 0.013円 | 0.026円 |
テキトー教師DotAI 認定講師月額に直すと、課題Cの規模の問い合わせ回答を1日1万回(月30万回)こなす場合、思考ありで約142ドル(約2万2,200円、全部オフピーク)から約283ドル(約4万4,400円、全部ピーク)、思考なしなら約24ドル(約3,800円)から約49ドル(約7,700円)です。キャッシュヒットは別単価なので、同じ前置きを繰り返す使い方ならさらに下がります。
室谷代表取締役そこにSearch APIを1回ずつ足すと、月30万回で225ドル(約3万5,300円)。モデル代より検索代のほうが大きくなる計算なんですよね。
ここは設計のときに見落としやすいところです。
ここは設計のときに見落としやすいところです。
編集部の計測で分かったこと
同じ提供元・同じ課題で、1017の出力トークンは前版より9〜14%短かった。一方で総時間は短くならなかった。思考モードでmax_tokensを8,000にすると1回は回答前に止まった(公式推奨は256K以上)。思考なしは0.4〜0.9秒と速いが、コーディングでは取りこぼしがあった。
DeepSeek-V4.1-Flash-1017の料金——時間帯で2倍違う
テキトー教師DotAI 認定講師| 区分 | オフピーク | ピーク |
|---|---|---|
| 入力(キャッシュヒット) | $0.003(約0.5円) | $0.006(約0.9円) |
| 入力(キャッシュミス) | $0.15(約24円) | $0.30(約47円) |
| 出力 | $0.60(約94円) | $1.20(約188円) |
室谷代表取締役ピーク時間は「UTCの月〜金 01:00〜04:00と06:00〜10:00、中国の祝日を除く」です。日本時間に直すと、平日の10:00〜13:00と15:00〜19:00。
日本の業務時間とかなり重なるんですよね。週末と中国の祝日は終日オフピークです。
日本の業務時間とかなり重なるんですよね。週末と中国の祝日は終日オフピークです。
テキトー教師DotAI 認定講師急がない一括処理は夜間や週末に回すと半額、ということですね。ほかの仕様も整理しておきます。
- コンテキスト長: 100万トークン、最大出力: 384Kトークン
- 思考モード: 思考あり(既定)と思考なしの両方に対応
- JSON出力、ツール呼び出し、Responses API、Anthropic形式のAPIに対応
- 同時実行数の上限:
deepseek-flashは2,500
室谷代表取締役料金ページの注記には「価格は変わることがあり、DeepSeekは調整する権利を持つ」とも書かれています。導入前には必ず料金ページの最新の表示を確認してください。
V4.1-Flashの料金体系の経緯はDeepSeek V4とは?V4-ProとV4.1-Flashの違いと料金・安全性を整理で整理しています。
V4.1-Flashの料金体系の経緯はDeepSeek V4とは?V4-ProとV4.1-Flashの違いと料金・安全性を整理で整理しています。
DeepSeek-V4.1-Flash-1017の使い方・始め方——Web・アプリ・APIとHugging Faceでの入手
DeepSeek-V4.1-Flash-1017の4つの利用入口
公式Web
公式サイトから利用する入口
アプリ
アプリ経由で利用する入口
API
deepseek-flashを指定するだけで最新モデルに届く
オープンソースの重み
Hugging Faceで公開。ライセンスはMIT License
室谷代表取締役使い方の入り口は大きく4つですね。公式Web、アプリ、API、そしてオープンソースの重み。
APIは
APIは
deepseek-flashを指定するだけで最新モデルに届く、と。テキトー教師DotAI 認定講師オープンソースの重みはHugging Faceで公開されています。ライセンスはMIT Licenseです。
室谷代表取締役推奨サンプリングパラメータも公式に出ています。temperature 1.0、top_p 1.0、コンテキストウィンドウ1Mトークン、max_tokensは256K以上。
編集部の計測で、max_tokensを8,000にしたら思考だけで止まった回があったので、ここは本当に守ったほうがいいです。ローカル推論の手順はinferenceフォルダにまとまっている、という案内です。
編集部の計測で、max_tokensを8,000にしたら思考だけで止まった回があったので、ここは本当に守ったほうがいいです。ローカル推論の手順はinferenceフォルダにまとまっている、という案内です。
テキトー教師DotAI 認定講師プロンプトエンコーディングについても面白い記述があって、今回Jinja形式のチャットテンプレートは含まれていないんですよ。代わりにencoding.pyという自己完結したPythonのリファレンス実装が入っていて、マルチターンやツール呼び出し、thinkingモード、画像のインターリーブなんかのテストケースが同梱されている。
室谷代表取締役さらに本番用にはdeepseek-recipeというRustライブラリ(Pythonバインディング付き)が別途リリースされていて、Messages・Chat Completions・Responses APIのリクエストをConversation形式に変換して、V4/V4.1のプロンプトやトークンIDにエンコードし、出力をパースしてくれる、と。モデル推論やツール実行、HTTP転送は呼び出し側の責務、という切り分けですね。
テキトー教師DotAI 認定講師既存のV4.1-Flashからの移行を考えると、API利用者は何もしなくていい。ローカルで動かしている人は、エンコーディング周りを確認、という感じですね。
Hugging Faceの使い方そのものはHugging Faceとは?できること・料金・商用利用とNVIDIA買収の現在で整理しているので、重みを落としてくるところから始める人はそちらもどうぞ。
Hugging Faceの使い方そのものはHugging Faceとは?できること・料金・商用利用とNVIDIA買収の現在で整理しているので、重みを落としてくるところから始める人はそちらもどうぞ。
Search API・Fetch APIの料金と使い方——いつから有料か
室谷代表取締役ここが今回いちばん実務的な話です。Search APIとFetch APIは、成功したリクエスト1,000件あたり0.75ドル(約118円)。
トークン課金でも返却件数課金でもなく、リクエスト単位なんですよね。
トークン課金でも返却件数課金でもなく、リクエスト単位なんですよね。
テキトー教師DotAI 認定講師公式のSearch & Fetchガイドの課金ルールを整理するとこうです。
- Search API: 1,000成功リクエストあたり0.75ドル
- Fetch API: 1,000成功リクエストあたり0.75ドル
- 課金対象はHTTP 200かつ結果を返したものだけ(Searchはresultsが空でない、Fetchは本文が取得できた場合)
- 失敗したリクエスト、空の検索結果、タイムアウトは課金されない
- countは返却件数を制御するだけで、1リクエストの価格には影響しない
室谷代表取締役無料期間の扱いも公式に明記されています。DeepSeek Harness、Claude Code、Codex経由でDeepSeek APIを使う場合、サーバー側のツール呼び出しはすでにSearch/Fetch APIを使っていて、当面は無料。
課金開始は北京時間2026年11月1日0時、日本時間だと11月1日1時(UTCでは10月31日16時)です。
課金開始は北京時間2026年11月1日0時、日本時間だと11月1日1時(UTCでは10月31日16時)です。
テキトー教師DotAI 認定講師Claude CodeなどでWeb検索を使う設定のまま放っておくと、11月1日から自動で課金が始まる、ということですね。
室谷代表取締役レート制限は、SearchとFetchでアカウント単位の枠が別々になっていて、片方のトラフィックがもう片方の枠を消費しない。10月25日時点のガイドでは、毎秒のリクエスト数の上限がSearchで100、Fetchで25です。
APIキーが複数あってもアカウント単位で数えられ、Fetchはさらにドメインごとの上限もかかります。
APIキーが複数あってもアカウント単位で数えられ、Fetchはさらにドメインごとの上限もかかります。
テキトー教師DotAI 認定講師中身も見ていくと、Search APIはPOST
Search APIのリクエストはqueryが必須で1〜128文字、空白のみは不可。countは1〜50でデフォルト10、ori_questionで元の質問を渡してクエリ理解を助けられる、localizationで検索結果をローカライズできる、need_contentで本文を返すかどうかを切り替えられる、という構成です。
https://api.deepseek.com/v1/tools/search、Fetch APIはPOST https://api.deepseek.com/v1/tools/fetch。DeepSeek APIと同じBearer認証を使います。Search APIのリクエストはqueryが必須で1〜128文字、空白のみは不可。countは1〜50でデフォルト10、ori_questionで元の質問を渡してクエリ理解を助けられる、localizationで検索結果をローカライズできる、need_contentで本文を返すかどうかを切り替えられる、という構成です。
室谷代表取締役検索演算子もかなり揃っているんですよ。site:、-site:、除外語、完全一致、lang:、after:、before:。
例えば
例えば
DeepSeek site:github.com OR site:huggingface.co lang:en after:2025みたいに書けるわけですね。テキトー教師DotAI 認定講師レスポンスもよくできていて、rerank_scoreが0〜3の関連度スコアで1.5以上が高品質とされる。snippet(100〜200文字程度、UI表示向け)とsummary(600〜800文字程度、モデルに読ませる想定)が分かれていて、authority(0〜4、3以上が高権威)も返ります。
RAGに組み込むときはsummaryを使う、という設計が公式の意図として見えます。
RAGに組み込むときはsummaryを使う、という設計が公式の意図として見えます。
室谷代表取締役Fetch APIはもっとシンプルで、urlを1つ渡すとtitleとcontent(Markdown)が返る。urlは最大8192文字、HTTPかHTTPSでホストが必要、ユーザー名やパスワードを含んではいけない、と。
テキトー教師DotAI 認定講師エラーも整理されていて、408、429、5xxは待ってリトライ、402は残高をチャージしてからリトライ、それ以外の4xxはリクエストを変えずにリトライしない、という指針です。
室谷代表取締役両APIとも読み取り専用で、既存のAPIキーを持っていれば追加の契約なしでエージェントにWebアクセスを持たせられるわけです。自前でクローラーを運用したり、検索基盤を別に契約したりする必要がなくなる。
ただ、さっきの試算のとおり、検索を毎回呼ぶ設計だとモデル代より検索代が大きくなるので、呼ぶ回数は設計で絞ったほうがいいですね。
ただ、さっきの試算のとおり、検索を毎回呼ぶ設計だとモデル代より検索代が大きくなるので、呼ぶ回数は設計で絞ったほうがいいですね。
テキトー教師DotAI 認定講師公式のチェンジログでは、DeepSeek SearchがAIネイティブの汎用検索エンジンで、数千億ページをインデックスし、多言語検索に対応し、SEOスパムやGEO操作、低品質なAIGCを厳格な検出で除外する、と説明されています。RAGの品質って検索結果の質に大きく依存するので、そこを自社で握っているのは強みですね。
室谷代表取締役外部ツール経由の連携という意味では、CursorとChatGPT(OpenAI API)連携完全ガイド【2026年最新】:APIキー設定・料金・Slack連携まで徹底解説で扱っているようなAPIキー設定の考え方が、そのままDeepSeekのSearch/Fetchでも通用します。Bearer認証でキーを渡すだけですからね。
既存V4.1-Flashとの違いと「性能とコストのパレート改善」の中身
室谷代表取締役ここまでの話をまとめると、違いは3層なんですよ。1つ目がモデル性能、2つ目が実行時間と出力長、3つ目がSearch/Fetchの開放。
テキトー教師DotAI 認定講師公式は「Performance–cost Pareto improvement」という言い方をしています。性能を上げるとコストも上がる、というトレードオフを、両方改善する方向に動かした、という主張ですね。
室谷代表取締役編集部の計測では、出力の長さは確かに1割ほど短くなっていました。出力が短くなればトークン課金も減る。
一方で、今回の環境では総時間は短くならなかったので、速さは自分の使う経路で確かめたほうがいいと思います。
一方で、今回の環境では総時間は短くならなかったので、速さは自分の使う経路で確かめたほうがいいと思います。
テキトー教師DotAI 認定講師あと地味に大きいのが、DeepSeek Harness、Tencent CodeBuddy、WorkBuddyなどに向けて最適化しているという点です。DeepSeek Harnessはv0.2.1-rc.1以降へのアップグレードが推奨されています。
室谷代表取締役前版のV4.1-Flashが552BのMoEで、Causal Encoder–Decoderのアーキテクチャ、入力8B・出力16Bのアクティブパラメータ、KVキャッシュは前世代比でHBM 1/4、SSD 1/8、という構成だったのは9月10日の公式発表どおりです。1017の発表には構造の変更が書かれておらず、学習と最適化で伸ばしてきた更新と読めます。
だからこそAPIの呼び出し名も料金も変えずに済んでいるんですよね。
だからこそAPIの呼び出し名も料金も変えずに済んでいるんですよね。
テキトー教師DotAI 認定講師なお、モデルカードのベンチマーク表にはK3、GLM-5.3、GPT-5.6 Sol、Opus 5といった比較対象が並んでいますが、これはDeepSeek公式が公表した表の記載です。当記事では数値をそのまま紹介するにとどめ、優劣の断定はしません。
編集部の短い課題でも、GLM-5.3は抽出と資料に基づく回答で1017と同じ満点、コーディングは12件中11件でした。
編集部の短い課題でも、GLM-5.3は抽出と資料に基づく回答で1017と同じ満点、コーディングは12件中11件でした。
よくある質問
室谷代表取締役最後に、よく聞かれそうなところを整理しておきますか。
Q. DeepSeek-V4.1-Flash-1017は新しいモデルですか、アップデートですか?
テキトー教師DotAI 認定講師Hugging Faceのモデルカードにマイナーアップデートと明記されています。前版V4.1-Flashの更新版です。
Q. APIで使うには何をすればいいですか?
室谷代表取締役モデル名
旧名の
deepseek-flashを指定するだけです。呼び出し方法と料金は前版から変わりません。旧名の
deepseek-v4-flashでも1017が応答します。Q. 料金はいくらですか?
テキトー教師DotAI 認定講師100万トークンあたり、入力(キャッシュミス)0.15ドル(約24円)、出力0.60ドル(約94円)、キャッシュヒットの入力0.003ドルです。日本時間の平日10〜13時と15〜19時はピーク料金で2倍になります(10月25日時点)。
Q. 実際の費用はどれくらいですか?
室谷代表取締役編集部の計測では、資料6件を読んで答える課題が1回0.07〜0.15円(思考あり)、思考なしなら0.013〜0.026円でした。幅はオフピークとピークの差です。
Q. Search APIとFetch APIはいつから有料ですか?
テキトー教師DotAI 認定講師成功リクエスト1,000件あたり0.75ドルで、DeepSeek Harness、Claude Code、Codex経由のサーバー側ツール呼び出しは当面無料、課金開始は日本時間2026年11月1日1時(UTC 10月31日16時)からです。
Q. 日本から使えますか?
室谷代表取締役公式の料金ページとSearch/Fetchのガイドには、利用できる国や地域の制限は書かれていません(10月25日時点)。DeepSeek APIのアカウントがあれば同じBearer認証で利用できます。
社内で使う場合は、データの扱いを公式の規約で確認してください。編集部のように、OpenRouterで「入力を学習に使う提供元を除外する」設定にしていると、DeepSeek公式の接続先は使えませんでした。
社内で使う場合は、データの扱いを公式の規約で確認してください。編集部のように、OpenRouterで「入力を学習に使う提供元を除外する」設定にしていると、DeepSeek公式の接続先は使えませんでした。
Q. 思考モードと思考なしはどちらを使えばいいですか?
テキトー教師DotAI 認定講師編集部の計測では、抽出や資料に基づく回答は思考なしでも満点で、0.4〜0.6秒と速く済みました。コーディングは思考なしだと取りこぼしがあったので、思考ありで、max_tokensを公式推奨の256K以上にしておくのが安全です。
Q. オープンソース版はどこで入手できますか?
室谷代表取締役Hugging Faceで公開されています。ライセンスはMIT License。
推奨設定はtemperature 1.0、top_p 1.0、コンテキスト1Mトークン、max_tokens 256K以上です。
推奨設定はtemperature 1.0、top_p 1.0、コンテキスト1Mトークン、max_tokens 256K以上です。
室谷代表取締役というわけで、今回はモデル更新とAPI開放が同時に来た回でした。出力が短くなったのは編集部の計測でも確かめられましたが、ピーク時間と検索代は費用に効いてきます。
既存のAPIキーでそのまま試せるので、まずは小さく触ってみるのがいいんじゃないですかね。
既存のAPIキーでそのまま試せるので、まずは小さく触ってみるのがいいんじゃないですかね。
テキトー教師DotAI 認定講師そうですね。講座でも「まず動かして、コストを見てから設計する」という順番を勧めています。
Search/Fetchの無料期間のうちに、検索を何回呼ぶ設計になっているかを確認しておくのが賢い進め方です。
Search/Fetchの無料期間のうちに、検索を何回呼ぶ設計になっているかを確認しておくのが賢い進め方です。