Qwen3.5とは?Alibaba CloudのQwenチームが2026年2月に出したモデル
開発元と発表時期、モデルカードの引用情報から見えること
 室谷代表取締役
まずQwen3.5が誰の作かというと、Alibaba CloudのQwenチームなんですよね。発表は2026年2月。
これはHugging Faceの公式モデルカードの引用情報に
これはHugging Faceの公式モデルカードの引用情報に
month=February, year=2026 と書かれていて、そこで裏が取れます。 テキトー教師DotAI 認定講師
そこ、地味に大事なんですよ。現場でよく聞くのが「Qwen3.5っていつ出たやつ?」という素朴な疑問で、SNSの噂だけだと時期がずれて覚えられちゃうんですよね。
室谷代表取締役で、モデルカードを見るとライセンスがApache 2.0で、商用利用も改変も再配布も可なんですよ。オープンウェイトをここまで広く出す戦略は、業界構造としてかなり効いてくる。
自社のプロダクトに組み込める前提で選定できるってことなんで。
自社のプロダクトに組み込める前提で選定できるってことなんで。
テキトー教師DotAI 認定講師たしかに。重みが手元にあるかないかで、社内説明の通りやすさが全然違いますからね。
0.8Bでも「テキスト専用」ではない——全モデルがImage-Text-to-Textに分類される理由
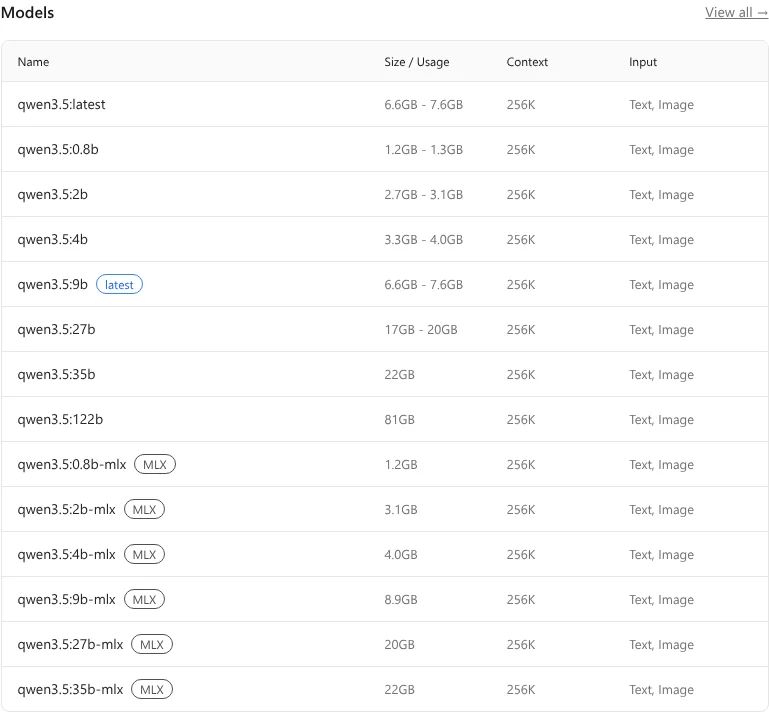
室谷代表取締役ここは誤解が多いので先に潰しておきたいんですけど、Qwen3.5は小型だからテキストだけ、というわけじゃないんですよ。0.8Bから397Bまで、Hugging Face上では全部「Image-Text-to-Text」に分類されてます。
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのがまさにそこで。「小さいモデルは軽い代わりに文字だけ」という前提で入ると、画像を渡せると知って驚くんですよね。
室谷代表取締役中身はUnified Vision-Language Foundationという設計で、テキストと視覚を早い段階から混ぜて学習させている。だから4Bや9Bの公式ベンチマークにも、視覚系のタスクの数値が並んでいるんです。
テキトー教師DotAI 認定講師小型で画像も扱えるとなると、クラウドに投げずに端末側で処理する選択肢が出てきます。そこは発想が変わるポイントですね。
コンテキスト長はネイティブ262,144トークン、YaRNで最大1,010,000トークン
室谷代表取締役長文を扱う前提の数値も見ておきましょう。公式モデルカードによると、ネイティブのコンテキスト長は262,144トークン。
YaRNスケーリングを使うと最大1,010,000トークンまで伸ばせる、と。
YaRNスケーリングを使うと最大1,010,000トークンまで伸ばせる、と。
テキトー教師DotAI 認定講師262,144と1,010,000は桁がひとつ違うので、同じモデルでも設定次第で別物になるんですよ。ここを混同したまま設計すると、後で前提が崩れます。
室谷代表取締役そのうえで201の言語と方言に対応していて、既定ではThinking modeが有効。つまり長い文脈と多言語と思考出力が最初から乗っている状態なんですよね。
仕様の数字は公式モデルカードで最新を確認するのが確実です。
仕様の数字は公式モデルカードで最新を確認するのが確実です。
テキトー教師DotAI 認定講師数字は必ず一次情報で、ですね。バージョンによって変わり得ますし。
モデル一覧とスペック——Small・Medium・Largeの3層を整理
3層のラインナップ、パラメータ数で見るとこうなる
室谷代表取締役まず並べてもらうと、どういう粒度になってるんですか。
テキトー教師DotAI 認定講師Small・Medium・Largeの3層です。表にするとこうですね。
| 層 | モデル |
|---|---|
| Small | 0.8B・2B・4B・9B |
| Medium | 27B・35B-A3B |
| Large | 122B-A10B・397B-A17B |
室谷代表取締役397B-A17Bが2026年2月16日、Smallの4本が3月2日で、4月23日前後にBase版も追加されてる。で、35B-A3Bとか122B-A10Bの「A」の数字は何を見ればいいんですか。
テキトー教師DotAI 認定講師ここはスパースMoEで、毎回すべてのパラメータを動かす構造ではない、という理解でいいと思います。だからLargeでも現実的な速度が出る設計なんですよ。
全モデル共通でコンテキストはネイティブ262,144トークン、YaRNで拡張すれば最大1,010,000トークンまで伸びます。
全モデル共通でコンテキストはネイティブ262,144トークン、YaRNで拡張すれば最大1,010,000トークンまで伸びます。
ライセンスは全モデルApache 2.0——商用利用の判断はここで決まる
室谷代表取締役ライセンスが全モデルApache 2.0なのは効きますよね。経営目線で言うと、法務に投げる前の段階で選択肢が残るので。
商用利用も改変も再配布も可能、と。
商用利用も改変も再配布も可能、と。
テキトー教師DotAI 認定講師現場でよく聞くのは「無料で試せたのはいいけど、社内で使っていいのか」というところなんですよ。Apache 2.0なら重みを社内に置いて動かす形も選べますから、そこは判断しやすいですね。
室谷代表取締役自社サーバーで動かせばAPIの従量課金は発生しなくて、コストはインフラ代だけになる。MYUUUでも検証用の推論環境は持ってますし、専門のML部隊がいなくても候補に入れられるのは大きいんですよね。
テキトー教師DotAI 認定講師ただ「重みが公開されているから何でも自由」ではないので、配布物に組み込む段階ではモデルカードの記載を確認しておくのが無難です。
201の言語・方言に対応——日本語はどこまで実用的か
テキトー教師DotAI 認定講師言語は201の言語・方言に対応していて、日本語もその範囲に入ります。
室谷代表取締役数字だけ見ると十分に見えるんですけど、実務だと日本語でどこまで使えるかが本題なんですよね。
テキトー教師DotAI 認定講師公式ベンチマークは英語寄りの項目が中心で、日本語の品質を数値で比べた表は出てないんです。手元の8GBのMacで試した範囲だと、0.8Bは日本語の品質が低め、2Bなら実用に乗る、という感触でした。
ここは自分の用途のデータで試すのが一番早いですね。
ここは自分の用途のデータで試すのが一番早いですね。
室谷代表取締役あと全サイズがImage-Text-to-Textで、テキスト専用ではないんですよ。画像や動画も入力できる前提の設計なので、何を入力させたいかまで含めてサイズを選ぶ話になりますね。
性能はどれくらい?GPT-OSS-120Bとのベンチマーク比較
言語タスクはMMLU-Pro・GPQA Diamond・IFEvalでどこまで出ているか
Qwen3.5-4B/9B vs GPT-OSS-120B ベンチマーク比較
| ベンチマーク | Qwen3.5-9B | Qwen3.5-4B | GPT-OSS-120B |
|---|---|---|---|
| MMLU-Pro | 82.5 | 79.1 | 80.8 |
| GPQA Diamond | 81.7 | 76.2 | 80.1 |
| IFEval | 91.5 | 89.8 | 88.9 |
室谷代表取締役数字を素直に見ましょうか。9BのMMLU-Proが82.5で、4Bでも79.1。
これ、GPT-OSS-120Bの80.8と並ぶか上なんですよね。パラメータは10分の1以下なのに。
これ、GPT-OSS-120Bの80.8と並ぶか上なんですよね。パラメータは10分の1以下なのに。
テキトー教師DotAI 認定講師初めて触る人が一番びっくりするのがそこです。「小さいモデルは性能が落ちる」という感覚がまだ強いので、120Bと横並びと言われると信じにくいみたいで。
室谷代表取締役GPQA Diamondも9B=81.7、4B=76.2で、120Bが80.1。IFEvalは9B=91.5、4B=89.8に対して120Bが88.9・・・指示追従まで小型が上に来てるんですよ。
テキトー教師DotAI 認定講師並べるとこうなりますね。
| ベンチマーク | Qwen3.5-9B | Qwen3.5-4B | GPT-OSS-120B |
|---|---|---|---|
| MMLU-Pro | 82.5 | 79.1 | 80.8 |
| GPQA Diamond | 81.7 | 76.2 | 80.1 |
| IFEval | 91.5 | 89.8 | 88.9 |
(数値はQwen3.5-4B/9Bの公式モデルカード掲載値)
視覚タスクはMMMU・MMMU-Pro・MathVisionでGPT-5-NanoやGemini-2.5-Flash-Liteとどう並ぶか
室谷代表取締役で、Qwen3.5は0.8Bから397Bまで全部が画像も扱える分類になってるんですよ。4B/9Bにも視覚の公式数値がちゃんと載ってる。
テキトー教師DotAI 認定講師MMMUが9B=78.4、4B=77.6です。GPT-5-Nanoが75.8、Gemini-2.5-Flash-Liteが73.4なので、このサイズで上に出てるんですよね。
画像を読ませる用途だと、ここが効いてきます。
画像を読ませる用途だと、ここが効いてきます。
室谷代表取締役MMMU-Proは9B=70.1に対してGemini-2.5-Flash-Liteが59.7。差が開くのは、考えて答える系の視覚問題なんですかね。
テキトー教師DotAI 認定講師そういう傾向だと見ています。あとMathVisionやVideoMMEの数値も公式モデルカードに載ってます。
細かい数字は更新されていくので、公式表を直接見てもらうのが確実です。
細かい数字は更新されていくので、公式表を直接見てもらうのが確実です。
長文脈のAA-LCRと、小型モデルが狙うポジション
室谷代表取締役長文脈のAA-LCRは9B=63.0、4B=57.0。コンテキストはネイティブで262,144、YaRNで最大1,010,000まで伸ばせる。
テキトー教師DotAI 認定講師ここ、数字だけ見ると地味なんですけど、実務だと「資料を丸ごと入れて質問する」が現実になるかどうかの線なんですよ。
室谷代表取締役経営目線で言うと、このサイズが手元で動くなら、社内文書を毎回クラウドに投げる前提のコスト設計を見直す材料になる。API従量を積むか、インフラを持つか、の判断ですね。
テキトー教師DotAI 認定講師ポジションとしては、フラッグシップを置き換えるというより前に小さく置く感じなんですよね。粗い処理を9Bで回して、難しい所だけ大きいのに渡す。
ローカルで動かす方法——Ollama・vLLM・llama.cppの使い分け
Ollama公式ライブラリから起動する——手順はこれだけ
- 自分の環境にOllamaを用意する
- ターミナルで
ollama run qwen3.5:9bを実行する - 起動したらプロンプトにそのまま入力して対話する(0.8b/2b/4b/9bとサイズを変えたいときは、その後ろの数字だけ替える)
室谷代表取締役ベンチの数字が良くても、手元で動かすとなると話は別で。一番ラクな入口はOllamaの公式ライブラリ経由なんですよね。
テキトー教師DotAI 認定講師そうなんですよ。初めて触る人が最初に戸惑うのが、モデル名の後ろの数字で。
「9bって何の数?」で止まる人が多くて、これはパラメータ規模の違いを指してます。まずは軽いサイズで起動を確認するのが定番です。
「9bって何の数?」で止まる人が多くて、これはパラメータ規模の違いを指してます。まずは軽いサイズで起動を確認するのが定番です。
室谷代表取締役8GBのM1 MacBook Proで試した記録を見ると、0.8bが22tok/s、2bが16tok/s、4bが7tok/sでCPUオフロードが67%、9bはメモリ超過でタイムアウト。動くかどうかは素直にメモリで決まるんですよね。
UnslothのGGUFはmmprojが分離——Ollamaで動かない理由
室谷代表取締役ここが実務で分岐するポイントで。Unslothが配布しているGGUFを手で落としてくるルートは、Ollamaの公式ライブラリとは別物なんですよ。
ビジョン用のmmprojファイルが分離されているから、現時点ではOllamaだと直接動かない。
ビジョン用のmmprojファイルが分離されているから、現時点ではOllamaだと直接動かない。
テキトー教師DotAI 認定講師現場でよく聞くのが「同じQwen3.5のGGUFなのに、こっちは動くのにこっちは動かない」という混乱で。配布元が違うとファイル構成そのものが違うんですよね。
室谷代表取締役で、その場合はllama.cpp互換のバックエンドを選ぶことになる。モデル名だけ見て同じものだと判断すると、だいたい時間を溶かします。
公式が示す経路はTransformers・vLLM・SGLang・KTransformers
ローカル実行バックエンドの使い分け
Ollama公式ライブラリ
- `ollama run qwen3.5:9b` で起動
- モデル名後ろの数字(0.8b/2b/4b/9b)を替えてサイズ変更
- 初めて触る人向けの一番ラクな入口
- 8GB M1 MacBook Pro: 0.8b=22tok/s、2b=16tok/s、4b=7tok/s(CPUオフロード67%)、9bはメモリ超過でタイムアウト
llama.cpp互換バックエンド
- Unsloth配布のGGUFはmmprojファイルが分離
- 現時点ではOllamaで直接動かない
- mmproj分離のGGUFはllama.cpp互換を選ぶ
- 配布元が違うと同じモデル名でもファイル構成が異なる
室谷代表取締役公式のモデルカードがQuickstartで挙げている経路は、Transformers・vLLM・SGLang・KTransformersの4つなんですよね。
テキトー教師DotAI 認定講師1台で1プロンプト試すのか、サーバーでまとめて捌くのかで選ぶ道具が変わる。vLLMは並列処理を前提にした道具なので、まず動かしてみたいだけならTransformersで足ります。
この辺りは目的から逆算したほうが早いです。
この辺りは目的から逆算したほうが早いです。
室谷代表取締役推論エンジン側がモデル公開と同時に対応を出すかどうかで、実務の導入スピードはかなり変わります。MYUUUでも検証ログは「どのバックエンドで、どの量子化か」までセットで残すようにしてます。
そこが抜けると後から再現できないので。
そこが抜けると後から再現できないので。
必要メモリと量子化——どのサイズをどのPCで動かせるか
サイズ別の必要メモリ、bit数でどこまで変わるか
テキトー教師DotAI 認定講師まず数字の目安を置いておきますね。メモリはRAMとVRAMの合計で見るのが基本です。
0.8Bと2Bは同じ枠で、3bit=3GB、4bit=3.5GB、6bit=5GB、8bit=7.5GB、BF16=9GBという配分になります。
0.8Bと2Bは同じ枠で、3bit=3GB、4bit=3.5GB、6bit=5GB、8bit=7.5GB、BF16=9GBという配分になります。
室谷代表取締役bitを上げると素直に増えるんですよね。同じ9Bでも3bitの5.5GBからBF16の19GBまで、ざっくり3倍以上開くわけで・・・ここで欲張ると一気に載らなくなる。
テキトー教師DotAI 認定講師そうなんです。で、サイズを横に並べるとこうなります。
| モデル | 3bit | 4bit | 6bit | 8bit | BF16 |
|---|---|---|---|---|---|
| 0.8B / 2B | 3GB | 3.5GB | 5GB | 7.5GB | 9GB |
| 4B | 4.5GB | 5.5GB | 7GB | 10GB | 14GB |
| 9B | 5.5GB | 6.5GB | 9GB | 13GB | 19GB |
| 27B | 14GB | 17GB | 24GB | 30GB | 54GB |
| 35B-A3B | 17GB | 22GB | 30GB | 38GB | 70GB |
| 122B-A10B | 60GB | 70GB | 106GB | 132GB | 245GB |
| 397B-A17B | 180GB | 214GB | 340GB | 512GB | 810GB |
室谷代表取締役397BのBF16で810GBって、もう個人のマシンの話じゃないんですよね。手元の構成をどこまで積むか、それとも従量でAPIを買うか、という判断になる。
9B前後までなら手元で完結させた方が長い目で見て安いんですけど、そこから上は素直に外に出す方が筋がいい・・・
9B前後までなら手元で完結させた方が長い目で見て安いんですけど、そこから上は素直に外に出す方が筋がいい・・・
量子化の中身——GGUFとDynamic量子化の考え方
室谷代表取締役さっきのbit数の話って、要は重みを何bitで持つかですよね。量子化の仕組み自体をもう少し聞きたいんですけど、何を削ってるんですか。
テキトー教師DotAI 認定講師GGUFは重みのビット数を下げて、ファイルサイズとメモリ消費をまとめて減らす形式です。荒く削るほど軽くなる代わりに、出力の精度は落ちていきます。
だから安易に一番低いbitを選ぶと、速いのに日本語が怪しい、みたいなことが起きるんですよ。
だから安易に一番低いbitを選ぶと、速いのに日本語が怪しい、みたいなことが起きるんですよ。
室谷代表取締役そこを何とかするのがUnslothのDynamic量子化、という理解で合ってます?
テキトー教師DotAI 認定講師合ってます。全部を均等に削るんじゃなくて、効いてくるレイヤーだけ8bitや16bitで残して、他を低bit化する。
だから同じくらいのファイルサイズでも劣化が穏やかになりやすい、という考え方なんです。迷ったら同じbit数の中でDynamic側を選んでおく、が現場では無難ですね。
だから同じくらいのファイルサイズでも劣化が穏やかになりやすい、という考え方なんです。迷ったら同じbit数の中でDynamic側を選んでおく、が現場では無難ですね。
M1 MacBook Pro 8GBで試した実機の速度と限界
テキトー教師DotAI 認定講師実際に8GBのM1 MacBook Proで回した数字があるので共有しますね。0.8bが22tok/s、2bが16tok/s、4bが7tok/sです。
9bはメモリが足りずにタイムアウトしました。
9bはメモリが足りずにタイムアウトしました。
室谷代表取締役4bで7tok/sって、体感だと待つ側ですよね。CPUに逃がしてる分もあったりします?
テキトー教師DotAI 認定講師まさにそれで、4bはCPUオフロードが67%まで行ってました。その代わり品質は一番いい。
0.8bは速いけど日本語の品質が低い、2bが実用ライン、4bは我慢できるなら品質優先、という並びでした。初めて触る人は、この3つの性格の違いでかなり戸惑います。
0.8bは速いけど日本語の品質が低い、2bが実用ライン、4bは我慢できるなら品質優先、という並びでした。初めて触る人は、この3つの性格の違いでかなり戸惑います。
室谷代表取締役8GBだと現実的な選択肢は2bまで、9bを狙うなら16GB以上、と。マシンを買い替える前に、まず2bで自分の用途に足るかを確かめるのが一番安い検証なんですよね。
用途別のおすすめモデルサイズとAPI料金
テキスト中心か、画像・動画も扱うかで変わる選び方
室谷代表取締役メモリの目安は前の章で出たので、ここは用途から逆算したいんですよね。テキストだけを淡々と回すのか、画像や動画も読ませたいのかで、選ぶべきサイズが変わってきますし。
テキトー教師DotAI 認定講師現場でよく聞くのは「テキスト用なら小さいのを選べばいいんですよね」という前提なんですけど、Qwen3.5は0.8Bから397Bまで、ラインナップ全体が画像と動画を入力できるモデルなんですよ。小さいからテキスト専用、という区切りにはならないんです。
室谷代表取締役そこは面白いところで。うちの現場だと「動画まで扱うならそれなりのサイズが要るよね」という感覚で見てしまうんですが、9Bや4Bの公式ベンチマークにも視覚タスクの数字が並んでいるので、判断材料としてはそこを見るべきなんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこで、テキスト中心なら2Bや4Bで十分回ります。8GBのマシンで4Bが7tok/sで動いた、という検証もありますし、画像・動画も本格的に、となると9B以上が見えてくる感覚です。
Alibaba Cloud Model Studioの単価
用途別おすすめモデルサイズとAPI料金(国際リージョン・100万トークンあたり)
| モデル | 入力 | 出力 | 位置づけ |
|---|---|---|---|
| qwen3.5-flash | $0.1 | $0.4 | 量をさばく用途(分類・要約) |
| qwen3.5-35b-a3b | $0.25 | $2.0 | ローカル可(4bitで22GB) |
| qwen3.5-27b | $0.3 | $2.4 | ローカル可(4bitで17GB) |
| qwen3.5-plus | $0.4 | $2.4(0〜256Kトークン時) | 長文書を丸ごと投入 |
| qwen3.5-122b-a10b | $0.4 | $3.2 | — |
| qwen3.5-397b-a17b | $0.6 | $3.6 | BF16で810GB/4bitで214GB |
室谷代表取締役APIで使う場合の単価、ここで一度きちんと並べておきますか。国際リージョンの100万トークンあたりの数字です。
| モデル | 入力 | 出力 |
|---|---|---|
| qwen3.5-flash | $0.1 | $0.4 |
| qwen3.5-35b-a3b | $0.25 | $2.0 |
| qwen3.5-27b | $0.3 | $2.4 |
| qwen3.5-plus | $0.4 | $2.4(0〜256Kトークン時) |
| qwen3.5-122b-a10b | $0.4 | $3.2 |
| qwen3.5-397b-a17b | $0.6 | $3.6 |
テキトー教師DotAI 認定講師flashの入力$0.1は、量をさばく用途だとかなり効きますね。分類とか要約とか、とにかく呼ぶ回数が多い処理をそこに寄せる、という設計がしやすいです。
室谷代表取締役plusが入力$0.4で出力$2.4、しかも256Kトークンまでの範囲の数字なんですよね。長い文書を丸ごと放り込む使い方だと、この範囲の指定が効いてくる。
出力側が入力の6倍ということは、生成をどれだけさせるかで財布が変わるってことです。
出力側が入力の6倍ということは、生成をどれだけさせるかで財布が変わるってことです。
テキトー教師DotAI 認定講師出力の方が高い、というのは初めて触る人が見落としやすいところなんですよ。長文を書かせる使い方だと、入力の量より出力の量が効いてきますから。
ローカル実行とAPI、逆転するのはどこからか
室谷代表取締役で、自社サーバーで重みを動かすとAPIの従量課金は消えて、コストはインフラ代だけになる。経営目線で言うと、ここは「月いくら固定で持てるか」の勝負になるんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、試す段階ではAPIの方が圧倒的に楽なんですよ。サーバーを用意しなくていいですし。
ローカルは、ずっと回し続ける前提になってから効いてきます。
ローカルは、ずっと回し続ける前提になってから効いてきます。
室谷代表取締役397Bともなると必要メモリがBF16で810GB、4bitでも214GBという規模なので、個人や小さなチームが持つものではないんですよね。27Bなら4bitで17GB、35B-A3Bなら22GB。
このあたりが「自前で持てる線」で、そこから上はAPIに逃がす判断になる。
このあたりが「自前で持てる線」で、そこから上はAPIに逃がす判断になる。
テキトー教師DotAI 認定講師逆転の境目は、そのモデルを一日中どれだけ呼ぶかで決まってきます。たまに呼ぶならAPI、常時ぶん回すならインフラ、という見方で大きく外れないと思います。
Qwen3.6・Qwen3.8との違い——今Qwen3.5を選ぶべきか
Qwen3.6-27B、Qwen3.8-27B、Qwen3.8-Flash-Nextの登場とライセンスの変化
室谷代表取締役前提として、Qwen3.5の上にはもう何世代か載ってるんですよ。Qwen3.6-27Bが2026年4月21日、Qwen3.8-27Bが8月14日、その8月下旬にQwen3.8-Flash-Next。
ここで効いてくるのがライセンスの話なんですよね。
ここで効いてくるのがライセンスの話なんですよね。
テキトー教師DotAI 認定講師そこは見落としやすいんですよ。Qwen3.5は全モデルがApache 2.0で、商用利用も改変も再配布も自由。
Qwen3.8-27BもApache-2.0のままなんですが、Qwen3.8-Flash-NextはQwen Community License 1.0に変わる。同じ「3.8」でも中身が別物なんです。
Qwen3.8-27BもApache-2.0のままなんですが、Qwen3.8-Flash-NextはQwen Community License 1.0に変わる。同じ「3.8」でも中身が別物なんです。
室谷代表取締役これ、業界構造としてかなり象徴的で。重みを配る路線と、APIでしか出さない路線が同じファミリー内で併存し始めてるわけです。
Qwen3.8-MaxとQwen3.8-Flashは重み非公開のAPI専用ですし。この辺の後継フラッグシップの話はAlibaba、Qwen3.8プレビュー公開「Claude Fable 5に次ぐ」2.4兆パラメータで解説しています。
Qwen3.8-MaxとQwen3.8-Flashは重み非公開のAPI専用ですし。この辺の後継フラッグシップの話はAlibaba、Qwen3.8プレビュー公開「Claude Fable 5に次ぐ」2.4兆パラメータで解説しています。
テキトー教師DotAI 認定講師初めて触る人が一番止まるのがまさにそこなんですよ。「同じ3.8って書いてあるけど、どれの話?」って。
名前だけで判断せず、配布形態までセットで見たほうがいいですね。
名前だけで判断せず、配布形態までセットで見たほうがいいですね。
テキスト中心なら9B、24GB以上のVRAMで画像・動画なら27B——乗り換え判断の基準
テキトー教師DotAI 認定講師判断はわりとシンプルで、テキスト中心なら今もQwen3.5-9Bが手軽なんですよ。16GB RAM級のPCなら4bitで6.5GB程度。
27Bを4bitで回すなら17GB要りますから、そもそも土俵が違うんです。
27Bを4bitで回すなら17GB要りますから、そもそも土俵が違うんです。
室谷代表取締役そこは待つコストで考えたほうがよくて。今のマシンで9Bが回ってるなら、乗り換えのために環境を作り直す工数のほうが高くつくケースが多いんですよね。
MYUUUでも、動いてるものをわざわざ止めてまで最新に寄せる場面はそんなにないです。
MYUUUでも、動いてるものをわざわざ止めてまで最新に寄せる場面はそんなにないです。
テキトー教師DotAI 認定講師逆に24GB以上のVRAMがあるなら、画像・動画を扱う前提でQwen3.8-27Bへの切り替えが検討材料になります。Qwen3.5も全モデルが画像・動画を入力できるネイティブなマルチモーダルではあるんですが、上があるなら上を見たくなるのが人情で。
室谷代表取締役なので「後継が出たから待つ」ではなくて、手元のVRAMと、入力がテキストだけかどうかで線を引く。そこで9Bが現役で回っているなら、Qwen3.5を今選ぶ合理性は普通に残ってます。
企業・社内導入でつまずくポイント
サイズ選びは「動くつもり」で詰まる
室谷代表取締役社内導入の相談で一番多いのが、スペック表を希望スペックとして読んでしまうケースなんですよね。9Bなら手元のマシンでも動くでしょ、みたいな。
テキトー教師DotAI 認定講師そこ、現場でよく聞くんですよ。8GBのM1 MacBook Proで試した検証だと、9Bはメモリ超過でタイムアウト、4Bは動くもののCPUオフロードが67%かかったという結果でした。
0.8Bと2Bは軽いんですが、日本語の品質は2Bでようやく実用という体感です。
0.8Bと2Bは軽いんですが、日本語の品質は2Bでようやく実用という体感です。
室谷代表取締役必要メモリはRAMとVRAMの合計目安で、しかも量子化ビット数で変わる。3bitとBF16じゃ桁が違うので、先に「どの量子化で運用するか」を決めないと見積もりが成立しないんですよね。
検証で一日溶かす人件費の方が高くつきます。
検証で一日溶かす人件費の方が高くつきます。
テキトー教師DotAI 認定講師たしかに。表の数字は条件付きだと思って読む。
これが最初の関門ですね。
これが最初の関門ですね。
Ollamaで動くもの、動かないもの
テキトー教師DotAI 認定講師次にハマるのがバックエンドの混同です。Ollamaの公式ライブラリ経由なら qwen3.5:9b でそのまま起動できます。
ただ、Unslothが配布しているGGUFはビジョン用のmmprojファイルが分かれていて、Ollamaでは直接動かず、llama.cpp互換のバックエンドが要るんですよ。
ただ、Unslothが配布しているGGUFはビジョン用のmmprojファイルが分かれていて、Ollamaでは直接動かず、llama.cpp互換のバックエンドが要るんですよ。
室谷代表取締役これ、社内だと「同じモデルの重みでしょ」で議論が噛み合わなくなるやつですね。配布元と形式が違うだけで検証工数が別物になる。
稟議に載せる前に、どの経路で動かすのかを確定させた方がいい。
稟議に載せる前に、どの経路で動かすのかを確定させた方がいい。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。Hugging Faceのモデルカード、Ollamaのライブラリ、量子化版のGGUFを、同じ棚に置いて話してしまう。
室谷代表取締役しかもQwen3.5は全サイズがImage-Text-to-Textに分類されるマルチモーダルなので、画像を入れる前提かどうかでも構成が変わります。テキストだけなら軽い経路で十分ですし。
導入前に決めておくこと、公式を見る習慣
社内導入前の確認フロー
入力に画像や動画を入れますか?
YES / マルチモーダル構成
- 配布元と形式を確認(Ollama公式ライブラリか、Unsloth配布GGUFか)
- GGUFはmmprojが分離しOllamaでは直接動かないためllama.cpp互換バックエンドを用意
- 画像前提の構成で検証工数を再見積もり
NO / テキストのみの軽い経路
- Thinking modeを既定で使うか決める(既定で有効・出力トークン増)
- API従量は出力単価が高いため試算
- 量子化ビット数を先に決めて必要メモリ(RAM+VRAM合計)を見積もる
- ライセンスをモデルごとに確認(Qwen3.5はApache 2.0、後継Flash系はQwen Community License 1.0)
室谷代表取締役導入前に決めるのは、入力に画像や動画を入れるか、Thinking modeを既定で使うか、配布形式をどれにするかの三つ。ここが曖昧だと検証がやり直しになるんですよね。
思考モードは既定で有効なので出力トークンが増えます。APIの従量だと入力より出力の単価が高いので、最初に試算しておきたいところです。
思考モードは既定で有効なので出力トークンが増えます。APIの従量だと入力より出力の単価が高いので、最初に試算しておきたいところです。
テキトー教師DotAI 認定講師ライセンスも先に確認ですね。Qwen3.5は全モデルApache 2.0で商用利用も改変も再配布も可能とされていますが、後継のFlash系はQwen Community License 1.0に変わっていたりするので、モデルごとに見た方が安全です。
室谷代表取締役あとモデルカードは更新されるので、導入時点で一度読み直す。後継も次々出ていて、Qwen3.8プレビューの話を見ても世代の入れ替わりが速い。
四半期に一度は定点観測するくらいがちょうどいい。
四半期に一度は定点観測するくらいがちょうどいい。
テキトー教師DotAI 認定講師最初に全部決め切ろうとせず、確認項目だけ先に並べておく。結局それが一番早いですね。
よくある質問
Q1. Qwen3.5とQwen2.5は何が違うんですか?
テキトー教師DotAI 認定講師世代が上がると、同じサイズでも指示の聞き方や長い文脈の扱いが変わってくるんですよね。現場感覚だと、2.5で作ったプロンプトがそのまま効かないこともあるので、そこは一度触って確かめた方が早いです。
室谷代表取締役乗り換えコストを見るなら、モデルの差より「今動いてる仕組みをどこまで変えずに済むか」なんですよね。互換の確認を先にやるか、新規のユースケースから試すかで判断が割れます。
テキトー教師DotAI 認定講師たしかに。既存の本番をいきなり替えるより、比較用の環境で並べるのが安全ですね。
Q2. 日本語の性能はどうなんですか?
室谷代表取締役日本語の評価は、公開されている指標より自社の文書で見た方が早いんですよ。用語の揺れが多い資料ほど差が出ますからね。
テキトー教師DotAI 認定講師初めて触る人は、翻訳みたいな分かりやすいタスクから始めると違いが見えます。敬語や固有名詞は、プロンプトで調整する前提で考えた方がいいですね。
室谷代表取締役比較対象を絞らないと時間が溶けるので、同じプロンプトで2〜3個だけ並べるのがちょうどいいんですよね。
Q3. 商用利用はできますか?ライセンスはどうなってます?
テキトー教師DotAI 認定講師ここはモデルごとに条件が違うので、配布ページのライセンス表記を見るのが一番確実です。サイズ違いで条項が変わることもあるので、使うモデル単位で確認した方がいいですね。
室谷代表取締役法務が止めるかどうかで導入のスピードが変わるので、最初にライセンスの確認を通しておくのが結局は速いんですよ。
テキトー教師DotAI 認定講師導入の場面でも「動くか」より「配布できるか」で止まるケースがありますからね。
Q4. ファインチューニングはできますか?
室谷代表取締役できるかどうかは、ベースモデルが公開されているかと、どの提供形態で使うかで変わります。API経由だと調整できる範囲が限られるので、そこは前提を揃えてから議論したいところです。
テキトー教師DotAI 認定講師最初に戸惑うのが、量子化したモデルをそのまま学習に回せると思ってしまうパターンですね。配布物の種類を確認するのが先です。
室谷代表取締役追加学習まで視野に入れるなら、推論用のセットアップとは別に環境を分けた方がいいですね。
Q5. ClaudeやGeminiとどう使い分ければいいですか?
テキトー教師DotAI 認定講師現場でよく聞くのは「結局どれが一番いいの?」なんですけど、モデルの得意分野より、運用の形で選ぶ方が現実的です。APIで完結させたいのか、ローカルに置きたいのかで候補が変わります。
室谷代表取締役ベンダーロックを避けたいなら、インターフェースを揃えて差し替えられるようにしておくのが定石なんですよね。品質の比較は、その後の話です。
テキトー教師DotAI 認定講師たしかに。最初から一つに決め打ちしない方が、後の検証が楽になりますね。
まとめ
室谷代表取締役Qwen3.5、モデルの層が分かれているので「どれが一番強いか」より「どの層が自分の制約に合うか」で見た方が早いんですよね。メモリなのか、コストなのか、精度なのか、先に制約を決める。
テキトー教師DotAI 認定講師慣れていないうちは、最初から大きいサイズに行くより、小さいので当たりをつけてから上げる方がつまずきにくいです。量子化の違いも、動かしながら覚える方が早いですね。
室谷代表取締役あと、APIとローカルはどっちかに決めなくていいんですよ。検証はローカル、本番はAPIみたいに分けると、コストも調整しやすい。
テキトー教師DotAI 認定講師まずは自分の業務から一つタスクを選んで、同じプロンプトで比べてみるのがいいですね。それが一番、判断材料になります。