Ollamaとは何か。ひとことで言うと何をするソフト?
自分のPCにモデルを落として動かすためのランタイム
 室谷代表取締役
Ollamaって、ひとことで言うと何なのか。ここが一番ぼんやりしやすいところなんですよね。
自分のPCにモデルをダウンロードして、手元で動かすためのランタイム、というのが一番近いと思います。
自分のPCにモデルをダウンロードして、手元で動かすためのランタイム、というのが一番近いと思います。
 テキトー教師DotAI 認定講師
そこが最初の引っかかりなんですよ。アプリというより「土台」なんですね。
モデルを動かすための入れ物というか、コンセントみたいな存在というか。
モデルを動かすための入れ物というか、コンセントみたいな存在というか。
室谷代表取締役そう、モデルそのものではないんですよ。LlamaとかGemma、Qwen、DeepSeekみたいなオープンなモデルを取ってきて、それを自分のマシンの上で動かす側。
だからOllamaを入れても、頭脳が付いてくるわけじゃないんですよね。
だからOllamaを入れても、頭脳が付いてくるわけじゃないんですよね。
テキトー教師DotAI 認定講師初めて触る人がよく言うのが「ChatGPTと同じものですか?」なんですけど、ChatGPTはサービス名で、Ollamaは手元で動かすためのソフト。この分け方にすると一気に整理されます。
中身はllama.cpp
室谷代表取締役中身の話をすると、推論のエンジンはllama.cppなんですよね。Georgi Gerganovさんが作ったやつが土台になってる。
テキトー教師DotAI 認定講師そこで繋がるんですね。名前だけ聞くと別物に見えるんですけど、中で回ってるものの系譜は同じなんだ。
室谷代表取締役だからGPUが無くてもCPUだけで動かせる。ここが実務的に効くところで、わざわざ重い構成を用意しなくても試せるんですよ。
対応するGPUがあればそっちを使って速くなる、という順番ですね。
対応するGPUがあればそっちを使って速くなる、という順番ですね。
テキトー教師DotAI 認定講師現場感覚で言うと、まず手元で一度動かしてみる、という時のハードルを下げてくれるのが大きいですね。ここで止まる人がすごく多いので。
対応OSと本体ライセンス
室谷代表取締役対応OSはmacOS、Windows、Linux。インストールはコマンド1本で終わるんですよね。
あとはソフトウェア本体のライセンスがMITで、商用利用も含めて無料なんですよ。
あとはソフトウェア本体のライセンスがMITで、商用利用も含めて無料なんですよ。
テキトー教師DotAI 認定講師ライセンスがMITというのは、社内で説明するときに助かります。「これ入れて大丈夫なの?」と必ず聞かれるので、本体は自由に使えると答えられるだけで話が進みます。
室谷代表取締役ただし、本体がMITでもモデル側の規約は別なんですよ。GemmaにはGemmaの利用規約があるし、Llamaもコミュニティライセンス。
業務で使うなら、モデルごとに配布元の条件を確認しないといけない・・・ここは切っても切れない関係なんですよね。
業務で使うなら、モデルごとに配布元の条件を確認しないといけない・・・ここは切っても切れない関係なんですよね。
テキトー教師DotAI 認定講師そこ、混同する人が多いんですよ。「Ollamaが無料」と「そのモデルが商用利用OK」は別の話、と分けて覚えておくと事故りません。
クラウドAIとの立ち位置の違い
室谷代表取締役立ち位置としては、クラウドのAIに投げる代わりに、手元で完結させる選択肢を増やすものなんですよ。ローカルで動かす分は課金が発生しないので、コストの読みが立てやすい。
テキトー教師DotAI 認定講師逆に、手元のマシンの性能がそのまま上限になる。何でもできる魔法ではない、という前提は最初に共有しておきたいですね。
室谷代表取締役経営目線で言うと、常用している軽い推論をローカルに逃がせるだけで、外に出る固定費の見通しが穩やかになる。全部を置き換える話じゃなくて、住み分けの話なんですよね。
ChatGPTを手元で動かす構成についてはChatGPTをローカルで動かす完全ガイドでも触れられているので、そちらも参考になります。
ChatGPTを手元で動かす構成についてはChatGPTをローカルで動かす完全ガイドでも触れられているので、そちらも参考になります。
テキトー教師DotAI 認定講師なるほど。クラウドが向いてる仕事と、手元で済ませたほうがいい仕事を分けて考える。
その最初の一歩がOllama、という理解でよさそうです。
その最初の一歩がOllama、という理解でよさそうです。
インストールは何分で終わる?OS別の手順を並べる
OS別インストール手順
- 01macOS / Linuxターミナルを開き curl -fsSL https://ollama.com/install.sh | sh を実行。終了後 ollama run gemma4 でチャットが始まれば成功
- 02Windows(PowerShell)PowerShellを開き irm https://ollama.com/install.ps1 | iex を実行
- 03Windows(インストーラ)公式サイトからインストーラをダウンロードしてそのまま実行
- 04DockerDocker Hubから公式イメージ ollama/ollama を取得し、起動してホスト側から使える状態にする
macOSとLinuxはコマンド1行で入る
- ターミナルを開く
curl -fsSL https://ollama.com/install.sh | shを実行する- 終わったら
ollama run gemma4を叩いて、モデルが落ちてきてチャットが始まれば成功
室谷代表取締役macOSとLinuxはこれでおしまいなんですよね。うちでも新しいマシンが届いたら、まずこの1行を打つところから始まります。
テキトー教師DotAI 認定講師初めて触る人がいちばん身構えるところで、「本当に1行で入るんですか」と何度も聞かれました。実際そのまま動きます。
室谷代表取締役拍子抜けして「これだけ?」で終わる。導入のハードルが下がるのは、ツールを選ぶ側からしてもありがたい話です。
WindowsはPowerShellかインストーラを選ぶ
- PowerShellを開く
irm https://ollama.com/install.ps1 | iexを実行する- もしくは公式サイトからインストーラをダウンロードして、そのまま実行する
テキトー教師DotAI 認定講師Windowsは2択なんですよね。黒い画面に慣れていない人はインストーラ、社内で手順を揃えたいならPowerShellの1行、という選び方になります。
室谷代表取締役その「どっちでもいい」を片方に決めてもらえると助かるんですよ。手順書は分岐が増えるほど事故るので。
現場でよく聞くのは、古い手順のまま進めて詰まるパターンですね。
現場でよく聞くのは、古い手順のまま進めて詰まるパターンですね。
Dockerで動かしたい場合のイメージ取得
- Docker Hubから公式イメージ
ollama/ollamaを取得する - 取得したイメージを起動して、ホスト側から使える状態にする
室谷代表取締役Dockerの場合は、公式イメージがDocker Hubに公開されているのでそこから引っ張る形になります。手元の環境を汚さずに試せるのが大きい。
テキトー教師DotAI 認定講師GPUをどう通すかで最初に戸惑う人が多いんですよ。ここは環境ごとに違うので、公式ドキュメントを見ながらの作業になります。
室谷代表取締役あと、イメージを揃えておくとチームで同じ状態を再現できる。検証環境のブレで半日溶かす、みたいな無駄が消えるのは地味に効きます。
テキトー教師DotAI 認定講師たしかに。個人で試す分にはコマンド1行で足りる話なので、まずは素直にインストールでいいと思います。
モデルの保存先と置き場所の変え方
既定の保存先は次のとおりです。
| OS | 保存先 |
|---|---|
| macOS | ~/.ollama/models |
| Linux | /usr/share/ollama/.ollama/models |
| Windows | C:\Users\%username%\.ollama\models |
室谷代表取締役で、先に押さえておいてほしいのがこの保存先なんですよ。モデルは1個で数GB級になるので、容量の薄いノートに何本も落とすと普通に埋まります。
テキトー教師DotAI 認定講師ここ、後から気づく人が多いところで。変えたいときは環境変数
OLLAMA_MODELS で指定できます。室谷代表取締役最初に置き場所だけ決めておけば、後で泣かずに済む。ディスクに余裕のない現場だと、外付けに逃がすかどうかが最初の判断になりますからね。
基本の使い方は?モデルの実行と管理コマンド
runでモデルを落としてチャットを始める
runでモデルを取得してチャット開始
- 01ターミナルを開くインストール後にターミナルを起動する
- 02ollama run <モデル名> を実行例: ollama run gemma4
- 03自動ダウンロードとチャット開始手元に無いモデルは自動で取得され、そのまま会話が始まる
- 04初回のみ待ち時間が長い2回目以降はローカルの分だけ読むため立ち上がりは一瞬
- ターミナルを開く
ollama run <モデル名>を実行する(例:ollama run gemma4)- 手元に無いモデルは自動でダウンロードされ、そのままチャットが始まる
室谷代表取締役インストールが終わったら、次はターミナルで
ollama run gemma4 って打つだけなんですよね。モデルが無ければ自動で落としてきて、そのまま会話が始まる。テキトー教師DotAI 認定講師そうなんです。初めて触る人は「先にダウンロード用のコマンドを調べなきゃ」と身構えるんですが、runひとつで取得と起動がまとめて走ります。
最初に戸惑うのが、初回だけ待ち時間が長いところですね。
最初に戸惑うのが、初回だけ待ち時間が長いところですね。
室谷代表取締役なるほど。2回目以降はローカルにある分だけ読むから、立ち上がりは一瞬だと。
テキトー教師DotAI 認定講師はい。初回だけ待って、以降はすぐ返ってくる。
ここで「壊れたかな」と不安になる必要はないんですよ。
ここで「壊れたかな」と不安になる必要はないんですよ。
pullとpsとstopでモデルを管理する
室谷代表取締役ダウンロードだけ先に済ませたいときは
ollama pull <モデル名>、今どれが動いているか見たいときは ollama ps、止めたいときは ollama stop <モデル名>。まずはこの3つを覚えておけば十分で、削除や一覧表示といった管理コマンドは必要になったら足していけばいい。テキトー教師DotAI 認定講師ps が地味に便利なんですよ。GPUとCPUのどちらに何%載っているかまで出るので、「なんだか遅いな」と思ったときに原因の当たりがつきます。
室谷代表取締役それは大きいですね。遅さの原因がモデル側なのか載り方なのか、切り分けられるだけで調査にかかる時間が変わってくる。
テキトー教師DotAI 認定講師現場感覚で言うと、重いモデルをいくつも入れっぱなしにして「PCが重い」となるケースが多いので、使い終わりに stop で閉じる癖をつけると平和になります。
5分でメモリから外れる仕組みとkeep_alive
室谷代表取締役既定では5分でメモリから外れる、と。これは知らないと「なんで毎回初回みたいに遅いんだ」になりそうです。
テキトー教師DotAI 認定講師そうなんです。5分触らないと解放されて、次の一発目でまた読み込みが入ります。
APIとして使うときは
APIとして使うときは
keep_alive パラメータで保持時間を変えられるので、連続で叩く処理なら延ばす、たまにしか使わないなら短くする、という調整になります。室谷代表取締役検証機を1台で共有していると、誰かのモデルが居座るだけで待ちが出るので、そこは運用ルールで決めたいところですね。
テキトー教師DotAI 認定講師たしかに。逆にデモのように続けて見せる場面は延ばしておくと、待ち時間が出なくて済みます。
コンテキスト長を変えたいときの設定
- 常に変えたい場合は、環境変数
OLLAMA_CONTEXT_LENGTHを設定してから起動する - その場だけ変えたい場合は、実行中に
/set parameter num_ctxを指定する
室谷代表取締役コンテキスト長の話も出ましたが、既定は4096トークンなんですよね。長い資料を読ませたいときは足りなくなる。
テキトー教師DotAI 認定講師はい。上のどちらかで広げられます。
ただし広げるほどメモリを食うので、マシンの余裕と相談になりますね。
ただし広げるほどメモリを食うので、マシンの余裕と相談になりますね。
室谷代表取締役上げれば正義、ではないと。
テキトー教師DotAI 認定講師そこ、最初に戸惑うところで。数字を大きくすれば賢くなるわけではなくて、あくまで「一度にどこまで覚えていられるか」の話なんですよ。
モデルはどれを選ぶ?パラメータ数とPCスペックの関係
モデルライブラリには何が並んでいるのか
室谷代表取締役配布ページを開くと、Kimi、GLM、MiniMax、DeepSeek、gpt-oss、Qwen、Gemma・・・って、かなり数が並んでるんですよ。同じ系統でも大きさ違いがいくつも置いてあるので、最初に「どれ」で止まる人が多いはずなんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのもまさにそこですね。名前で選ぶんじゃなくて、日本語が欲しいのか、コードが欲しいのか、軽さ優先なのかで絞ると一気に候補が減ります。
室谷代表取締役うちの現場だと、まず軽いのを一度動かしてみて、物足りなければ上げる順番なんですよ。最初から一番大きいのに行くと、待ち時間でだいたい心が折れるんですよね。
テキトー教師DotAI 認定講師サイズとVRAMの目安、足りないと何が起きる
室谷代表取締役判断材料はモデルのサイズと、手元のメモリ・VRAMの勝負なんですよね。公式のクイックスタートだと、7.2GBのモデルに8GB以上のVRAMか統合メモリを推奨してる。
この数字がそのまま目安になります。
この数字がそのまま目安になります。
テキトー教師DotAI 認定講師ここが分かりやすいようで分かりにくくて。足りないとエラーで落ちるというより、システムRAM側に回って、動くけど遅い、という形で効いてくるんですよ。
室谷代表取締役遅いのは地味に痛いんですよ。一回の応答が数十秒違うだけで、作業の合間に挟めなくなる。
パラメータ数が増えればサイズも重くなるので、上を狙うほどメモリを見ないといけない。
パラメータ数が増えればサイズも重くなるので、上を狙うほどメモリを見ないといけない。
テキトー教師DotAI 認定講師実際どこに載ってるかは
ollama ps でGPUとCPUの比率が見えるので、まずそこを確認するのが早いです。NVIDIA・AMD・AppleでGPU対応はどう違う?
室谷代表取締役で、ここが一番ハマるポイントで。GPUで速く動かすための条件が、ベンダーごとに全然違うんですよね。
テキトー教師DotAI 認定講師NVIDIAはcompute capability 5.0以上でドライバ550以降、5.0〜6.2の範囲はドライバ570以降が必要という分岐があるので、古めのカードだとそこで詰まります。
室谷代表取締役AMDはROCmのv7系ドライバが要る、AppleはMetal経由でGPUを使う。同じ「GPUあり」でも前提が違うので、社内でPCを揃えるときは型番単位で潰していく必要があるんですよ。
テキトー教師DotAI 認定講師型番で当たり外れが出ますからね。細かい条件は公式の対応表を見た方が確実です。
GPUが無くてもCPUだけで動かせるのか
室谷代表取締役で、GPUが無いと動かないのかというと、そうでもない。CPUのみでも動くし、対応外のGPUはVulkan経由で拾える場合もある。
テキトー教師DotAI 認定講師たしかに。ただ速度は落ちる前提で、まず試すには十分だけど常用するなら覚悟がいる、という温度感です。
室谷代表取締役会社で配るPCの選定って、ここで差が出るんですよ。全員にGPU付きを配るのか、重い処理だけ共有マシンに寄せるのか。
ROIで見ると後者の方が現実的だったりします。
ROIで見ると後者の方が現実的だったりします。
テキトー教師DotAI 認定講師最初の一台で全部まかなおうとしない方がいい、というのは見ていて感じますね。
ChatGPTやClaudeとどう違う?ローカルのメリットと限界
ローカルLLMとクラウド(ChatGPT/Claude)の違い
ローカル
- オフラインでも動く
- Ollama本体はMITライセンスで無料、回数制限なし
- プロンプトも回答も外に出ない(公式FAQ)
- 機密性の高い案件でも導入しやすい
- 学習時点の知識で止まり最新情報は苦手
- PCのメモリに収まるサイズのモデルしか動かない
- 自分で選んだモデルが残り続ける(放っておくと古いまま)
- 手軽さ・モデル管理・すぐAPIサーバー化はOllamaが強い
- 素の推論速度はllama.cppの方が速い場合がある
クラウド(ChatGPT/Claude)
- 最新情報を前提として埋めてくれる
- 大きいモデルが使える
- 向こう側でモデルが入れ替わっていく
- 最新の話題や精度が要る場面に向く
オフラインで動く・無料・データが外に出ない
室谷代表取締役ローカルの一番わかりやすい利点は、ネットに繋がっていなくても動くことなんですよね。Ollama本体はMITライセンスで無料、ローカル実行なら回数の制限もない。
テキトー教師DotAI 認定講師そこは初めて触る人が一番びっくりする部分で。料金メーターを気にせず投げられるので、試行錯誤の量そのものが変わります。
室谷代表取締役データの扱いも大きいです。ローカルで動かしているときはプロンプトも回答も外に出ない、と公式のFAQに書かれていて。
機密性の高い案件を抱えている会社だと、ここが導入判断の分かれ目になります。
機密性の高い案件を抱えている会社だと、ここが導入判断の分かれ目になります。
テキトー教師DotAI 認定講師現場でも「顧客情報を貼ってもいいのか」で手が止まるケースが多いので、その迷いが消えるのは心理的にデカいですね。
最新情報に弱く、大きいモデルは載らない
室谷代表取締役反面、弱いところもはっきりしてます。モデルは学習した時点の知識で止まるので、最近の出来事は答えられない。
そこはクラウド側が前提として埋めてくれる部分です。
そこはクラウド側が前提として埋めてくれる部分です。
テキトー教師DotAI 認定講師大きいモデルが載らないのも現実で。PCのメモリに収まるサイズしか動かないので、精度で選ぶというより「このマシンで動く中で一番マシなもの」を選ぶ感覚になります。
室谷代表取締役あとクラウドは向こう側でモデルが入れ替わっていくけど、ローカルは自分で選んだものが残り続ける。安定する反面、放っておくと古いまま、という。
テキトー教師DotAI 認定講師たしかに。一度入れたらそのまま、という人は多いので、定期的に見直す前提で考えた方がいいですね。
速さはllama.cpp素の方が上という現場の声
室谷代表取締役速度の話、現場だとどうなんですか。
テキトー教師DotAI 認定講師ローカルLLMを業務で使ってる人の投稿でよく見るのが、セットアップの楽さとモデル管理、すぐAPIサーバーとして使える点はOllamaが強いけれど、素の推論速度はllama.cppの方が速い場合がある、という比較です。手軽さと速さは別の軸なんですね。
室谷代表取締役なるほど。そこは用途で割り切る話で、触りながら試す段階では手軽さの価値が勝つ。
環境構築に人件費をかける方が高くつくので、経営目線だと最初の判断はそっちになります。
環境構築に人件費をかける方が高くつくので、経営目線だと最初の判断はそっちになります。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよ。「Ollamaを入れたのに速くならない」ではなく、中で動いているエンジンが違う、という前提を持つと納得できます。
結局どちらを使うべきかの線引き
室谷代表取締役整理すると、外に出したくない情報を扱うとき、ネットが無い場所、そして軽い推論を大量に回したいときはローカル。最新の話題や精度が要る場面はクラウド。
この住み分けが現実的です。
この住み分けが現実的です。
テキトー教師DotAI 認定講師軽い処理だけをローカルに逃がして、重いところはクラウドに残す、という使い方をしてる実務者の声もありますよね。全部をどちらかに寄せない方がいい。
室谷代表取締役テキトー教師DotAI 認定講師最初から完全に切り替えようとせず、片方ずつ試して線を決めていくのが結局は近道ですね。
Ollamaは完全無料?クラウド版の料金プランまで確認する
ローカル実行は無料・無制限という大前提
室谷代表取締役まず料金の話なんですけど、Ollamaって本体がMITライセンスで、自分のPCで動かす分には完全に無料なんですよね。回数制限もない。
ここを先に押さえないと、クラウドの話とごっちゃになるんですよ。
ここを先に押さえないと、クラウドの話とごっちゃになるんですよ。
テキトー教師DotAI 認定講師たしかに。初めて触る人は「無料と書いてあるけど、どこかで課金されるのでは」と身構えるみたいで。
手元のマシンで回している限り、財布は痛まないですね。
手元のマシンで回している限り、財布は痛まないですね。
室谷代表取締役ただモデルのライセンスは別なんですよね。GemmaもLlamaも配布元の規約があるので、業務で使うならそこを確認する。
ソフトが無料なのと、そのモデルを商用利用できるかは別問題なんです。
ソフトが無料なのと、そのモデルを商用利用できるかは別問題なんです。
テキトー教師DotAI 認定講師そこ、ハマる人多いんですよ。道具が無料だから何でも自由に使える、と短絡しちゃう。
動かすモデルごとに条件が違う、という感覚を持っておくと安全です。
動かすモデルごとに条件が違う、という感覚を持っておくと安全です。
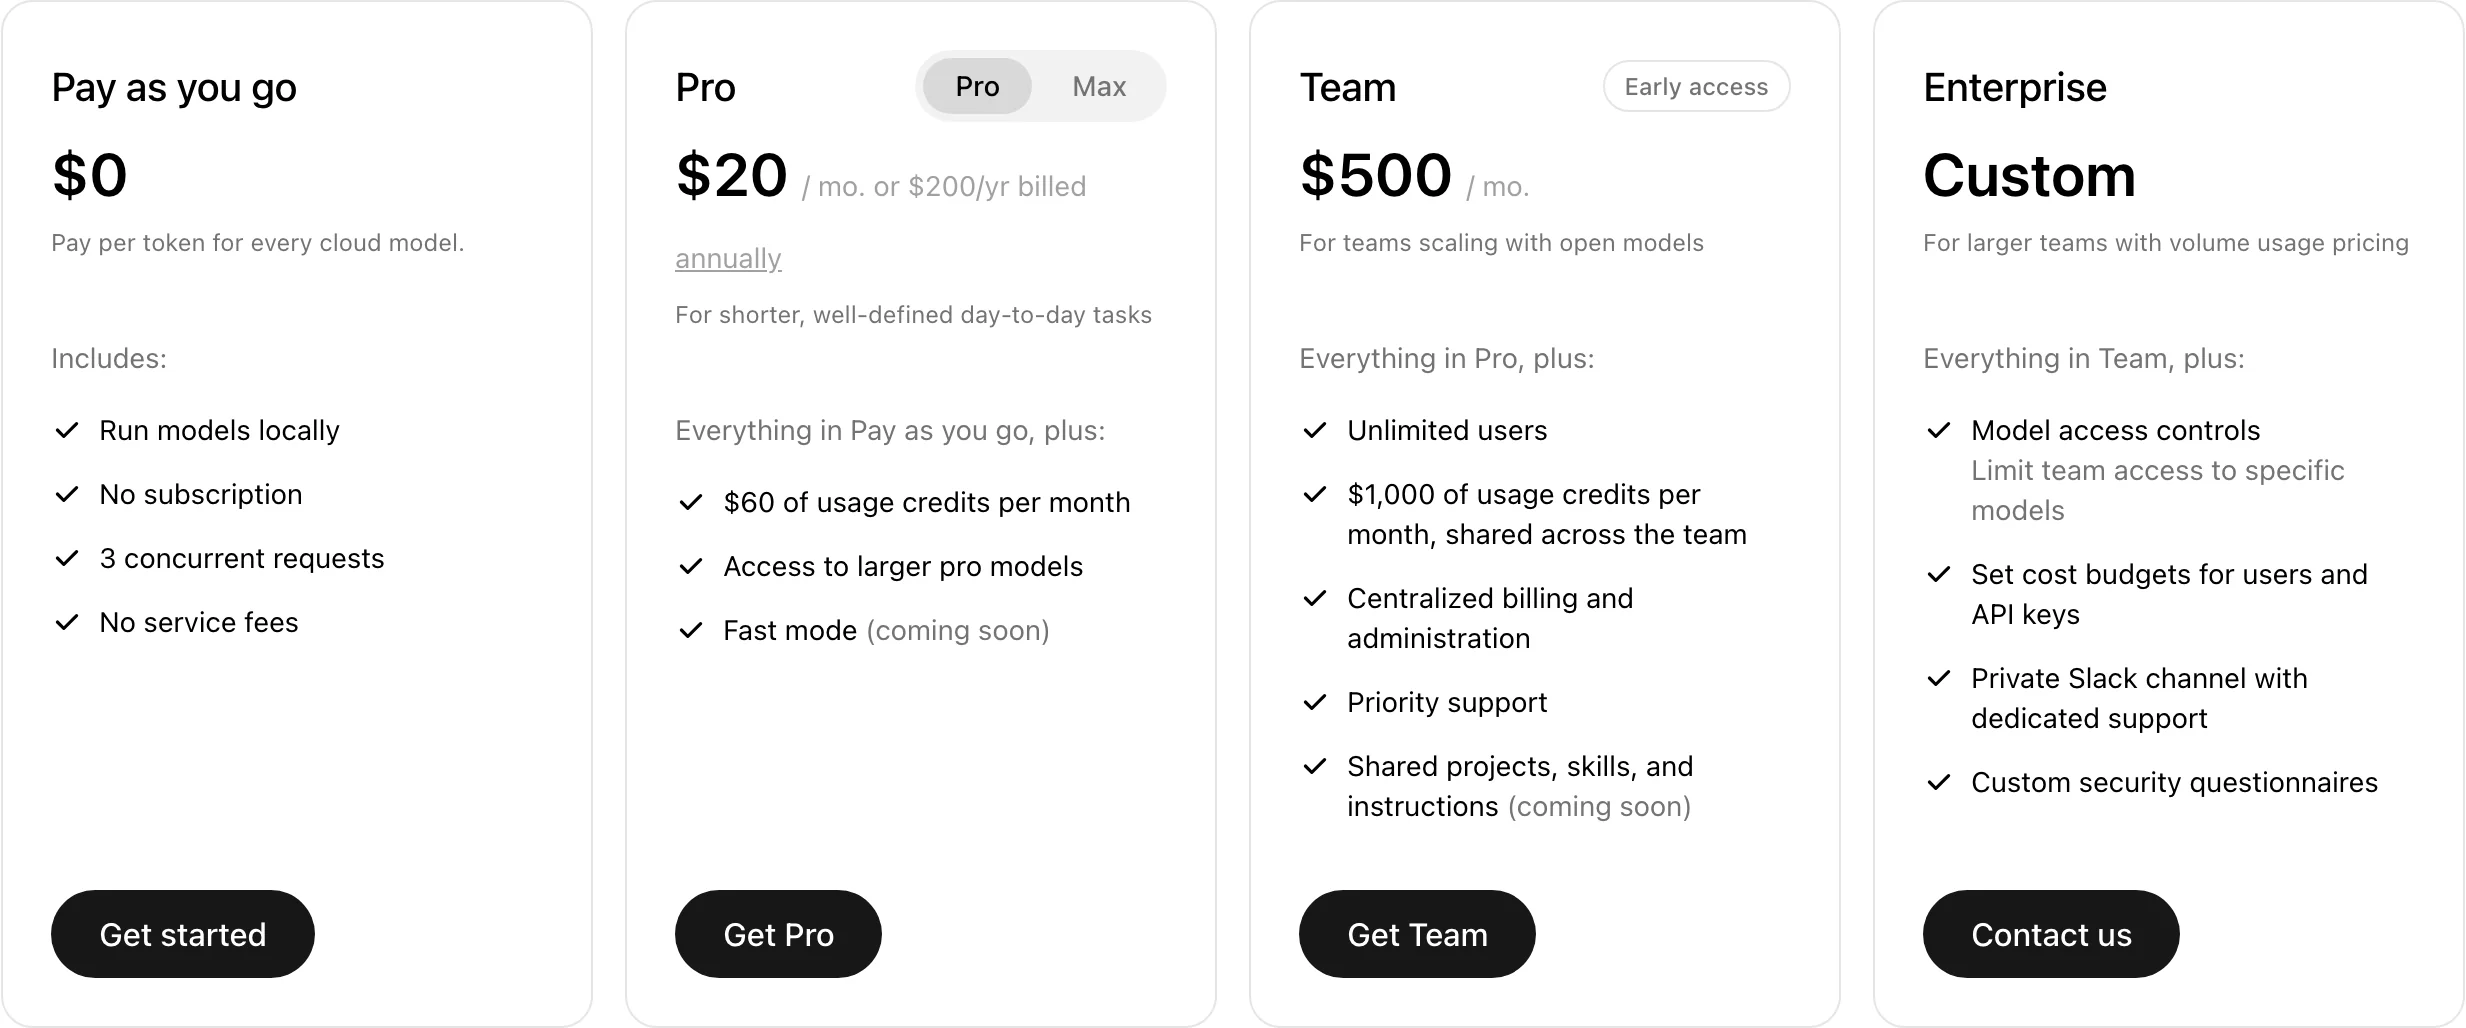
Freeと従量課金、Pro・Max・Teamの違いを金額で見る
室谷代表取締役で、クラウド側ですね。2026年8月に透明な従量課金へ統一されていて。
金額で並べた方が早いので、表にしますか。
金額で並べた方が早いので、表にしますか。
テキトー教師DotAI 認定講師お願いします。数字が並ぶと一気に判断しやすくなりますから。
| プラン | 月額 | 付与クレジット / 主な違い |
|---|---|---|
| Free | 無料 | 対象モデルに毎月少量の無料枠 |
| Pay as you go | $0 | 使った分だけトークン課金・同時実行3件・サービス料なし |
| Pro | $20(年払い$200) | 毎月$60分のクレジット・より大きなProモデルへアクセス |
| Max | $100 | 毎月$300分・同時実行10件・新モデルへの早期アクセス |
| Team | $500 | 組織で共有する毎月$1,000分・一括請求と管理機能 |
| Enterprise | 要問い合わせ | モデルアクセス制限・コスト予算設定・専用サポート |
室谷代表取締役見方はシンプルで、Freeは毎月の少量枠、Pay as you goは月額0で使った分だけ。Proが20ドルで60ドル分、Maxが100ドルで300ドル分、Teamが500ドルで組織共有1000ドル分なんですよね。
テキトー教師DotAI 認定講師クレジットの額だけ見るとProが得に見えるんですが、同時実行数が3件か10件かで、並列で回す人の体感はかなり変わります。クラウドのデータ保持やホスト地域まで見たい人はOllama Cloudの料金体系の解説が参考になります。
毎月のクレジットは翌月に持ち越せない
室谷代表取締役ここ、経理目線だと地味に効くんですけど、毎月のクレジットは翌月に繰り越せないんですよ。使わなかった分は消える。
余らせる前提でプランを選ぶと、そのぶん損になるんですよね。
余らせる前提でプランを選ぶと、そのぶん損になるんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、月末に慌てて使い切ろうとする動きが出がちで。最初は小さく始めて、実際の消費を見てから上げる方が落ち着きます。
室谷代表取締役ええ。いきなりMaxにするより、Proで1ヶ月走らせて消費量を観測する。
ROI で言えば、その観測にかかるコストの方がずっと安いんですよ。
ROI で言えば、その観測にかかるコストの方がずっと安いんですよ。
クラウドでもプロンプトは学習に使われない
テキトー教師DotAI 認定講師クラウドを使うと「入力した内容、どこかに残りませんか」という不安が出るんですよね。ここが最初の関門になりがちです。
室谷代表取締役そこは公式が明示していて、クラウド利用時もプロンプトとレスポンスは記録・学習に使われない、と。ホストは米国とヨーロッパなんですよね。
テキトー教師DotAI 認定講師なるほど。社内データを扱う人が最初に確認したい点なので、明言されているのは大きいですね。
ゼロデータ保持という整理で語られているので、そこだけ押さえておくと社内説明もしやすいです。
ゼロデータ保持という整理で語られているので、そこだけ押さえておくと社内説明もしやすいです。
データを外に出したくない人のための完全ローカル固定設定
設定ファイルに一行書いてクラウド機能を止める
室谷代表取締役前の章で料金の話をしたので、ここは「そもそも外に出したくない」人の設定を。Ollama って既定だとクラウド側のモデルやWeb検索も呼べる状態なんですよね。
テキトー教師DotAI 認定講師そうなんです。で、初めて触る人がまず見落とすのが設定ファイルの存在で。
手順はこの3つだけです。
手順はこの3つだけです。
~/.ollama/server.jsonをエディタで開く(無ければ新規に作成){"disable_ollama_cloud": true}を書いて保存する- Ollama を再起動して設定を読み込ませる
室谷代表取締役ファイル一行でクラウド機能ごと切れる、と。情シスに出す稟議の資料としても楽なんですよね。
「この設定を入れてます」で説明が終わるので。
「この設定を入れてます」で説明が終わるので。
テキトー教師DotAI 認定講師現場でよく聞くのは「設定したのにクラウドのモデル名を指定してしまって動かない」というパターンです。ローカルで落としたモデル名を指定する、そこだけ気をつければ大丈夫です。
環境変数で無効化する道もある
テキトー教師DotAI 認定講師設定ファイルを触りたくない、あるいは複数マシンで一括して揃えたい場合は環境変数でもいけます。
- macOS / Linux の場合、
OLLAMA_NO_CLOUD=1を環境変数として設定する - Windows の場合は OS の環境変数設定から同じ名前で
1を設定する(画面の場所は公式ドキュメントで確認を) - Ollama を再起動する
室谷代表取締役なるほど、こちらは起動環境ごと縛るイメージですね。配布する端末が何十台もあると、ファイルを1台ずつ置いて回るより環境変数を配るほうが現実的というのは現場あるあるです。
テキトー教師DotAI 認定講師たしかに。どちらか一方だけ入れておけば、クラウド側のモデルもWeb検索も使わない前提で動くようになります。
両方入れても害はないので、私は両方書いてます。
両方入れても害はないので、私は両方書いてます。
ローカル実行ならプロンプトは送られない
室谷代表取締役ここが一番大事なんですが、ローカルで動かしている間、プロンプトやデータが ollama.com に送られることはない、と公式のFAQに書かれてます。
テキトー教師DotAI 認定講師最初に「入力した内容って学習に使われないんですか」と聞かれることが多くて。ローカル実行なら送信自体が起きない、という整理で答えてます。
クラウド版も記録・学習には使わず米国とヨーロッパでホスト、という説明ですが、その詳細はクラウド版の料金とデータの扱いの解説にまとめてあります。
クラウド版も記録・学習には使わず米国とヨーロッパでホスト、という説明ですが、その詳細はクラウド版の料金とデータの扱いの解説にまとめてあります。
室谷代表取締役ソフト本体はMITライセンスで商用利用も無償。ただし動かすモデル側のライセンスは配布元ごとに違うので、業務利用のときはモデル単位で確認が要るんですよね。
ここを混同すると後で揉めるやつです。
ここを混同すると後で揉めるやつです。
テキトー教師DotAI 認定講師そうですね。設定でクラウドを切り、モデルの規約を確認する。
この2つが揃って初めて「社内のオフライン要件を満たしました」と言える感じがします。
この2つが揃って初めて「社内のオフライン要件を満たしました」と言える感じがします。
APIサーバーとして使える?外部ツールとエージェント連携
localhost:11434で立つ3系統のAPIエンドポイント
室谷代表取締役Ollamaって、起動するとローカルにAPIサーバーが立つんですよ。[http://localhost:11434。
これがかなり効いてて、チャットアプリとしてより、APIの土台として見たほうが腹落ちするんですよね。](http://localhost:11434%E3%80%82%E3%81%93%E3%82%8C%E3%81%8C%E3%81%8B%E3%81%AA%E3%82%8A%E5%8A%B9%E3%81%84%E3%81%A6%E3%81%A6%E3%80%81%E3%83%81%E3%83%A3%E3%83%83%E3%83%88%E3%82%A2%E3%83%97%E3%83%AA%E3%81%A8%E3%81%97%E3%81%A6%E3%82%88%E3%82%8A%E3%80%81API%E3%81%AE%E5%9C%9F%E5%8F%B0%E3%81%A8%E3%81%97%E3%81%A6%E8%A6%8B%E3%81%9F%E3%81%BB%E3%81%86%E3%81%8C%E8%85%B9%E8%90%BD%E3%81%A1%E3%81%99%E3%82%8B%E3%82%93%E3%81%A7%E3%81%99%E3%82%88%E3%81%AD%E3%80%82)
これがかなり効いてて、チャットアプリとしてより、APIの土台として見たほうが腹落ちするんですよね。](http://localhost:11434%E3%80%82%E3%81%93%E3%82%8C%E3%81%8C%E3%81%8B%E3%81%AA%E3%82%8A%E5%8A%B9%E3%81%84%E3%81%A6%E3%81%A6%E3%80%81%E3%83%81%E3%83%A3%E3%83%83%E3%83%88%E3%82%A2%E3%83%97%E3%83%AA%E3%81%A8%E3%81%97%E3%81%A6%E3%82%88%E3%82%8A%E3%80%81API%E3%81%AE%E5%9C%9F%E5%8F%B0%E3%81%A8%E3%81%97%E3%81%A6%E8%A6%8B%E3%81%9F%E3%81%BB%E3%81%86%E3%81%8C%E8%85%B9%E8%90%BD%E3%81%A1%E3%81%99%E3%82%8B%E3%82%93%E3%81%A7%E3%81%99%E3%82%88%E3%81%AD%E3%80%82)
テキトー教師DotAI 認定講師初めて触る人がよく「え、これサーバーなんですか」ってなるやつですね。エンドポイントは3系統あって、Ollama独自の /api/chat と /api/generate、OpenAI互換の /v1/chat/completions と /v1/responses、それからAnthropic互換の /v1/messages です。
室谷代表取締役OpenAI互換とAnthropic互換が両方あるのが大きい。既存コードの向き先をlocalhostに変えるだけで、手元のモデルに流せる。
ローカル利用ならAPIキーも不要で、検証環境の立ち上げが一気に軽くなるんですよ。
ローカル利用ならAPIキーも不要で、検証環境の立ち上げが一気に軽くなるんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、まず独自APIで動かして、慣れたら互換APIに切り替える順番がハマりやすいです。あと既定のコンテキスト長が4096トークンなので、長文を渡すと切れる点は先に知っておくといいですよ。
PythonとJavaScriptのSDK、そして100以上の連携ツール
室谷代表取締役SDKも公式で出てます。Pythonが pip install ollama、JavaScriptが npm i ollama。
ここから先は開発者の領分なんですけど・・・
ここから先は開発者の領分なんですけど・・・
テキトー教師DotAI 認定講師連携先が100以上あるのもポイントですね。LangChain、LiteLLM、Open WebUI、Cline、Continueあたりが代表で、RAGを組むのもエージェントを組むのも、繋げられる前提がある。
室谷代表取締役業界構造で見ると、モデルを自前で持つレイヤーと、モデルを差し替え可能にするレイヤーが分かれてきてる。Ollamaは完全に後者で、だから互換APIを3系統も揃えてるんだと思うんですよね。
コマンド1つでClaude CodeやCodexにつなぐ
室谷代表取締役これが最近の一番の変化で。ollama launch claude でClaude Code、ollama launch codex でCodex CLI、ollama launch opencode でOpenCodeが、Ollamaのモデルをバックエンドに起動するんですよ。
テキトー教師DotAI 認定講師未インストールでも導入の案内が出るので、初めての人はコマンド一発で体験までいけます。対応はClaude Code・Codex・Copilot CLI・DeepSeek Harness・Droid・OpenCodeまで広がってますね。
室谷代表取締役テキトー教師DotAI 認定講師macOSのデスクトップアプリなら「Apps」からClaude DesktopやChatGPT Desktopに繋ぐ手もあるので、ターミナルが苦手な人はそっちから、ですかね。
業務での使いどころとモデルライセンスの確認事項
室谷代表取締役業務だと、まず社内文書をベクトル化して意味検索する用途が分かりやすい。embeddingsで、データを外に出さずに社内ナレッジのRAGを組める。
テキトー教師DotAI 認定講師visionで書類や図面をローカルで読ませる、tool callingでエージェントを組む、そのあたりも現実的な線です。Web検索は無料アカウントのAPIキーで呼ぶ形で、gpt-ossのような一部モデルのリサーチに使えますが、これはクラウド側の機能なので、前章の完全ローカル固定とは両立しないんですよ。
室谷代表取締役ライセンスは二層で考える必要がある。Ollama本体はMITライセンスで商用利用も無償。
でも動かすモデルの規約は別で、Gemmaの利用規約やLlamaのコミュニティライセンスだったりする。業務利用の前にモデル単位で確認が要るんですよね。
でも動かすモデルの規約は別で、Gemmaの利用規約やLlamaのコミュニティライセンスだったりする。業務利用の前にモデル単位で確認が要るんですよね。
テキトー教師DotAI 認定講師ここ、見落とされがちなんですよ。「Ollamaが無料だから大丈夫」で通る話ではないので、導入時にモデルごとに洗い出すのが安全ですね。
よくある質問
Q1. Ollamaはスマホやタブレットでも使える?
室谷代表取締役基本はPC向けの仕組みなんですよね。Ollamaはローカルでモデルを動かす前提なので、デスクトップ環境が中心になります。
テキトー教師DotAI 認定講師たしかに。スマホで同じ体験を、となると別のアプリやクラウド経由の話になりがちです。
まずはPCで試すのが現実的ですね。
まずはPCで試すのが現実的ですね。
Q2. 使わなくなったモデルはどう整理すればいい?
室谷代表取締役ディスクを圧迫しがちなんですよ。使い終わったモデルは消しておく。
これだけでだいぶ違います。
これだけでだいぶ違います。
テキトー教師DotAI 認定講師現場でよく聞くのは「何が残ってるか分からない」なんですよ。一覧で見て、要らないものを消す習慣が大事ですね。
室谷代表取締役サイズが大きいモデルもあるので、複数入れるとあっという間です。整理の手間は惜しまない方がいいですね。
Q3. Ollamaのアップデートはどうやる?
室谷代表取締役アップデートは定期的にやってます? 古いままだと不具合を踏むことがあるんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのが、入れたまま放置してしまうパターンです。導入方法に合わせて更新手順が変わるので、公式の案内を見るのが確実ですね。
Q4. 日本語のモデルはきちんと使える?
室谷代表取締役日本語の品質、気になりますよね。モデルによって得意不得意がかなり違います。
テキトー教師DotAI 認定講師初めて触る人が戸惑うのは、英語前提のモデルを日本語で使ったときのニュアンスの落ち方なんですよ。日本語向けを選ぶか、指示文を丁寧にすると変わります。
室谷代表取締役あとは用途次第で、要約なら軽いモデル、創作なら重いモデル、みたいに分けると無駄が減ります。ROIで見てもその方が合理的なんですよね。
Q5. 業務利用で気をつけることは?
室谷代表取締役業務で使うなら、モデルごとのライセンス確認は外せないんですよね。Ollama自体というより、動かすモデル側の条件を見る必要があります。
テキトー教師DotAI 認定講師そうですね。個人で試すのと、会社のサービスに組み込むのでは見るべき点が変わります。
利用規約と再配布の可否は先に確認しておくのが安全です。
利用規約と再配布の可否は先に確認しておくのが安全です。
室谷代表取締役あと、ローカルとはいえ業務データを入れるなら社内ルールとセットで考える。ここを飛ばすと後で揉めるので、最初に決めておくのがいいですね。
まとめ
室谷代表取締役ここまで来ると、Ollamaは「とりあえず入れて触る」価値は十分あるんですよね。ローカルで動く安心感は、一度体験すると戻れないタイプのやつです。
テキトー教師DotAI 認定講師たしかに。最初から完璧を狙うより、小さいモデルで一回動かすのが一番早いです。
動けば、次に何を試すかが見えてきますから。
動けば、次に何を試すかが見えてきますから。
室谷代表取締役MYUUUの現場でも、まず個人のPCで試して、用途が固まったらチームで共有する、みたいな順番が現実的でした。いきなり全員導入はコストも手間もかさみます。
テキトー教師DotAI 認定講師現場感覚で言うと、最初の一回が一番ハードルが高いんですよ。インストールして、モデルを一つ動かして、消せることを確認する。
そこまでやればもう自分のものです。
そこまでやればもう自分のものです。
室谷代表取締役次は、自分の仕事のどの作業を置き換えたいかを一つ決めてみてください。要約でも下書きでも、小さく試すのが一番早いですね。