Artificial Analysisは何を測る独立系のベンチマーク会社なのか
何のために運営されていて、誰が読んでいるのか
 室谷代表取締役
最初に整理しておきたいのが、この会社が何をやっているかという話で。モデルを作っている側ではなく、第三者の立場でベンチマークと分析だけを出す独立系なんですよね。
本社はサンフランシスコに置いています。
本社はサンフランシスコに置いています。
 テキトー教師DotAI 認定講師
現場でよく聞くのは「あのスコアって誰がどうやって出してるんですか」という素朴な疑問なんですよ。モデルを作った会社が自分で公表する数字とは、前提の置き方がそもそも違うところがポイントで。
室谷代表取締役目的ははっきりしていて、開発者や研究者、企業が自分の用途に合ったモデルやAPIプロバイダーを選べるようにするため。つまり購買判断の材料を提供する事業なんですよ。
LinkedInのフォロワーが4.3万人ほどいるので、それなりに業界で見られている指標なんだと思います。
LinkedInのフォロワーが4.3万人ほどいるので、それなりに業界で見られている指標なんだと思います。
テキトー教師DotAI 認定講師選ぶ側のための材料、というのが効いてきますね。作る側の都合ではなく、使う側の比較軸として読まれている、と。
モデル作成者とプロバイダーを分けて測るのはなぜか
室谷代表取締役ここが地味に面白いんですけど、この会社はモデルを作った会社と、それを提供しているプロバイダー、さらにエンドポイントやシステムを分けて扱っているんですよ。まとめて「このモデルは何点」で済ませていない。
テキトー教師DotAI 認定講師同じモデルでも、どこ経由で呼ぶかで体験が変わるんですよね。初めて触る人は「モデルが同じなら同じでしょ」と思いがちなんですが、応答の速さも安定感も別物になりうるので。
室谷代表取締役だから測るのは「顧客が実際に体験する性能」で、特定ハードウェアの理論上限みたいな話はしない方針なんです。うちの現場でも、カタログの数字より実際の返り方のほうが判断材料になること多いんですよね。
テキトー教師DotAI 認定講師理論値と体感値がズレるのは、どのツールでも起きるやつですね。そこを分けて出してくれるのはありがたいです。
無料で見られる範囲と、有料で提供されているもの
室谷代表取締役で、実際に何が見られるのかという話。トップページの指標やモデル比較は普通に参照できますし、方法論もきちんと公開されています。
テキトー教師DotAI 認定講師方法論が読めるのは大きいですよね。「なぜこの点数なのか」を追えると、数字を鵜呑みにしなくて済みますから。
説明のないランキングは、けっこう判断を誤らせるんですよ。
説明のないランキングは、けっこう判断を誤らせるんですよ。
室谷代表取締役データアクセスについてはAPIとドキュメントの導線が用意されている、という案内がFAQにあります。有料の範囲や契約条件の細かいところまでは公開情報だけでは読み切れないので、そこは公式の最新情報を確認するのが確実です。
テキトー教師DotAI 認定講師この界隈は機能も料金体系も動きますし、そこは一次情報を見に行くのが一番ですね。
Intelligence Indexは何をどう計算しているのか
4カテゴリを均等25%で割っている今の設計
室谷代表取締役まず今のIntelligence Indexが何でできてるか、なんですけど。現行はv5.0.1で、知識労働・コーディング・科学・一般知識の4カテゴリがそれぞれ25%ずつ。
完全な均等割りなんですよね。
完全な均等割りなんですよね。
テキトー教師DotAI 認定講師そこ、現場でよく聞くのは「コーディングが一番重いんでしょ」という思い込みなんですよ。均等だと知ると、順位の見え方が変わる人が多いですね。
室谷代表取締役均等ってことは、1カテゴリだけ飛び抜けても総合は上がりにくい。4事業を同じ比率で採点する経営会議みたいなもので、偏りのあるモデルは損をする設計なんですよ。
テキトー教師DotAI 認定講師なるほど。だから「うちの用途では最強なのに順位が低い」ということが起きるわけですね。
9つの評価と、それぞれの重み
Intelligence Index v5.0.1の9評価と重み
| カテゴリ(25%均等) | 評価 | 重み |
|---|---|---|
| 知識労働 25% | AA-Briefcase v1.1 | 15% |
| 知識労働 25% | AutomationBench-AA | 5% |
| 知識労働 25% | GDP.pdf | 5% |
| コーディング 25% | FrontierCode 2.0 | 15% |
| コーディング 25% | Terminal-Bench 4.0 | 10% |
| 科学 25% | Terminal-Bench-Science 0.1 | 15% |
| 科学 25% | CritPt v2 Hard Subset | 10% |
| 一般 25% | AA-Omniscience v1.1(正答率10%+非ハルシネーション率5%) | 15%相当 |
| 一般 25% | HLE-Diamond | 10% |
室谷代表取締役で、中身の9評価がこれです。
| カテゴリ | 評価と重み |
|---|---|
| 知識労働 25% | AA-Briefcase v1.1 15% / AutomationBench-AA 5% / GDP.pdf 5% |
| コーディング 25% | FrontierCode 2.0 15% / Terminal-Bench 4.0 10% |
| 科学 25% | Terminal-Bench-Science 0.1 15% / CritPt v2 Hard Subset 10% |
| 一般 25% | AA-Omniscience v1.1(正答率10%+非ハルシネーション率5%)/ HLE-Diamond 10% |
テキトー教師DotAI 認定講師単独で15%の枠がAA-Briefcase・FrontierCode 2.0・Terminal-Bench-Scienceの3つ、さらにAA-Omniscienceも正答率10%と非ハルシネーション率5%を合わせて実質15%相当。同じ15%でも中身の性格が全然違うのが面白いところですね。
室谷代表取締役非ハルシネーションが別枠で5%取られてるのが、地味に効く。嘘をつかないこと自体が評価項目になってるわけで、これは実務目線だと納得なんですよ。
テキトー教師DotAI 認定講師ネットに残っている古い重み付けの話
室谷代表取締役ここで注意したいのが、検索して出てくる解説がわりと古い版のままだったりするんですよね。Agents 30%・Coding 20%・Scientific Reasoning 20%・General 30%で、評価もMMLU-ProやHLE、GPQA Diamond、AIME2025といった8種類で説明されているものが残ってます。
テキトー教師DotAI 認定講師初めて触る人がそこを読むと、いまの数字と噛み合わなくて混乱するんですよ。「自分が読んでる説明、いつの話だろう」と疑う癖をつけたほうがいいですね。
室谷代表取締役ベンチマークって更新される前提で読まないと、判断を誤るんですよ。古い重みで「このモデルはコーディングが強い」と決めつけて、発注判断を間違えるのは避けたいところで。
スコアは6時間ごとに塗り替わる生モノ
テキトー教師DotAI 認定講師もうひとつ前提として、この数字は固定じゃないんですよ。6時間ごとに評価を再実行していて、提供終了したエンドポイントは18時間ごと。
過去5日間の平均を代表値として出してるので、見るたびに少し動きます。
過去5日間の平均を代表値として出してるので、見るたびに少し動きます。
室谷代表取締役だから「先週の記事に載ってた点数」を社内資料にコピペするのは危ないんですよね。意思決定に使うなら、その日に取り直すのが基本だと思います。
テキトー教師DotAI 認定講師たしかに。スクリーンショットで共有されると、いつの数字か分からなくなるのが一番困るんですよ。
いま上位のモデルはどれか、スコアと値段を並べて見る
上位5件には同じモデルの設定違いが並ぶ
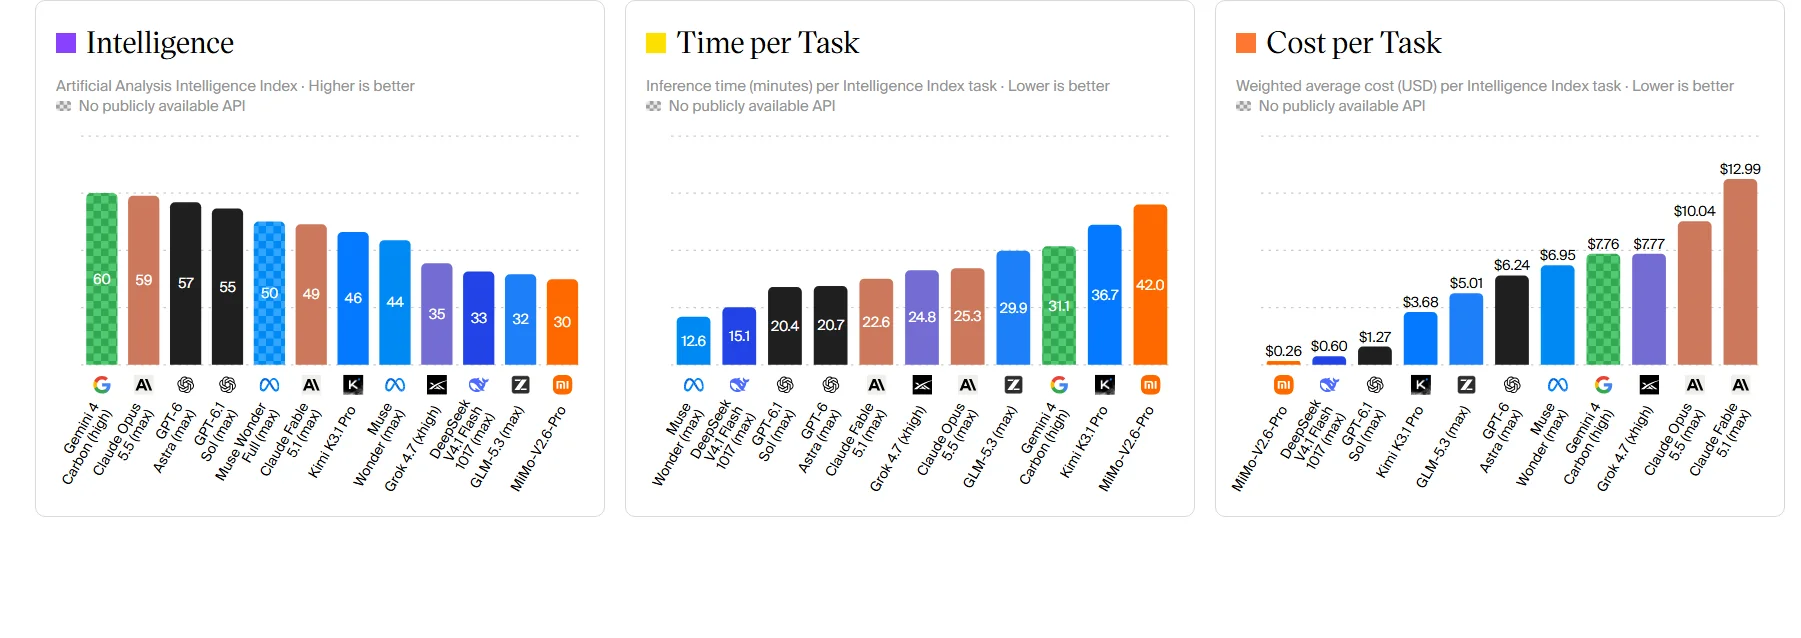
室谷代表取締役2026年11月8日時点の Intelligence Index、上位は1位 Gemini 4 Carbon (high) 60点、2位 Claude Opus 5.5 (max) 59点、3位 Gemini 4 Carbon (medium) 58点、4位 Claude Opus 5.5 (xhigh) 57点、5位 GPT-6 Astra (max) 57点。同じモデルの推論設定違いが別エントリとして並ぶのがこの指標のクセなんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。「え、同じ名前が2回出てくるの?」って。
モデル名だけで比較表を作ると、二重計上みたいに見えちゃうんですよ。
モデル名だけで比較表を作ると、二重計上みたいに見えちゃうんですよ。
室谷代表取締役で、オープンウェイト勢の最上位は Kimi K3.1 Pro の46点。上位5件とは開きがあります。
この辺は Artificial Analysis のランキングを引用するときに必ず一緒に見せたい数字です。
この辺は Artificial Analysis のランキングを引用するときに必ず一緒に見せたい数字です。
テキトー教師DotAI 認定講師数字の差だけ見ると大きく感じますけど、用途によってはその差が効かないこともある。そこは職種別の指標の話につながりますね。
タスクあたり費用は比較の土俵を切らないと逆の結論になる
室谷代表取締役費用の話、前提を切らないと逆の結論になります。知能スコア上位のモデルに絞って並べた中で最安が MiMo-V2.6-Pro の $0.26、最高が Claude Fable 5.1 (max) の $12.99。
テキトー教師DotAI 認定講師同じ並びの中で50倍近く開くんですね。ここだけ切り取られると誤解されそうです。
室谷代表取締役サイト全体まで広げると $0.00 台のモデルもあります。K2 Horizon 375B A23B がそう。
知能上位の中の最安と、全モデル中の最安は別物なんですよ。経営目線で言うと、必要なスコアの下限を先に決めてから最安を探す順番にしないと、安さで選んで手戻るのが一番高くつく。
知能上位の中の最安と、全モデル中の最安は別物なんですよ。経営目線で言うと、必要なスコアの下限を先に決めてから最安を探す順番にしないと、安さで選んで手戻るのが一番高くつく。
テキトー教師DotAI 認定講師たしかに。単価が安い=タスクあたりも安い、ではないですからね。
速度は「上位の中」と「全体」で顔ぶれが変わる
室谷代表取締役速度も同じ構造で、知能上位の中では Muse Wonder (max) が 12.6分で最短。
テキトー教師DotAI 認定講師軽量・低推論設定まで含めると GPT-6 Luna (Low) が 0.6分なので、桁が変わりますね。
室谷代表取締役速さが効くのは一次受けのチャットや大量バッチ。全工程を最上位で固めると、待ち時間で作業リズムが崩れてコストも無駄が出ます。
テキトー教師DotAI 認定講師現場感覚でも、重いモデルを全工程に置いた瞬間にテンポが落ちるんですよ。
スクリーンショットを根拠にするなら日付と版を添える
室谷代表取締役この数字、固定値じゃないんですよね。6時間ごとに再実行、提供終了したエンドポイントは18時間ごとで、過去5日間の平均を代表値として出してる。
テキトー教師DotAI 認定講師社内資料に貼るときは取得日とバージョンを添える。それだけで「いつの話?」が消えます。
室谷代表取締役Intelligence Index の現行は v5.0.1 で、v3世代の重み付けのまま書かれた解説も残ってます。数字を引用する側が版を見る責任あるんですよね。
テキトー教師DotAI 認定講師古いスクショの数字だけが独り歩きするのが、一番もったいないので。
料金比較は単価とタスクあたり費用の混同で失敗する
ブレンド価格は7:2:1で計算されている
室谷代表取締役料金の話、単価表だけ見て決めると大体失敗するんですよね。Artificial Analysisはブレンド価格っていう独自の出し方をしていて、キャッシュヒットと入力と出力を7:2:1の比率で混ぜてるんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、そこが最初のつまずきで。入力の単価だけ見て「安い」と思ったら、実際に回したら全然違う請求だった、というのはよく聞きます。
室谷代表取締役計算はシンプルで、(7×キャッシュヒット価格+2×入力価格+出力価格)÷10。ただ、この比率が自分の使い方と合ってるかどうかが全部なんですよね。
テキトー教師DotAI 認定講師キャッシュが効く使い方なら安く出るし、毎回新しい長文を投げる使い方なら順番が逆転する。同じ表でも自分の用途に当てはめないと意味がないですね。
単価が同じでもタスクあたり費用が変わる理由
室谷代表取締役で、もっと効くのがタスクあたり費用の方で。単価が同じでも、出力が長いモデル、推論でたくさん吐くモデルは、タスク1件で見ると高くつくんです。
テキトー教師DotAI 認定講師そこが混同されやすいんですよ。単価表で「こっちが安い」と決めて、実際に動かしたらコストが倍だった、というのは初めて触る人がほぼ必ず引っかかるポイントで。
室谷代表取締役中身は、実際に消費した入力・キャッシュ・出力のトークン数に評価ごとの重みを掛けて加重平均してる。つまり「単価が安いモデル」ではなく「安く終わるモデル」を見てるわけです。
経営目線で言うと、単価表で稟議を通すと後で痛い目を見るので、1タスクあたりで並べた方が意思決定が速いんですよね。
経営目線で言うと、単価表で稟議を通すと後で痛い目を見るので、1タスクあたりで並べた方が意思決定が速いんですよね。
テキトー教師DotAI 認定講師なるほど、予算の説明もそっちの方が通りがいいですね。
一部の解説記事にある3:1の式はなぜ合わないのか
料金比較の前提:ブレンド価格の式とタスクあたり費用
ブレンド価格(7:2:1)
- (7×キャッシュヒット価格+2×入力価格+出力価格)÷10
- キャッシュヒット・入力・出力を7:2:1で混ぜる
- キャッシュが効く使い方なら安く出る
- 毎回新しい長文を投げる使い方なら順番が逆転する
タスクあたり費用
- 実際に消費した入力・キャッシュ・出力のトークン数に評価ごとの重みを掛けて加重平均
- 単価が同じでも出力が長いモデル・推論でたくさん吐くモデルはタスク1件で高くつく
- 「単価が安いモデル」ではなく「安く終わるモデル」を見る
- 1タスクあたりで並べると意思決定が速い
室谷代表取締役ここで注意したいのが、世の中の解説には(3×入力価格+出力価格)÷4という式で書いてるものもあるんですよ。でも現行の公式方法論は7:2:1で、一致しないんです。
テキトー教師DotAI 認定講師古い式がそのまま残ってるやつですね。初めて読む人はどっちが正しいか分からないまま計算しちゃうので、そこは危ないなと思います。
室谷代表取締役式が違えば、同じモデルでも並び順が変わる。数字を比べるときは、どの前提で混ぜたかまで確認しないと意味がないんですよ。
テキトー教師DotAI 認定講師そこ、見落とす人多いんですよ。
Intelligence Indexとタスクあたり費用の散布図の読み方
室谷代表取締役で、実務ではIntelligence Indexとタスクあたり費用の散布図を見るのが一番早いんですよ。左上に近いほど賢くて安い、という配置になります。
テキトー教師DotAI 認定講師散布図、最初は点の多さに圧倒されるんですけど、予算のラインで横に切って、その上で一番スコアが高い点を拾う、という見方でいいんですか。
室谷代表取締役そうそう。全部を眺める必要はなくて、上限で線を引いてから選ぶ。
速度も同じ画面で見られるので、そこも含めて判断できます。
速度も同じ画面で見られるので、そこも含めて判断できます。
テキトー教師DotAI 認定講師単価表をにらめっこするより、よっぽど早く決まりますね。
職種・用途別に強いモデルはどの指標で調べるのか
6分野のCapability Indexesは何を重み付けしているのか
室谷代表取締役用途が決まってる人ほど、総合スコアの1位2位を見ても仕方ないんですよね。うちも法務も財務も同じモデルに投げちゃってますけど、あれは正直ちょっと雑なんですよ・・・
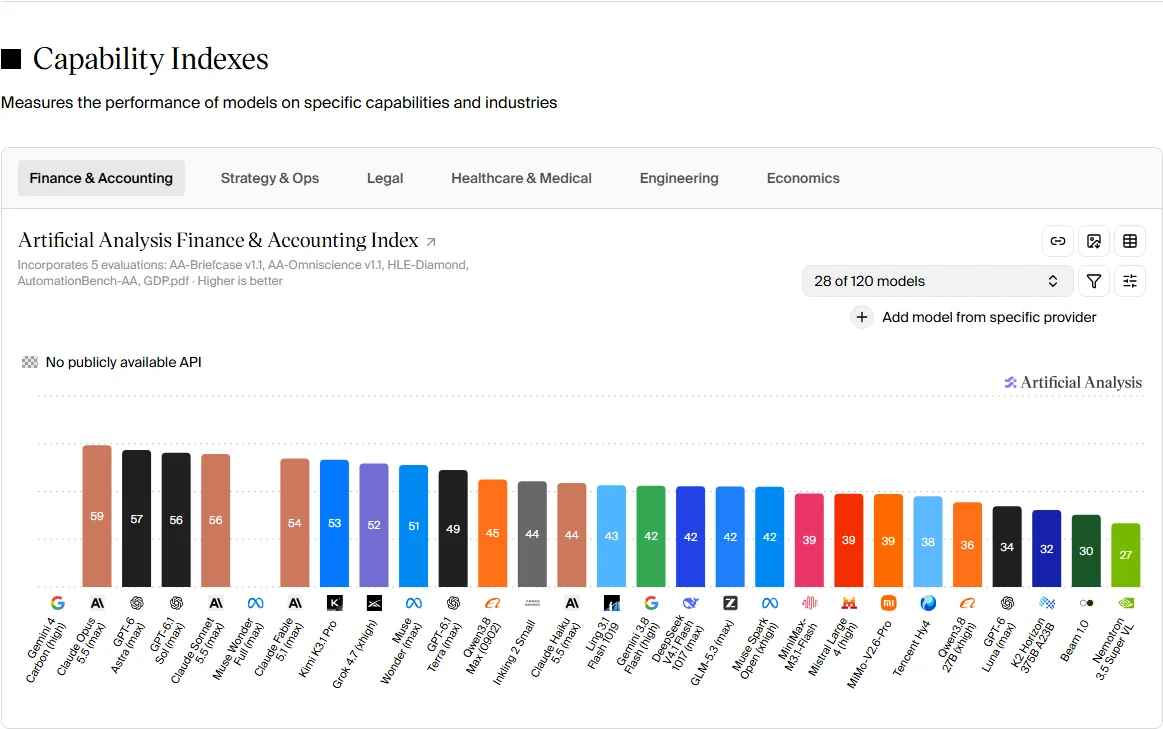
テキトー教師DotAI 認定講師現場でよく聞くのが「結局どの数字を見ればいいんですか」なんですよ。そこで見るのが分野別の指数で、Finance & Accounting、Strategy & Ops、Legal、Healthcare & Medical、Engineering、Economics の6つに分かれてます。
室谷代表取締役6分野それぞれ、実務での出現頻度に合わせて重みを変えてるわけですか。
テキトー教師DotAI 認定講師はい。AA-Briefcase、AA-Omniscience、HLE-Diamond、AutomationBench-AA、GDP.pdf あたりを、分野ごとに違う重みで組み合わせてます。
同じ材料でも配合が違う、みたいなイメージですね。
同じ材料でも配合が違う、みたいなイメージですね。
Legal Indexの中身を見ると重み付けの考え方が分かる
テキトー教師DotAI 認定講師中身が一番わかりやすいのがLegalで、法的知識30%、エージェント型知識作業25%、推論15%、非ハルシネーション15%、長文脈10%、エージェント型ツール利用5%という配分なんですよ。
室谷代表取締役知識だけで3割で、残り7割は動かせるかに振ってるんですね。うちの判断基準で言うと、資格試験の点数より実務の段取りを見てる感じで、かなり納得感あります。
テキトー教師DotAI 認定講師法務って長い契約書を読んだうえで手を動かすので、長文脈とツール利用が効いてくるんですよね。
室谷代表取締役分野ごとの最新順位は、職種別指数のほうが詳しいのでそちらを見てもらうのが早いかもです。詳しくはArtificial Analysis Capability Indexes v2.0とは?職種別6指数を更新、Claude Opus 5.5が全分野首位で解説しています。
コーディングはCoding Agent IndexとFrontierCode系で見る
室谷代表取締役コーディングはどこを見るんですか。総合指数の中にもCodingのカテゴリがありますよね。
テキトー教師DotAI 認定講師総合指数の中ではCodingが25%で、FrontierCode 2.0が15%、Terminal-Bench 4.0が10%なんですよ。ただ、開発でガッツリ使うならCoding Agent Index v2.0を見るほうが解像度は高いです。
室谷代表取締役そっちは何で構成されてるんですか。
テキトー教師DotAI 認定講師FrontierCode v1.1、Terminal-Bench 4.0、SWE-Atlas-QnA-AA の3つですね。コードを書く力、端末で作業を回す力、リポジトリの文脈を読む力はそれぞれ別物なので、分けて見たほうが判断しやすいんですよ。
事実の正確性はAA-OmniscienceのNet Scoreで確認する
職種・用途別に強いモデルを調べる指標
6分野のCapability Indexes
Finance & Accounting、Strategy & Ops、Legal、Healthcare & Medical、Engineering、Economicsの6分野。AA-Briefcase、AA-Omniscience、HLE-Diamond、AutomationBench-AA、GDP.pdfを分野ごとに異なる重みで組み合わせる
Legal Indexの重み配分
法的知識30%、エージェント型知識作業25%、推論15%、非ハルシネーション15%、長文脈10%、エージェント型ツール利用5%。知識3割・動かせる力7割
コーディングはCoding Agent Index v2.0
FrontierCode v1.1、Terminal-Bench 4.0、SWE-Atlas-QnA-AAの3つで構成。総合指数ではCoding25%(FrontierCode 2.0が15%、Terminal-Bench 4.0が10%)
事実の正確性はAA-OmniscienceのNet Score
正答で加点、誤答(ハルシネーション)で減点、未回答は減点なしの-100〜100。総合指数の非ハルシネーション率は5%の重みだが、業務ではNet Scoreを単体で見るほうが判断しやすい
室谷代表取締役捏造の少なさは、どの数字で見ればいいんですか。
テキトー教師DotAI 認定講師AA-OmniscienceのNet Scoreですね。正答で加点、誤答つまりハルシネーションで減点、未回答は減点なしで、-100から100のスコアになります。
室谷代表取締役間違えたら引かれて、黙ってたら減点なし、と。経営目線だと、自信満々に間違えるモデルが一番怖いので、そこが数値で見えるのは大きいですね。
テキトー教師DotAI 認定講師そこは要注意なんですよね。総合指数にも非ハルシネーション率が5%の重みで入ってますけど、業務で使うならこのNet Scoreを単体で見たほうが判断しやすいと思います。
日本語での実務性能はスコアだけで判断していいのか
評価は主に英語テキストベースという前提
室谷代表取締役Artificial AnalysisのIntelligence Index、上位の数字だけ追いかけてると危ないんですよね。あの9つの評価、基本的に英語のテキストが中心なんですよ。
テキトー教師DotAI 認定講師そこ、初めて触る人が一番誤解するポイントで。「総合1位だから日本語の業務でも1位でしょ」と思ってしまうんです。
室谷代表取締役経営目線で言うと、稟議書に「スコア1位」って書いた瞬間に責任が発生するんですよ。日本語の現場で使うなら、そこは別で確認しないと説明がつかない。
v5の評価構成そのものはIntelligence Index v5の解説で細かく追っていますけど、内訳を見ても英語タスクが中心です。
v5の評価構成そのものはIntelligence Index v5の解説で細かく追っていますけど、内訳を見ても英語タスクが中心です。
テキトー教師DotAI 認定講師現場でよく聞くのも「英語のデモは綺麗なのに、日本語の社内文書を投げるとトーンが崩れる」という声です。スコアはスコアでしかないんですよね。
多言語や視覚推論は別指標で測られている
室谷代表取締役じゃあ画像まわりはどうなんです? マルチモーダル前提で選ぼうとすると。
テキトー教師DotAI 認定講師画像入力に対応したモデルは、HLE-DiamondやGDP.pdfの一部で画像も受け取るんです。ただ、それは画像対応を正面から測っているわけじゃない。
多言語も視覚推論も、Multilingual IndexやMMMU-Proといった別の指標で測られていて、Intelligence Indexには入っていないんですよ。
多言語も視覚推論も、Multilingual IndexやMMMU-Proといった別の指標で測られていて、Intelligence Indexには入っていないんですよ。
室谷代表取締役なるほど。ひとつの数字で全部わかる、という見方はできないと。
テキトー教師DotAI 認定講師そうなんです。日本語の品質を見たいなら多言語側の指標へ、図表の読み取りを見たいなら視覚側へ、というふうに入口を分けて考える必要があります。
自社のタスクで確かめるときの順番
室谷代表取締役結局は自社タスクで試すしかないんですよね。順番としては、まず総合スコアで候補を2〜3に絞る。
次に日本語の実務プロンプトを数本流して、最後にタスクあたり費用で見る。この順番が一番無駄が少ない。
次に日本語の実務プロンプトを数本流して、最後にタスクあたり費用で見る。この順番が一番無駄が少ない。
テキトー教師DotAI 認定講師最初から全部試すと時間が溶けますからね。あと評価条件が標準化されていて、非推論モデルは温度0、推論モデルは0.6、出力上限は作成者開示値に準拠、API失敗時は最大30回リトライ、というルールで揃えられてるんです。
だから自分たちのプロンプトでも素の比較がしやすいんですよ。
だから自分たちのプロンプトでも素の比較がしやすいんですよ。
室谷代表取締役再現性の面も効いてて、評価データセットを自社で保持しているから数字が急に別物にならない。ただ6時間ごとに再実行されているので、先週のスコアをそのまま根拠にしないことですね。
テキトー教師DotAI 認定講師そこ、ハマる人多いんですよ。先週の数字で決めたのに、今見たら並びが変わってる、みたいな。
判断の日付を控えておくだけでだいぶ違います。
判断の日付を控えておくだけでだいぶ違います。
候補が多すぎるときの絞り込み方と他サイトとの使い分け
まず優先条件を決めて候補を削る
候補を絞り込む手順
- 01優先条件を決める知能・速度・費用のどれを重く見るかを決め、Model Recommenderで優先条件を指定して最初の一覧を減らす
- 02総合スコアで絞るまず総合スコアの順で候補を削る
- 03費用対効果の散布図で絞る次に費用対効果の散布図で比較する
- 04用途別で最終判断最後に用途別の指標で選ぶ
室谷代表取締役モデルって今や何十個も並ぶじゃないですか。全部を自分で読み比べるのは正直時間の無駄で、うちならまず総合スコア、次に費用対効果の散布図、最後に用途別、という順番で降りていきます。
テキトー教師DotAI 認定講師そこが最初のつまずきなんですよ。いきなり細かい指標のページに飛んで、比較表の前で固まってしまう人が多いので。
上から順に絞る、でいいんですけどね。
上から順に絞る、でいいんですけどね。
室谷代表取締役候補が多いときは Model Recommender で優先条件を指定するのが早いです。知能・速度・費用のどれを重く見るかを入れるだけで、最初の一覧がかなり減りますから。
テキトー教師DotAI 認定講師現場感覚で言うと、速度を軽視して選んで後から困るパターン、わりとあります。対話で使うなら待ち時間は体感に直結しますから。
対話の好ましさを測るサイトとは役割が違う
室谷代表取締役LMSYS Chatbot Arena は人間の二択投票でELOレーティングを出す、つまり「対話として好ましいか」を見ているんですよね。こっちは品質・速度・価格を同じ基準で数字にする。
測っているものがそもそも違う。
測っているものがそもそも違う。
テキトー教師DotAI 認定講師たしかに。だからArenaで上位なのに自分の用途では弱い、というのは普通に起きます。
指標の意味を取り違えると、評価サイトのせいにしちゃいますからね。
指標の意味を取り違えると、評価サイトのせいにしちゃいますからね。
室谷代表取締役片方だけで決めると判断を誤るので、両方並べて見るのが前提だと思ってます。どっちが上という話ではなく、答えている問いが別なんです。
テキトー教師DotAI 認定講師好みを集める指標と、条件を揃えて比べる指標。補完関係として扱うのが素直ですね。
自社のプロンプトを投げる前に確認すること
- 独自の評価セットを試す機能では、入力したプロンプトが外部のサーバーを経由しないか確認する
- 機密情報を含むプロンプトは使わず、汎用的な内容にとどめる
- 方法論・データアクセスの範囲は、公式のFAQと方法論ページで先に確認する
室谷代表取締役ここは経営目線で言うと、モデル選定より先に「何を外に出してはいけないか」を決めるべきなんですよ。プロンプトはもう立派な社内情報なので、そこが緩いと後で取り返しがつかない。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこです。「試すだけなら大丈夫だろう」で社内の文書を貼ってしまう。
私もヒヤッとした場面を見たことがあります。
私もヒヤッとした場面を見たことがあります。
室谷代表取締役独自の評価を試す機能については、入力が外部サーバーを経由する点に注意が必要と言われています。ただ一次情報でどこまで明記されているか読み切れないので、実際に触る前に公式へ問い合わせるのが確実です。
テキトー教師DotAI 認定講師方法論やデータアクセスの案内は公式のFAQから辿れますから、そこを先に読んでから手を動かす。順番としてはそれだけで十分安全側に倒れます。
よくある質問
Q1. スコアが高いモデルにすぐ乗り換えるべき?
室谷代表取締役乗り換え判断はスコア単独じゃなくて、自社のタスクで本当に良くなるかどうかですよね。移行の手間も含めてROIで見ないと、数字が良くても現場が回らないことがあります。
テキトー教師DotAI 認定講師初めて触る人は「スコア1位だから」で切り替えがちなんですけど、出力の癖が変わって手戻りする、というのはよく聞きます。プロンプトの互換性も一緒に見たほうがいいです。
室谷代表取締役まずは一部のワークフローだけで並走させて、品質とコストの両方を見る。いきなり全部置き換えないほうが無難ですね。
Q2. Artificial Analysisの数字はどうやって信用すればいい?
テキトー教師DotAI 認定講師評価軸が公開されているか、タスクの中身が自分の用途に近いかを見るのが先ですね。同じIndexでも、何を重く見ているかで意味が変わりますから。
室谷代表取締役あと、スコアはその時点のスナップショットなんですよね。モデルは更新されるので、四半期ごとに見直す前提で運用したほうがいい。
テキトー教師DotAI 認定講師たしかに。一度見て終わりじゃなくて、定点観測のダッシュボードとして使うイメージですね。
Q3. 自社データで評価し直すなら何から始める?
室谷代表取締役いきなり大規模な評価基盤を作らないことです。現場でよく使うプロンプトを数十個集めて、正解例と一緒に固定するだけで十分比較できます。
テキトー教師DotAI 認定講師評価セットの作り込みに時間をかけがちなんですけど、まずは「よくある依頼」を10個くらい拾うところからでいいんですよ。
室谷代表取締役そのほうが意思決定が早い。工数も読めるし、費用対効果の説明もしやすいですから。
Q4. 人手の主観評価とスコアはどう使い分ける?
テキトー教師DotAI 認定講師主観評価は「読んで自然か」「違和感がないか」を見るのに向いています。数値ベンチは比較の土台、人手は最終チェック、みたいな分担ですね。
室谷代表取締役顧客向けの文章生成みたいに、品質の感じ方が大事な領域は人手評価を軽視できないですよね。
テキトー教師DotAI 認定講師運用していると、スコアで候補を3つに絞って、最後は人が触って決める、が現実的だと思います。
Q5. スコアの伸びが止まって見えるとき、どう解釈する?
室谷代表取締役ベンチマークが飽和している可能性がありますよね。上位が団子になると、差が見えにくくなる。
テキトー教師DotAI 認定講師「最近どれも同じに見える」というのは現場でも聞きます。その場合は評価軸を変えたほうがいいですね。
室谷代表取締役コストや速度、特定タスクの成功率みたいな別軸で見ると、まだ差はありますから。
まとめ
室谷代表取締役結局、Artificial Analysisは「候補を絞るための地図」であって、答えそのものではないんですよね。
テキトー教師DotAI 認定講師そうですね。スコアで当たりをつけて、最後は自分のタスクで試す。
この順番が崩れると、数字に振り回されます。
この順番が崩れると、数字に振り回されます。
室谷代表取締役経営目線で言うと、モデル選定はコストと品質のトレードオフを説明できる形にしておくのが大事です。評価の記録が残っていれば、変更のたびに同じ議論をしなくて済みますから。
テキトー教師DotAI 認定講師まずはよく使うプロンプトを10個ほど集めて、2〜3モデルを並走させてみる。そこからですね。
室谷代表取締役その小さな検証が、半年後の乗り換え判断を楽にします。スコアは定期的に見直して、自社の評価とセットで持っておくといいですよ。