Qwen3.6-27Bとはどんなモデルか、27Bのdenseで何が変わったのか
270億パラメータのdense、MoEとの違いはどこに出るのか
 室谷代表取締役
Qwen3.6-27B、2026年4月22日に出てるんですよね。Qwen3.6-Plus、Qwen3.6-35B-A3Bに続く第三弾で、公式の見出しが「Flagship-Level Coding in a 27B Dense Model」なんですよ。
 テキトー教師DotAI 認定講師
見出しで言いたいことが完結してますね。27Bの密モデルでフラッグシップ級のコーディングを狙う、と。
室谷代表取締役そして中身として、MoE構成の前世代フラッグシップ、総397Bで活性17BのQwen3.5-397B-A17Bをコーディング系ベンチで上回ったと主張してる。数字はこのあと個別に見ますけど、構造として面白いのは「全部のパラメータを毎回動かす」側が勝ったと言ってることなんですよね。
テキトー教師DotAI 認定講師そこ、感覚と逆なんですよ。MoEは必要なところだけ起こすから軽い、というイメージが先に立つので。
denseは毎トークン全部通るぶん素直だけど重い、と。
denseは毎トークン全部通るぶん素直だけど重い、と。
隠れ次元5120・64層、中身はハイブリッド構成
室谷代表取締役で、中身も素直じゃなくて。隠れ次元5120、層数64で、Gated DeltaNet→FFNを3回、Gated Attention→FFNを1回、の16ブロック構成のハイブリッド。
MTP込みで学習済みです。
MTP込みで学習済みです。
テキトー教師DotAI 認定講師ハイブリッドって聞くと身構える人、いますよね。全部が同じ注意力の層じゃない、ってことだけ押さえれば読む分には十分です。
室谷代表取締役実装する側からすると、この構成がそのまま速度とメモリに効いてくる。MYUUUだと「どのGPUを何枚置くか」の話に直結するので、論文の綺麗さより構成の素性の方が大事なんですよ。
テキトー教師DotAI 認定講師たしかに。スペック表の数字だけ追うと見えない部分ですね。
ネイティブ262,144トークン、YaRNで約100万トークンまで伸ばせる
室谷代表取締役コンテキストはネイティブで262,144トークン。YaRNスケーリングで最大1,010,000トークンまで伸ばせる、とモデルカードにあります。
テキトー教師DotAI 認定講師100万という数字だけ見ると全員が得するように思えるんですけど、伸ばすほど1トークンあたりの負荷は上がりますからね。
室谷代表取締役ここは経営目線だと分かりやすくて、長文を丸ごと入れる前提にすると推論コストの見積もり方が変わるんですよ。RAGで刻むか、全部突っ込むか、の判断が先に来る。
テキトー教師DotAI 認定講師実務だと「262Kで足りるなら拡張は切る」が基本線ですね。必要なときだけ広げる、と。
Vision Encoderを積んだマルチモーダルモデルという前提
室谷代表取締役あとこれ、Causal Language Model with Vision Encoder って書かれてて。テキスト専用じゃないんですよね。
テキトー教師DotAI 認定講師そこ、見落とされやすいです。27Bのdenseという字面だけで文章モデルとして捉えてしまって、画像が入る前提で使い道を考え直す発想にならない。
室谷代表取締役画像が入る前提だと、社内のスクショや図面をそのまま投げる使い方が現実味を帯びてくる。ワークフローごと変わるので、モデル単体のスペック比較じゃ済まない話です。
テキトー教師DotAI 認定講師逆にテキストしか使わないなら、この部分はいったん脇に置いていい。全部の機能を使わなきゃ、ではないので。
ThinkingとNon-Thinkingが1つのチェックポイントで切り替わる仕組み
室谷代表取締役で、ThinkingとNon-Thinkingが単一チェックポイントで切り替わる。別モデルを2本持たなくていい、と。
テキトー教師DotAI 認定講師これは運用がラクなんですよ。思考過程を出すモードと即答モードで重みが分かれてると、エンドポイントの管理が倍になりますから。
室谷代表取締役さらに preserve_thinking という、直前ターンだけでなく過去の全ターンの思考を保持するオプションが追加されてる。エージェントで回すときの判断の一貫性に効いてくる部分です。
テキトー教師DotAI 認定講師思考を毎回ゼロから作り直さないぶん、無駄なトークンも減るという建て付けなんですね。
2026年11月時点の位置づけ、後継Qwen3.8-27Bはもう出ている
Hugging Faceのモデルページには後継の案内が出ている
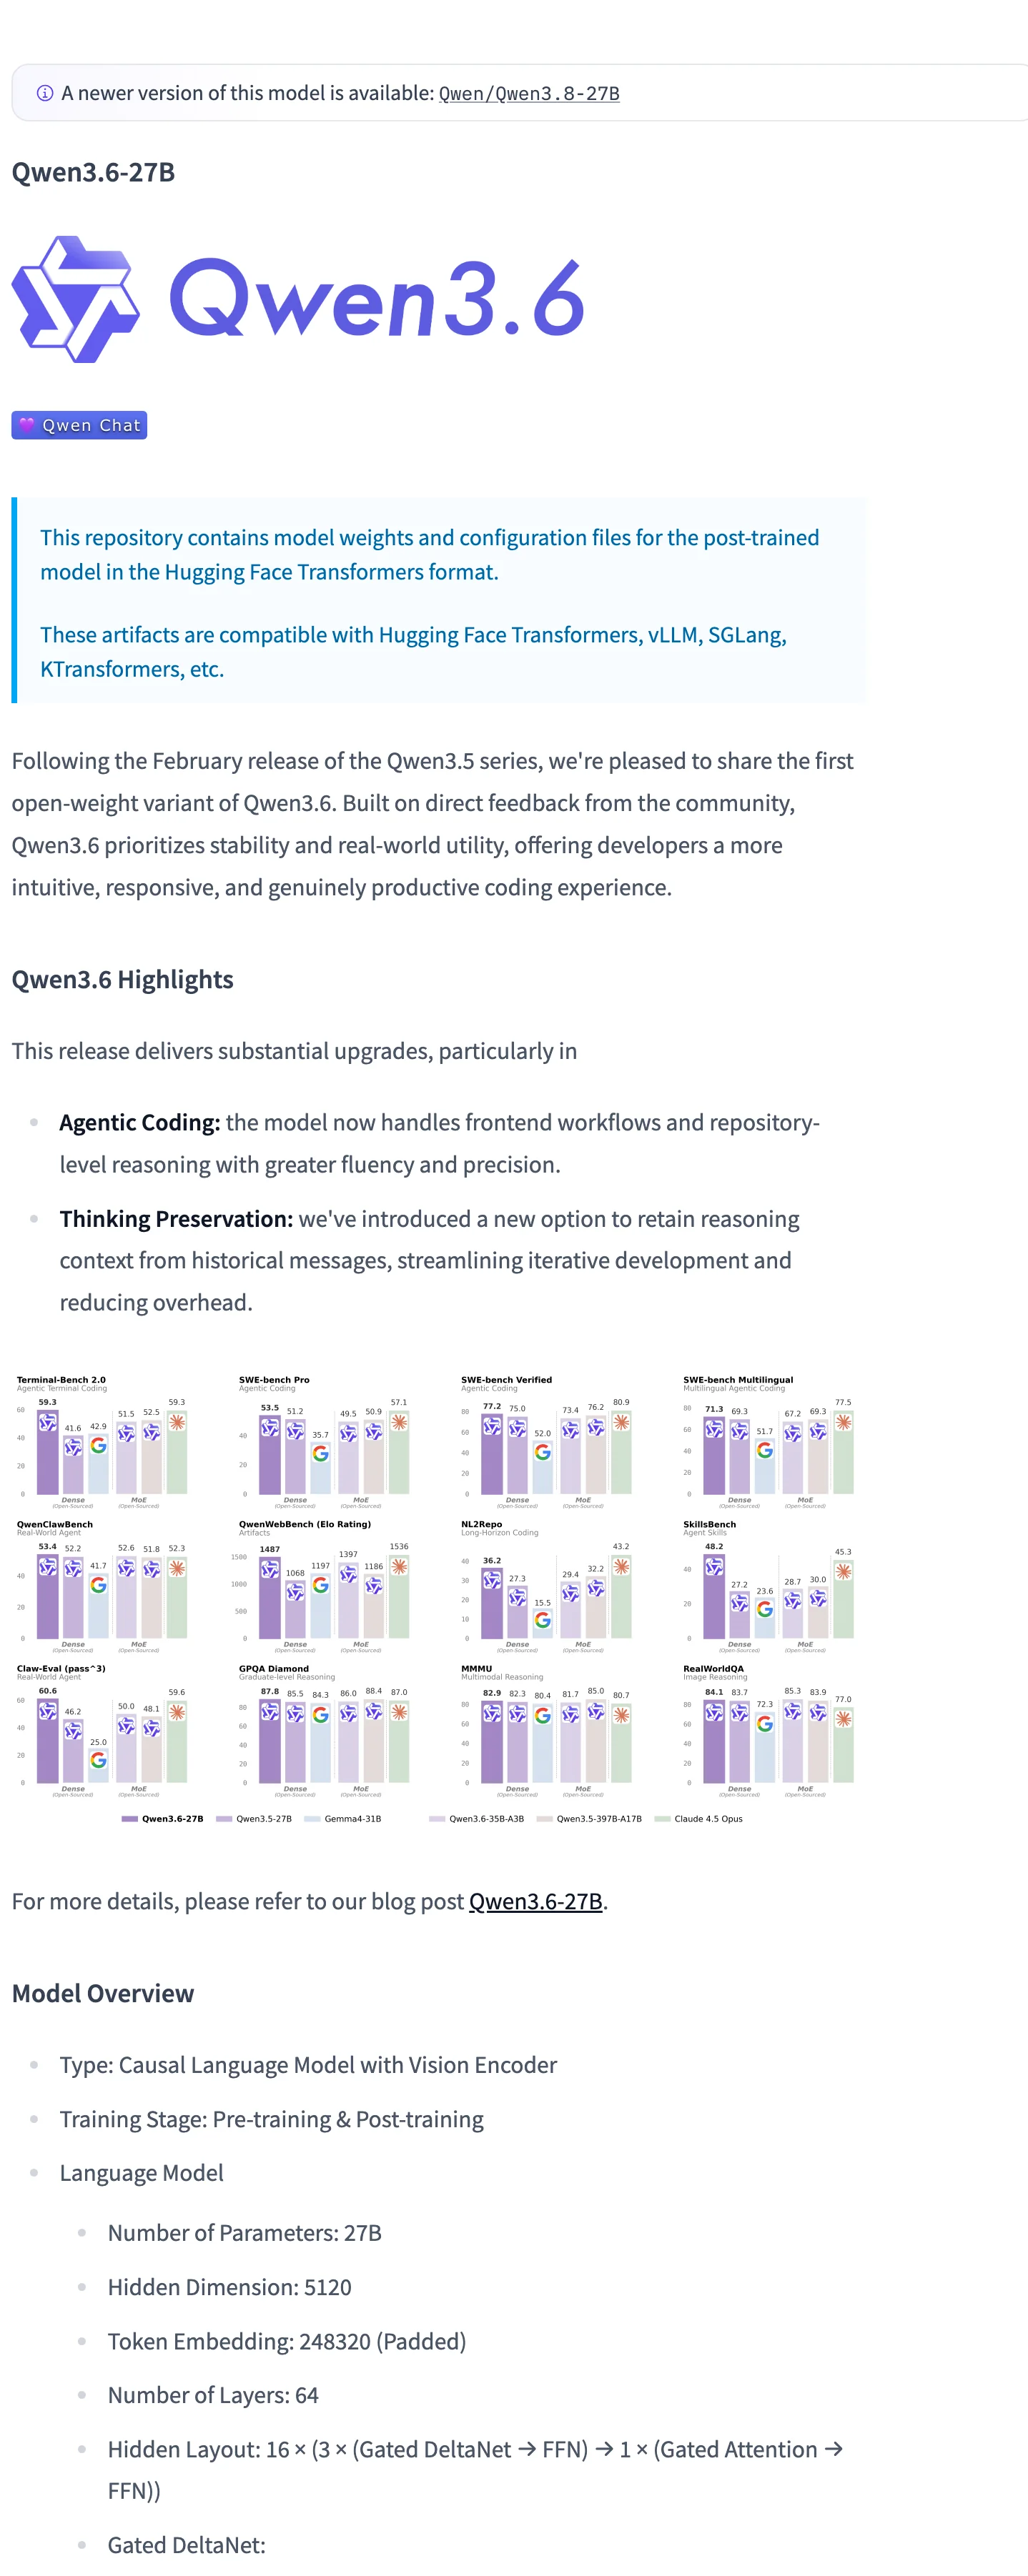
室谷代表取締役Qwen3.6-27Bのモデルページを開くと、上部に「A newer version of this model is available: Qwen/Qwen3.8-27B」というバナーが出るんですよ。公式が自分から「新しいのありますよ」と案内している状態で・・・
テキトー教師DotAI 認定講師そのバナー、見落とす人が多いんですよね。開いてすぐ重みの説明に目が行ってしまうので。
僕も最初は「何か帯が出てるな」くらいにしか思っていませんでした。
僕も最初は「何か帯が出てるな」くらいにしか思っていませんでした。
室谷代表取締役ここは素直に読むべきで。2026年4月22日に出たモデルが、11月の時点でもう一世代前、という整理になるわけです。
テキトー教師DotAI 認定講師世代が変わるスピードが速いので、古い記事を掴むと前提ごとずれるんですよ。ページ上部のバナーは一番手元にある一次情報なので、そこだけは毎回見たほうがいいと思います。
Unslothのモデル一覧でもQwen3.8系が別項目で並んでいる
室谷代表取締役Unslothのドキュメント、モデル一覧のサイドバーを見ると「Qwen3.8-27B」と「Qwen3.8-Flash-Next」が別項目で並んでるんですよ。量子化の入手経路として見ても、3.6が主役の場所ではなくなっている。
テキトー教師DotAI 認定講師一覧の並び順って地味に雄弁で。上から新しい順なので、3.6-27Bを探すと下のほうまでスクロールすることになります。
そこで「あ、後継があるんだ」と気づく流れですね。
そこで「あ、後継があるんだ」と気づく流れですね。
室谷代表取締役うちの使い方だとGGUFをどこから取るかで検証の工数が変わるので、一覧に載っているかどうかは実務の話なんですよ。Qwen3.8系の量子化についてはUnslothの「Qwen3.8-Flash-Next GGUF」とは?Dynamic V3.1で精度15%向上で解説しているので、続けて読むならそこです。
テキトー教師DotAI 認定講師並べて見ておくと、判断の材料が揃いますからね。
今から触るならQwen3.8-27Bか、それともQwen3.6-27Bか
今から触るならどちらを選ぶか
室谷代表取締役新しく環境を作る人に相談されたら、後継がある前提で考えたほうがいいですよ、と返します。一世代前をあえて選ぶ理由は、手順やサンプルが豊富とか、検証済みの構成が転がっているとか、そういうときだけですね。
テキトー教師DotAI 認定講師目的が「まず動かしてみる」なのか「既存の手順をそのまま再現したい」なのかで変わりますよね。再現したいだけなら、その手順が書かれた世代に合わせたほうが詰まらないですし。
室谷代表取締役検証を回す側の感覚で言うと、後継に寄せたほうが結果的に安いんですよ。古いほうで詰まった時間を人件費に換算すると、そっちのほうが高くつくので。
テキトー教師DotAI 認定講師最初の一回を作るコストと、詰まったときに払うコストを分けて見る感じですね。3.6-27Bがダメという話ではなくて、選ぶ理由を自分で説明できるかどうかの差だと思います。
ベンチマークの数字はどこまで信じていいのか
まず公式表を横に並べてみる
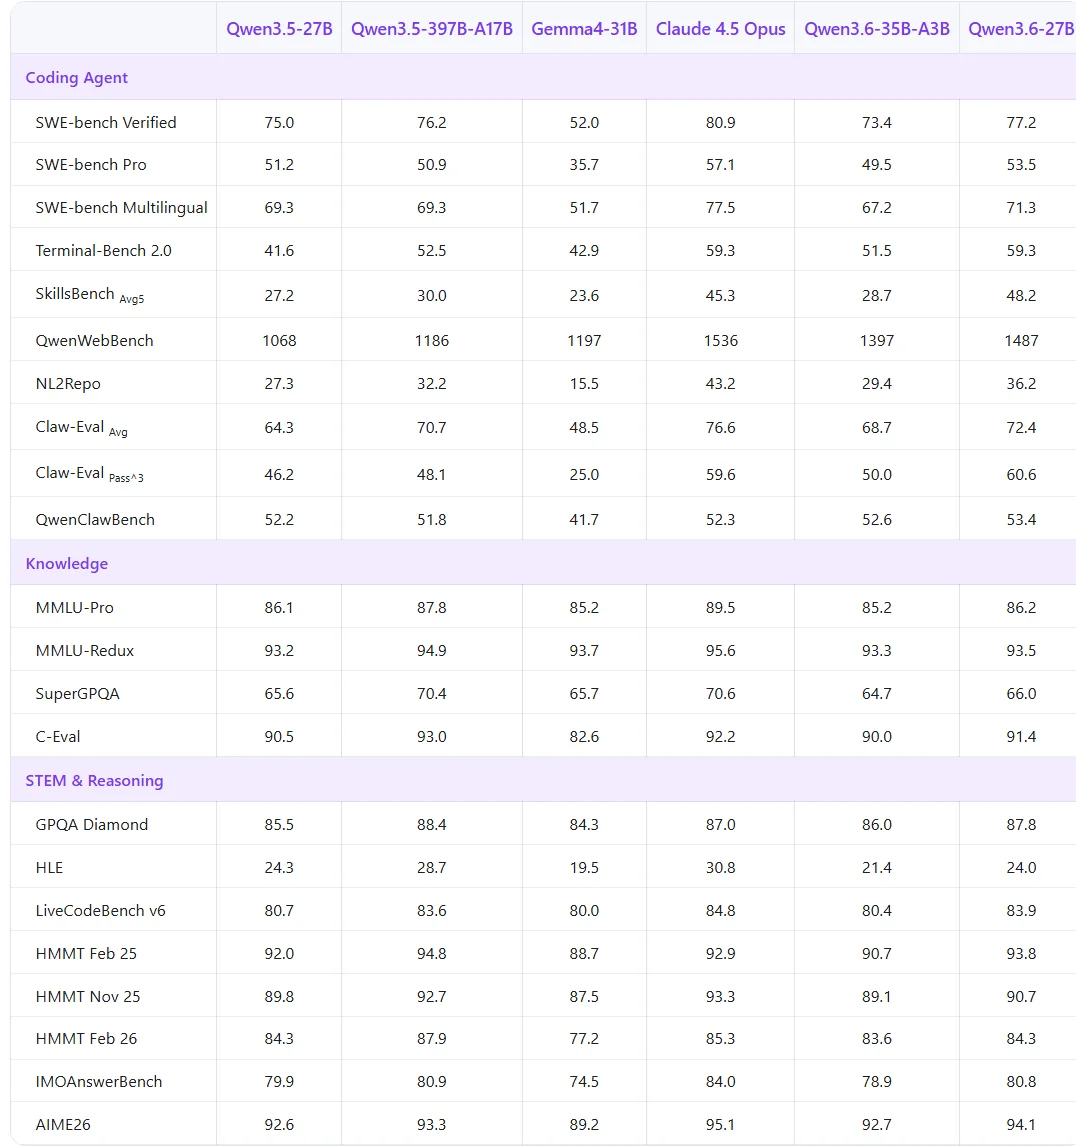
室谷代表取締役数字を先に並べますか。SWE-bench Verifiedが77.2、SWE-bench Proが53.5、Terminal-Bench 2.0が59.3、SkillsBench Avg5が48.2。
知識系だとMMLU-Pro 86.2、GPQA Diamond 87.8、AIME26 94.1です。
知識系だとMMLU-Pro 86.2、GPQA Diamond 87.8、AIME26 94.1です。
テキトー教師DotAI 認定講師並べてもらうと見やすいですね。ただ、この表を「すごい」で終わらせると読めないので、比較対象の列と一緒に見た方がいいんですよ。
室谷代表取締役同じ表に397B-A17Bが76.2、35B-A3Bが73.4、Gemma4-31Bが52.0、Claude 4.5 Opusが80.9で並んでる。27Bのdenseが397BのMoEを抜いてる、というのが公式の主張の芯なんですよね。
テキトー教師DotAI 認定講師そこが読みどころで。1ポイント差の勝ちと18ポイント差の勝ちを、同じ「上回った」で語ると印象が歪むんですよ。
差が開くベンチと、開かないベンチ
ベンチマーク別の差の出方(27B vs 比較対象)
| ベンチマーク | 27B | 397B-A17B | 35B-A3B | 差の傾向 |
|---|---|---|---|---|
| SWE-bench Verified | 77.2 | 76.2 | 73.4 | ほぼ並走(+1.0) |
| SWE-bench Pro | 53.5 | — | — | — |
| Terminal-Bench 2.0 | 59.3 | 52.5 | — | 大きく開く(+6.8) |
| SkillsBench Avg5 | 48.2 | 30.0 | — | 大きく開く(+18.2) |
| MMLU-Pro | 86.2 | — | — | 知識系(別軸) |
| GPQA Diamond | 87.8 | — | — | 知識系(別軸) |
| AIME26 | 94.1 | — | — | 知識系(別軸) |
室谷代表取締役差が大きく開くのがSkillsBenchで30.0から48.2、Terminal-Bench 2.0が52.5から59.3。逆にSWE-bench Verifiedは76.2から77.2でほぼ並走なんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、この差は「タスクの長さ」で説明がつく気がしてます。何手も続けるタイプの課題ほど差が出やすい。
室谷代表取締役なるほど。単発のパッチ当てより、端末で何十ステップも回す系の方が差がつく、と。
エージェント用途を推してる理由もそこに繋がるわけか。
エージェント用途を推してる理由もそこに繋がるわけか。
テキトー教師DotAI 認定講師そう読めますね。逆に「SWE-bench Verifiedで勝ってるから何でも上」とは言い切れない、というのが正直なところです。
Claudeとの距離と、Gemmaとの距離は意味が違う
室谷代表取締役Claude 4.5 Opusが80.9で、こっちが77.2。3.7ポイント届いてない。
ここを「ほぼ同等」と読むか「届いてない」と読むかで、導入判断は変わってしまうんですよ。
ここを「ほぼ同等」と読むか「届いてない」と読むかで、導入判断は変わってしまうんですよ。
テキトー教師DotAI 認定講師たしかに。初めて触る人は、この差を同点と受け取るか別格と受け取るかで、期待値がかなり振れます。
室谷代表取締役経営目線で言えば、その3.7ポイントにいくら払うかの話になる。従量で回すのと手元の27Bを回すのとで、同じタスクの単価が全然違うので。
テキトー教師DotAI 認定講師一方でGemma4-31Bの52.0との差はまた別で。こちらは同じ土俵に乗ってないくらいの開き方に見えます。
知識系の値はコーディングと切り離して読む
室谷代表取締役知識系も並んでて、MMLU-Pro 86.2、GPQA Diamond 87.8、AIME26 94.1。これは「賢さ」の指標であって、コードが書けるかとは別の軸なんですよね。
テキトー教師DotAI 認定講師ここを混ぜて読む人が多いんですよ。知識ベンチが高いから自分のリポジトリでも動く、にはならないので。
室谷代表取締役公式値は同じ条件で測った数字だから、条件を変えたら同じ値は出ない。参考値として扱うのが筋ですかね。
テキトー教師DotAI 認定講師そうですね。ただ表がqwen.aiのブログとHugging Faceのモデルカードで完全に一致しているので、少なくとも数字の出どころは一本化されている、と。
MoE版のQwen3.6-35B-A3Bとどちらを選ぶか
SWE-bench 73.4とTerminal-Bench 51.5、27Bとの差はどの程度か
Qwen3.6-35B-A3B(MoE) vs 27B(dense) の選び分け
室谷代表取締役数字を横に並べると、コーディングのSWE-bench Verifiedが35B-A3Bで73.4、27Bが77.2。ターミナル操作のTerminal-Bench 2.0になると51.5に対して59.3で、こっちの開きのほうが目立つんですよね。
テキトー教師DotAI 認定講師5ポイントとか8ポイントって、表の上だと「誤差かな」に見えるんですけど、エージェントを回していると差はもっと大きく感じます。段取りを何段も踏むタスクほど、その差が顔を出すんですよ。
室谷代表取締役SkillsBenchのAvg5は28.7と48.2で、ここはほぼ倍近い。単発の回答力ではなく、ツールを組み合わせて仕事を終わらせる力で差がついてる、という整理でいいですか。
テキトー教師DotAI 認定講師そう読めます。一問一答なら互角に近いのに、何手も続けると差が積み上がっていく。
Terminal-Benchの差はまさにそこに出ているんだと思います。
Terminal-Benchの差はまさにそこに出ているんだと思います。
活性パラメータが少ないMoEの速度優位と、denseの伸びしろ
室谷代表取締役反対側の売りが速度なんですよね。35B-A3Bは総パラメータ35Bに対して活性が3Bなので、計算としてはかなり軽い。
ここは素直に強い。
ここは素直に強い。
テキトー教師DotAI 認定講師体感で言うと、長いファイルを何度も書き換えさせる場面で待ち時間が違うと、作業のリズムそのものが変わるんですよ。速いモデルは「もう一回直させるか」という判断を後押ししてくれます。
室谷代表取締役一方でMTPの効き方は逆なんですよ。密の27Bが1.4倍前後、MoEの35B-A3Bは1.15〜1.25倍という記載でした。
もともと速い側に加速を足しても、伸び幅は小さく出る。
もともと速い側に加速を足しても、伸び幅は小さく出る。
テキトー教師DotAI 認定講師そこが面白いところで。MoEは「速いけど、あと乗せの余地は薄い」、denseは「素は遅いけど、加速を乗せると一気に来る」。
同じGPUでも印象が変わる部分です。
同じGPUでも印象が変わる部分です。
手元のGPUに載せる前提で、結局どちらを落とすか
室谷代表取締役手元に落とす前提だと、27Bのdenseは量子化で総メモリ15〜24GBあたりに収まる想定が出ています。必要とする資源が読みやすいのは、予算を組む側としては助かるんですよね。
テキトー教師DotAI 認定講師逆に35B-A3Bは、計算は軽いのに重みは35B分あるわけですから、載るかどうかはまた別の話になります。ここは手を動かして確かめるしかない領域ですね。
室谷代表取締役判断軸はシンプルで、品質の頭打ちを取りに行くなら27Bのdense、待ち時間とメモリ効率を優先するなら35B-A3B。どっちが上という話ではないんですよ。
テキトー教師DotAI 認定講師エージェントを何本も並走させたいなら速度側、一本をじっくり賢く回したいならdense側。その先の量子化版の話はUnslothの「Qwen3.8-Flash-Next GGUF」とは?Dynamic V3.1で精度15%向上にまとまっているので、載せ替えを考えている人はそっちも見ておくと判断しやすいです。
ローカルで動かすにはどのくらいのメモリが要るのか
量子化ビット別のメモリ目安
量子化ビット別の必要メモリと選び方(27B)
| 量子化 | 必要総メモリ | 24GB級1枚 | 48GB超構成 | 向くタスク例 |
|---|---|---|---|---|
| 3bit | 15GB | ○ | ○ | — |
| 4bit | 18GB | ○ | ○ | 要約・分類 |
| 6bit | 24GB | △ | ○ | — |
| 8bit | 30GB | × | ○ | 複数ファイル修正 |
| BF16 | 55GB | × | ○ | — |
室谷代表取締役Unslothの公式ドキュメントに必要メモリの表が出てるんですけど、27Bを動かすには3bitで15GB、4bitで18GB、6bitで24GB、8bitで30GB、BF16で55GBという目安なんですよね。MTP版はそれぞれ+1GB前後になります。
| 量子化 | 必要な総メモリ |
|---|---|
| 3bit | 15GB |
| 4bit | 18GB |
| 6bit | 24GB |
| 8bit | 30GB |
| BF16 | 55GB |
テキトー教師DotAI 認定講師この表、単位がRAM+VRAMの合計なんですよ。グラボの空き容量だけを見て「自分の環境じゃ無理だ」と判断してしまうケース、けっこうあります。
室谷代表取締役そこは誤解されやすいところで。システムRAMに逃がせば動きはするんですけど、速度は落ちるので、突き詰めると「速さを取るか、載せることを優先するか」のトレードオフになるんですよね。
テキトー教師DotAI 認定講師あとBF16の55GBって、24GB級のカード1枚だと素直には届かない数字なので、まずは量子化版から試すのが現実的だと思います。
24GB級か、48GB超かで選び方が変わる
テキトー教師DotAI 認定講師どのquantを選ぶかは、手持ちの構成でほぼ決まります。24GB級の1枚挿しなら4bitか6bit、48GBを超える構成なら8bitやBF16まで視野に入る、という分け方ですね。
室谷代表取締役4bitの18GBは24GB級でも余裕がある。6bitの24GBは数字上はぴったりで、コンテキストを長く取ると苦しくなる感覚があります。
MYUUUだと検証用に1台立てるか、クラウドを時間で借りるかの判断にも直結する話です。
MYUUUだと検証用に1台立てるか、クラウドを時間で借りるかの判断にも直結する話です。
テキトー教師DotAI 認定講師タスクの精密さでも変わります。複数ファイルをまたぐ修正のような場面では8bitに上げたときの安定感が効くことがある一方、要約や分類なら4bitで足りる。
まず4bitで当たりを取って、足りないところだけ上げるのが無駄が少ないと思います。
まず4bitで当たりを取って、足りないところだけ上げるのが無駄が少ないと思います。
室谷代表取締役Thinking向けとNon-Thinking向けの推奨設定
テキトー教師DotAI 認定講師サンプリングは、Thinkingを有効にするかどうかで推奨値が変わるんですよ。公式のモデルカードに載っている値を並べるとこうなります。
- Thinking(一般タスク): temperature=1.0、top_p=0.95、top_k=20
- Thinking(精密なコーディング): temperature=0.6
- Non-Thinking: temperature=0.7、top_p=0.8、presence_penalty=1.5
室谷代表取締役温度1.0と聞くと暴れないか心配になるんですけど、Thinking側は推論の幅を残す方向なんですね。コードをきっちり直したいときだけ0.6まで落とす、と。
テキトー教師DotAI 認定講師そういう振り分けが前提なんですよ。Non-Thinkingはpresence_penaltyが1.5と高めなので、同じ言い回しの繰り返しを避ける方向に寄っています。
1つのプリセットで全部まかなおうとすると、どこかで噛み合わなくなるので、用途ごとに2〜3個持っておくのが扱いやすいです。
1つのプリセットで全部まかなおうとすると、どこかで噛み合わなくなるので、用途ごとに2〜3個持っておくのが扱いやすいです。
室谷代表取締役設定を固定してしまうと検証の再現性は上がるけど、用途が広がらない。現場で回すなら、まずThinkingの一般設定で触ってみて、詰まったところだけ調整する順番が現実的ですね。
生成速度を上げる方法はあるのか、MTPとNVFP4量子化
MTPで1.4〜2.2倍、ドラフトトークンは2が最良という結果
室谷代表取締役MTP、これ学習の時点で仕込まれてるやつなので、こっち側で特別なことをしなくても効くんですよ。精度を落とさず1.4〜2.2倍で、RTX 6000だと毎秒160トークンという数字が出てます。
テキトー教師DotAI 認定講師同じモデルを同じGPUで回してるのに、体感がまるで別物になりますからね。ただ、ドラフトトークンは増やせばもっと速くなると思われがちなんですけど、そこは逆なんです。
室谷代表取締役そうなんですよ。2が最良で、4まで上げると受理率が83%から50%に落ちる。
数を撃てば当たる、という話じゃないんですよね。
数を撃てば当たる、という話じゃないんですよね。
テキトー教師DotAI 認定講師投機的な仕組みなので、外した分は丸ごと捨てになる。読み合いの精度が落ちたら元手が増えるだけ、という理解でいいと思います。
密モデルの27BのほうがMoEの35B-A3Bより伸びるのも、そこが効いてるんでしょうね。
密モデルの27BのほうがMoEの35B-A3Bより伸びるのも、そこが効いてるんでしょうね。
NVFP4はBlackwell世代専用、24GB VRAMで動くという条件
室谷代表取締役もう片方がNVFP4量子化で、こっちは条件つきです。NVIDIAのBlackwell世代、具体的にはRTX 50シリーズ、DGX Spark、B200/B300あたりが対象になります。
テキトー教師DotAI 認定講師手元のマシンで使えるかどうかが、まず最初の分岐点になるわけですね。24GBのVRAMで動いて、他のNVFP4量子化モデルより2.5倍速い、と。
室谷代表取締役量子化って「メモリに載るか」の話だと思われがちなんですが、載せたうえで速くもなる。ハードが揃ってるなら試さない手はないです。
テキトー教師DotAI 認定講師逆にそれ以前の世代だと、同じ手順を踏んでも恩恵は受けられないんですよ。ここは無理に追わなくていい部分だと思います。
速くしても精度は落ちないのか、MMLU-Pro等の比較表を読む
室谷代表取締役速くしたぶん精度が落ちるなら意味がない。で、比較表がこうなってます。
| 項目 | NVFP4(Unsloth版) | BF16版 |
|---|---|---|
| MMLU-Pro | 86.25 | 85.96 |
| GPQA | 86.34 | 88.13 |
| AIME2025 | 93.12 | 93.33 |
テキトー教師DotAI 認定講師ほぼ同じ水準に見えますね。GPQAだけ少し下がってますけど、これくらいなら誤差の範囲として読んでいいんじゃないでしょうか。
室谷代表取締役数字が並んでるのを見る限り、速度を取った代償がほとんど見えない。時給で換算するまでもなく、同じ精度で時間が半分になるなら入れない理由がないんですよね。
テキトー教師DotAI 認定講師ただ、この表は知識系の3項目なので、コーディングの実力は別で見たほうがいい。そこは前のベンチマークの話と合わせて読むべき部分です。
vLLMのバックエンドは何を選ばせるのが無難か
室谷代表取締役最後にバックエンド。Marlinは2.5倍遅くなるので使わない。
CUTLASS、Flashinfer-TRTLLM、Cute-DSLをvLLMに自動選択させるのが推奨されてます。
CUTLASS、Flashinfer-TRTLLM、Cute-DSLをvLLMに自動選択させるのが推奨されてます。
テキトー教師DotAI 認定講師つい自分で指定したくなるんですけど、選ばせたほうがいいんですよね。環境ごとに刺さるものが違いますから。
室谷代表取締役ここで変にこだわって遅くなってるパターン、正直もったいないなと。まず動かして、遅かったら設定を見る順番でいいと思います。
テキトー教師DotAI 認定講師量子化は世代が変わると前提も変わるので、次に何が来るかはUnslothの「Qwen3.8-Flash-Next GGUF」とは?Dynamic V3.1で精度15%向上あたりを眺めておくと流れが掴みやすいですよ。
APIとコーディングエージェントに繋ぐには何を設定するのか
まず揃えるのはキー・ベースURL・モデルIDの3つ
室谷代表取締役Model Studio、OpenAI互換とAnthropic互換の両方を出してるんですよね。だからエージェント側は、接続先とキーを差し替えるだけでQwen3.6-27Bに向けられる、という建て付けなんですよ。
テキトー教師DotAI 認定講師そこが一番伝わりにくくて。先に揃えるものが3つあるんです。
- Model StudioのAPIキー(環境変数
DASHSCOPE_API_KEYに入れる) - リージョンごとのベースURL(
DASHSCOPE_BASE_URL) - モデルID
qwen3.6-27b
室谷代表取締役ベースURLは北京リージョンだと
https://dashscope.aliyuncs.com/compatible-mode/v1 で、パスの末尾はどのリージョンも同じなんですよ。ドメインに -intl が入るとシンガポール、-us が入ると米国、という形で切り替わる。テキトー教師DotAI 認定講師なので覚えるのは「ドメインの形」と「末尾のパス」だけでいいですね。正確な文字列は公式ブログのコード例からコピーするのが確実です。
ここを手打ちして404を踏む人が多いので。
ここを手打ちして404を踏む人が多いので。
思考を出すか、持ち回るかの2つのスイッチ
テキトー教師DotAI 認定講師thinkingを有効にしたいときは、リクエストの
extra_body に enable_thinking を入れる形なんですよね。室谷代表取締役それに加えて今回入ったのが
preserve_thinking で。直前のターンだけじゃなくて、過去の全ターンの思考過程を保持する、というオプションなんです。テキトー教師DotAI 認定講師最初に戸惑うのがここで、「毎回思考を捨てるか、持ち回るか」で挙動が変わるんですよ。エージェントだと前の判断を忘れて同じ場所を回り続けることがあるので、一貫性が上がってトークンも節約できる、という整理になっています。
室谷代表取締役エージェント用途を想定した機能なので、単発のチャットで試しても違いが見えにくいんですよね。まずはエージェント側に通してから効きを比べるのが早いと思います。
Claude CodeはAnthropic互換の「別パス」に向ける
npm install -g @anthropic-ai/claude-codeでClaude Codeを入れる- 環境変数
ANTHROPIC_MODELとANTHROPIC_SMALL_FAST_MODELにqwen3.6-27bを設定 ANTHROPIC_BASE_URLにAnthropic互換のエンドポイントを設定。/compatible-mode/v1ではなく/apps/anthropicという別のパスになるANTHROPIC_AUTH_TOKENにAPIキーを設定claudeを起動
室谷代表取締役ここ、パスが2種類あるのが罠なんですよ。OpenAI互換のURLをそのまま貼ると繋がらない。
Anthropic互換は別パスで、ドメインはシンガポールの
Anthropic互換は別パスで、ドメインはシンガポールの
-intl 側、という構成になっています。正確な値は公式ブログで確認してほしいんですけど、構造だけ押さえれば迷わないはずです。テキトー教師DotAI 認定講師あと
両方
ANTHROPIC_SMALL_FAST_MODEL の存在を忘れる人が多いんですよ。軽い処理用に別のモデルIDを投げる枠なので、ここが空だと動作が不安定に見えることがある。両方
qwen3.6-27b を入れておくのが素直です。Qwen Codeはコマンド、OpenClawは設定ファイル
テキトー教師DotAI 認定講師残り2つは性格が違うんですよ。Qwen Codeはターミナル向けで、Node.js 20以上を用意して
npm install -g @qwen-code/qwen-code@latest、qwen で起動して /auth で認証、という流れです。室谷代表取締役OpenClawはセルフホスト型で、Node.js 22以上が必要なんですよね。
curl -fsSL https://molt.bot/install.sh | bash で入れて、~/.openclaw/openclaw.json にModel Studioのプロバイダー設定をマージする、と。テキトー教師DotAI 認定講師設定ファイル側が詰まりやすいところで。「どこに何を足すのか」が分からなくなるので、公式のサンプルをそのまま持ってきて既存のJSONに混ぜるのが安全です。
ゼロから書くとキー名をひとつ間違えただけで起動しなくなりますから。
ゼロから書くとキー名をひとつ間違えただけで起動しなくなりますから。
室谷代表取締役3つとも「キーとURLとモデルIDをどこに入れるか」が違うだけで、本質は同じなんですよ。だから1個通せば残りは早い。
まずClaude Codeで通して、慣れたら設定ファイル型に広げる順番が無駄がないと思います。
まずClaude Codeで通して、慣れたら設定ファイル型に広げる順番が無駄がないと思います。
実際に使うとどこで詰まるのか、向き不向きを正直に
足場作り・リファクタリング・テスト生成は実用という現場の声
室谷代表取締役Reddit の r/LocalLLM でも、Claude Code の代替として実用レベルに達したという投稿が並んでいます。SWE-bench Verified が 77.2 で、前世代の 397B MoE を上回っている数字ですから、27B の密モデルでここまで来たのは素直に驚きなんですよね。
テキトー教師DotAI 認定講師実際に触った人の話を聞いても同じで、既存コードの周りに足場を組む、テストを起こす、関数を切り出す、みたいな作業は「これで回るのでは」という反応になります。
室谷代表取締役ただ公式ベンチマークって、どうしても定型タスクに寄った指標なんですよ。数字がいい=何でも任せていい、にはならない。
テキトー教師DotAI 認定講師そうですね。テスト生成とリファクタは当たる、設計は別、という線がはっきり出ているのがこのモデルの特徴かなと思います。
ツール呼び出しのループとCSV処理の誤判断、6時間のデバッグ事例
室谷代表取締役評価より失敗例のほうが参考になるんですよ。ツール呼び出しの途中でループに入って抜けられなくなった、という報告があります。
テキトー教師DotAI 認定講師CSV の列ヘッダー処理を誤って、関連する機能まで無効化してしまって、そのまま6時間のデバッグ。同じタスクを Opus は20分で片付けた、というのが刺さります。
室谷代表取締役6時間と20分。時給換算すると差がそのまま費用になるので、任せっぱなしにする工程はリスクとして見ておくべきなんですよね。
テキトー教師DotAI 認定講師ループは放っておくと止まりませんから、ログを追うとか呼び出し回数で切るとか、外側の歯止めを先に決めてから走らせるのが安全です。
設計寄りの難しいタスクを任せるべきでない理由
室谷代表取締役設計寄りの難しいタスクは、いまも Claude の Opus や Sonnet に投げている、という報告が揃っています。業界構造で見ると、汎用フロンティアとローカル密モデルの役割分担が固まりつつある感じがしますね。
テキトー教師DotAI 認定講師設計って正解が一つに決まらないので、ベンチマークでは測りにくい領域なんですよ。ここが弱いのはサイズの問題というより、タスクの性質のほうです。
室谷代表取締役下書きと実装はローカル、判断は上位モデル。全部置き換える発想で組むと事故るんですよね。
テキトー教師DotAI 認定講師どこまで任せるかを先に決めておく、というのが結局一番効きます。
非公式ファインチューン版に手を出す前に確認したいこと
室谷代表取締役X を見ると、24GB 級の GPU で秒100〜160トークン出たという報告と並んで、検閲を外した非公式のファインチューン版が流通している。
テキトー教師DotAI 認定講師配布元が公式ではないので、学習データも更新方針も外からは分からないんですよね。業務で使うなら、そこを確認しないまま入れないほうがいいです。
室谷代表取締役公式の重みは Hugging Face と ModelScope で公開されているので、まずそこから。後継世代の量子化の話はUnslothの「Qwen3.8-Flash-Next GGUF」とは?で解説しています。
テキトー教師DotAI 認定講師非公式版は検証用途に留める、くらいの距離感がちょうどいいと思います。
よくある質問
Q1. 商用利用はできますか。ライセンスはどこで確認すればいい?
室谷代表取締役そこ、最初に確認すべきところなんですよね。重みが配布されているページにライセンスの記載があるので、使う前にそれを読む。
うちも導入前は必ず法務に通してます。
うちも導入前は必ず法務に通してます。
テキトー教師DotAI 認定講師この質問、本当に多いですね。モデル名で検索して出てきた二次情報だけを信じるより、配布元の記載をそのまま読む方が早いです。
条件が改訂されることもあるので、そこも見ておいた方がいいですね。
条件が改訂されることもあるので、そこも見ておいた方がいいですね。
室谷代表取締役あと、社内で使うのかプロダクトに組み込むのかで見るべき場所が変わってくるんですよ。組み込む前提なら、リリース前に一度チェックする工程を入れておくと後で揉めません。
Q2. 日本語の品質はどうですか?
室谷代表取締役英語のベンチだけ見て決めると、日本語の現場で「あれ?」となることがあるんですよね。うちは必ず自社の実データを一度通します。
テキトー教師DotAI 認定講師そうですね、評価用のプロンプトを先に作っておくのがおすすめです。翻訳調の文章を食わせたときの自然さ、敬語の崩れ方、固有名詞の扱い。
このあたりを見るだけでも印象がかなり変わります。
このあたりを見るだけでも印象がかなり変わります。
室谷代表取締役時給で換算すると、その検証に半日かけるのは全然安いんですよ。出てから直す方が高くつきますから。
Q3. ファインチューニングは現実的ですか?
室谷代表取締役27Bって、フルで回そうとするとそれなりのGPUが要るサイズなんですよね。まずプロンプトと RAG で足りないかを確かめて、それでも届かない部分だけ学習に回す。
順番はそっちが先だと思います。
順番はそっちが先だと思います。
テキトー教師DotAI 認定講師たしかに。いきなり学習から入るより、どこが足りないのかを先に言葉にした方が早いですね。
データを数百件そろえるだけでも、けっこう人手がかかりますし。
データを数百件そろえるだけでも、けっこう人手がかかりますし。
室谷代表取締役コストで見ると重いのは学習時間じゃなくてデータ整備なんですよね。金額より先に、人の時間が消えていきます。
Q4. CPUしかないマシンでも動かせますか?
室谷代表取締役動くには動くけど、待ち時間が発生する前提になるんですよね。ちょっとした整形や要約なら我慢できる範囲で、対話しながらコードを書く用途だと厳しいと思います。
テキトー教師DotAI 認定講師実際そこは分かれますね。応答を待つ時間が長くなったとき、人の手が止まるのか、別の作業に移れるのか。
バッチ処理なら気にならないけど、チャット欄の前で待つのはきついです。
バッチ処理なら気にならないけど、チャット欄の前で待つのはきついです。
室谷代表取締役載るかどうかとは別に、載った後の速度が実用になるかを見た方がいいです。うちだと、まず1日触ってから判断してます。
Q5. モデルのバージョンは固定した方がいいですか?
室谷代表取締役本番で使うなら固定した方がいいんですよね。重みが更新されると、同じプロンプトでも出力の癖が変わる。
再現性が消えるとデバッグが地獄になります。
再現性が消えるとデバッグが地獄になります。
テキトー教師DotAI 認定講師評価用のデータだけ残しておくと、更新時に同じ条件で比べられますね。比べる道具がないまま上げると、良くなったのか悪くなったのか分からなくなる。
あれ、地味に怖いです。
あれ、地味に怖いです。
室谷代表取締役新しいのが出たからすぐ乗せる、じゃなくて、評価セットが通ったら上げる、というルールにしてます。地味ですけど、これが一番効きます。
まとめ
室谷代表取締役オープンウェイトが27B級で出てくるたびに、自前で持つかAPIに逃げるかの損益分岐点が動くんですよね。今回はその分岐が少しこっち側に寄った、というのが率直なところです。
テキトー教師DotAI 認定講師手元で動くと、試す回数が増えるんですよ。課金を気にせず何十回も投げられる環境って、じわじわ効いてきます。
室谷代表取締役なので、まずは自分の用途を1つ決めて、それだけで1週間回してみるのがいいと思います。ベンチを眺めるより、その1週間の方が判断材料になります。
テキトー教師DotAI 認定講師賛成です。詰まったところをメモしておくと、次にモデルが変わったときに同じ場所でつまずかずに済みますし。
室谷代表取締役あと、メモリと速度の見積もりは早めに。動かせるかどうかで、検証のやり方そのものが変わってきますので。