DeepSeek V4 Flashは今もAPIで使える?名前と実体のズレを整理
旧名のままリクエストを投げても通るのか
 室谷代表取締役
まず最初に整理したいのが、昔のモデル名で投げたリクエストが今も普通に返ってくる、という点なんですよ。エラーで落ちてくれれば気づくんですけど、黙って別のモデルが処理してるので、コードを見ても異常に見えないんですよね。
 テキトー教師DotAI 認定講師
現場でよく聞くのが「モデル名は変えてないのに応答のクセが変わった」という声です。名前は同じでも中身が入れ替わっているので、そこに気づけないまま使い続けてしまうんですよ。
室谷代表取締役しかも課金はFlash料金のまま。請求額だけ眺めてると移行が起きたこと自体が見えないので、コスト管理の側からするとかなり嫌なパターンなんです。
テキトー教師DotAI 認定講師動いてるから大丈夫、で止まっちゃうやつですね。定期的にモデル名を見直す癖があったほうが安全です。
今の呼び出し名が指している実体
室谷代表取締役現行の呼び出し名はdeepseek-flashで、これが指す実体はDeepSeek-V4.1-Flash-1017なんですよ。だから名前だけ見て「Flashの旧版を使ってる」と思うとズレるわけです。
テキトー教師DotAI 認定講師旧名のdeepseek-v4-flashとvision-expのほうも引き続き受理されるんですが、実際に処理するのは1017で、料金はFlash扱いのまま。互換のための転送だと考えておくのがしっくりきます。
室谷代表取締役つまり利用者から見ると、投げる名前は複数あるのに、裏で働いてるモデルは一つ、という状態なんですよね。この構造を把握してないと、社内のコスト按分もモデル別に切れなくなります。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこで、名前ごとに違うモデルが動いてると思い込んでしまうんですよ。
V4-Flashから1017までの名前の移行を時系列で追う
DeepSeek V4-Flash 名前の移行と実体の変遷
- 2026/04/24DeepSeek-V4-FlashがPreview公開呼び出し名: deepseek-v4-flash
- 2026/09/10DeepSeek-V4.1-Flash公開、呼び出し名を統一呼び出し名: deepseek-flash。旧名はV4.1-Flashへ転送
- 2026/10/17改良版DeepSeek-V4.1-Flash-1017が公開呼び出し名: deepseek-flash(実体が1017に)
室谷代表取締役名前がどう動いてきたか、流れで並べたほうが理解が早いと思うので整理しましょうか。
| 時期 | 出来事 | 呼び出し名 |
|---|---|---|
| 2026/04/24 | DeepSeek-V4-FlashがPreview公開 | deepseek-v4-flash |
| 2026/09/10 | DeepSeek-V4.1-Flash公開、呼び出し名を統一。旧名はV4.1-Flashへ転送 | deepseek-flash |
| 2026/10/17 | 改良版DeepSeek-V4.1-Flash-1017が公開 | deepseek-flash(実体が1017に) |
テキトー教師DotAI 認定講師表にすると一本道に見えますけど、当時を追ってない人からすると名前が増えたように見えるんですよね。V4-ProとFlashの違いも含めて系譜を押さえたい人は、V4-ProとV4.1-Flashの違いを整理した記事のほうが読みやすいと思います。
室谷代表取締役大事なのは、同じモデルのはずなのに挙動が違う、という違和感の正体がこの移行にあると分かることなんですよ。名前を追うだけで、だいたいの謎は解けます。
V4-Flashの基本スペックとV4-Proとの違いはどこにある?
284B総・13B活性のMoE、文脈長1Mと最大出力384K
室谷代表取締役まず数字の整理からいきましょうか。V4-Flashは284B総パラメータで、実際に動くのは13BのMoEなんですよね。
文脈長1M、最大出力384K。総量は大きいのに活性は小さい、この構造が肝で・・・
文脈長1M、最大出力384K。総量は大きいのに活性は小さい、この構造が肝で・・・
テキトー教師DotAI 認定講師そこ、初めて触る人が一番混乱するポイントなんですよ。284Bと聞いて「ローカルは無理か」と諦めるんですが、実際に動くのは13Bぶん。
倉庫の広さと、その日トラックに積む荷物の量の話に近いというか。
倉庫の広さと、その日トラックに積む荷物の量の話に近いというか。
室谷代表取締役しかも推論モードが3段階あって。Non-think / Think High / Think Max。
MYUUUの現場だと、まずNon-thinkで流して足りないところだけ上げる使い方が多いです。出力トークンがそのまま原価なので。
MYUUUの現場だと、まずNon-thinkで流して足りないところだけ上げる使い方が多いです。出力トークンがそのまま原価なので。
テキトー教師DotAI 認定講師モードを原価とセットで見る感覚、一度身につくと戻れなくなりますよね。
V4-Proは1.6T総・49B活性、その差が効く場面
V4-FlashとV4-Proの比較
V4-Flash
- 284B総パラメータ・13B活性のMoE
- 文脈長1M・最大出力384K
- 推論モード3段階(Non-think / Think High / Think Max)
- Visionはdeepseek-flashで対応
V4-Pro
- 1.6T総・49B活性
- 重い処理を寄せる用途
- Visionは非対応
室谷代表取締役で、Proは1.6T総・49B活性。動く量だけで言えばFlashの何倍も違うのに、文脈長1Mと最大出力384Kは共通なんですよ。
ここが比較をややこしくしてる。
ここが比較をややこしくしてる。
テキトー教師DotAI 認定講師同じ土俵に見えて別物ですよね。長い設計書を丸ごと読ませて推論させるみたいな重い処理はProじゃないと厳しい。
逆に定型の要約や分類はFlashで十分すぎるくらいです。
逆に定型の要約や分類はFlashで十分すぎるくらいです。
室谷代表取締役あとVision。画像を扱えるのはFlash側だけなんですよ。
これは地味にデカい差で。
これは地味にデカい差で。
テキトー教師DotAI 認定講師あ、そうなんですね。資料のスクショを読ませたい案件だと、選択肢が一気に絞られる。
逆に言えば、そこが要らないなら規模の話だけで選べるということですし。
逆に言えば、そこが要らないなら規模の話だけで選べるということですし。
重みはHuggingFaceで公開、ライセンスはMIT
室谷代表取締役ローカルで動かせるのかという話だと、重みはHuggingFaceで配布されてます。FP8 MixedのBaseと、FP4+FP8の混合精度。
リポジトリも重みもMITライセンスなんですよね。
リポジトリも重みもMITライセンスなんですよね。
テキトー教師DotAI 認定講師MITというのは現場で効きますよ。「社内ツールに組み込んで大丈夫か」という確認が一気に通るので。
ライセンス不明のモデルだと、そこだけで数週間止まりますからね。
ライセンス不明のモデルだと、そこだけで数週間止まりますからね。
室谷代表取締役推論エンジンはTransformers、vLLM、SGLang、Docker Model Runnerあたりに対応。量子化版はOllamaやLM Studio、llama.cpp向けもある。
経営目線で言うと、API従量と自前GPUの固定費を同じ土俵で比べられるのが大きいんですよ。
経営目線で言うと、API従量と自前GPUの固定費を同じ土俵で比べられるのが大きいんですよ。
テキトー教師DotAI 認定講師ただ初期設定は素直に従ったほうがいいです。サンプリングはtemperature=1.0、top_p=1.0が推奨で、Think Maxを使うなら文脈長384K以上を確保しておく。
ここを外すと挙動が変わって「あれ?」となる人が多いので。
ここを外すと挙動が変わって「あれ?」となる人が多いので。
V4.1-Flash、そして1017で何が変わったのか?
9月10日の刷新、552BのMoEとアクティブ8B/16Bの分離
室谷代表取締役9月10日に出たDeepSeek-V4.1-Flash、ここが一番わかりにくいんですよね。552BのMoEなんですけど、新しいCausal Encoder-Decoder構成で、入力側8B・出力側16Bとアクティブパラメータが分かれてるんです。
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのがまさにそこで。「552Bって重すぎでは」と思うんですが、実際に動いているのは一部なんですね。
入力と出力で別のパラメータが働く、と説明すると納得されることが多いです。
入力と出力で別のパラメータが働く、と説明すると納得されることが多いです。
室谷代表取締役経営目線で言うと、入力トークンと出力トークンで原価がぜんぜん違うのに、同じ前提で見積もってる人が多いんですよ。出力側のアクティブが16Bで入力の倍ある、というのはコスト設計にそのまま効いてきます。
テキトー教師DotAI 認定講師そこ、料金表を読むときの前提になりますね。あと画像を扱えるのがFlash側だけ、というのも選定では効いてきます。
KVキャッシュがHBMで1/4、SSDで1/8に圧縮される意味
テキトー教師DotAI 認定講師長い文脈を入れるとメモリがきつくなる、というのは現場でよく聞く話で。1Mという数字だけ見ると「それだけ入るんでしょ」と思われがちなんですが、実際はキャッシュをどこに置くかが問題になるんです。
室谷代表取締役今回そこが前世代比でHBM使用量1/4、SSD使用量1/8になってるんですよね。同じハードで扱える文脈の量が変わるので、地味ですけど一番効く変更なんじゃないかと・・・
テキトー教師DotAI 認定講師たしかに。スペック表の「1M」だけ見て判断するより、キャッシュがどこに載るかを意識するほうが現場では効きます。
10月17日の1017、パレート改善の中身
室谷代表取締役で、10月17日のDeepSeek-V4.1-Flash-1017。出力トークンが前版より少なくて応答が速い、性能とコストのパレート改善という表現になってます。
DeepSeek Harness v0.2.1-rc.1以降の利用が推奨で、Tencent CodeBuddy/WorkBuddy向けの最適化も入ってる。
DeepSeek Harness v0.2.1-rc.1以降の利用が推奨で、Tencent CodeBuddy/WorkBuddy向けの最適化も入ってる。
テキトー教師DotAI 認定講師ベンチの数字を見ると差がはっきり出てるんですよ。公式モデルカードの数値だとこうなってます。
| 指標 | 1017 | 前版 |
|---|---|---|
| Terminal-Bench 4.0 | 42.3 | 31.2 |
| DeepSWE v1.1 | 77.0 | 74.2 |
| ProgramBench | 29.1 | 20.3 |
| NL2Repo-Bench | 68.2 | 65.4 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 |
| Apex Bench v1.1 | 72.1 | 64.6 |
室谷代表取締役エージェント系の指標が軒並み上がってるのが見える。応答が短くなったぶん、回数で回す側としては素直に効いてくるんですよね。
テキトー教師DotAI 認定講師同じ1017版を料金やピーク時間まで含めて見たい場合は、DeepSeek-V4.1-Flash-1017とは?料金・ピーク時間と実測、Search APIのほうが詳しいです。自分がどの版を叩いてるかは、レスポンスのモデル名で確認できますよ。
今の料金はいくら?ピークとオフピークで何が変わる
Flashの料金、キャッシュヒットと出力でいくらか
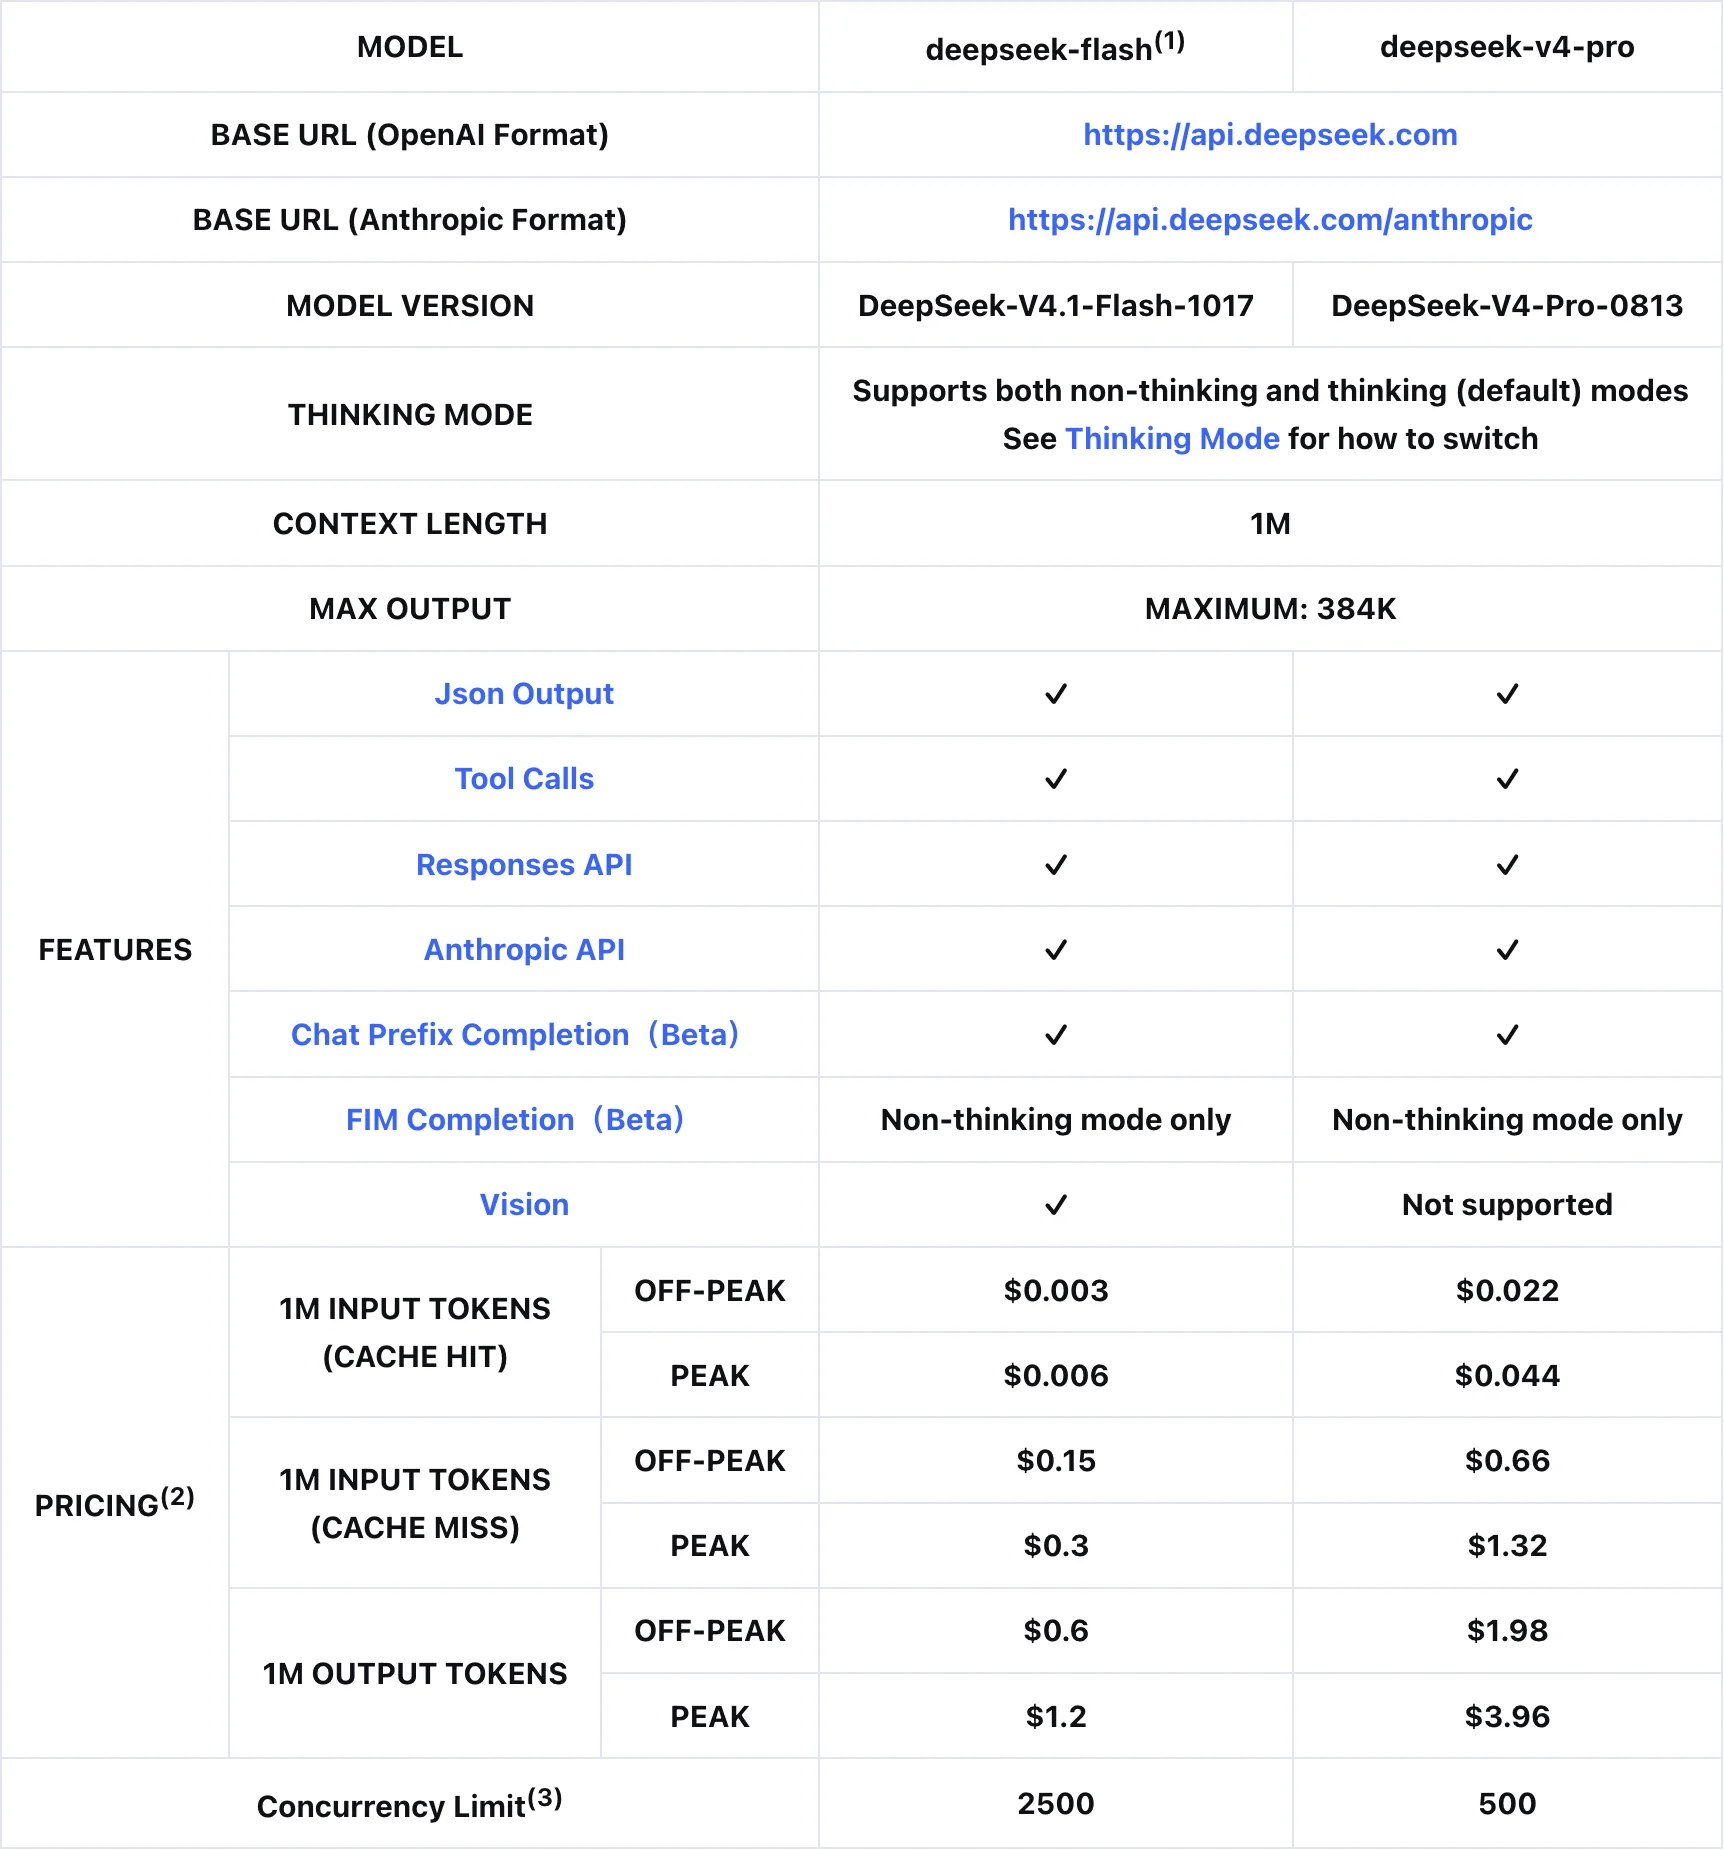
室谷代表取締役数字からいきますね。1Mトークンあたりの単価はこうなっています。
| 項目 | Flash オフピーク | Flash ピーク | Pro オフピーク | Pro ピーク |
|---|---|---|---|---|
| 入力(キャッシュヒット) | $0.003 | $0.006 | $0.022 | $0.044 |
| 入力(キャッシュミス) | $0.15 | $0.3 | $0.66 | $1.32 |
| 出力 | $0.6 | $1.2 | $1.98 | $3.96 |
テキトー教師DotAI 認定講師出力がキャッシュミスの4倍なんですね。長い資料を読ませるより、長い回答を書かせるほうが高い。
初めて触る人が最初に戸惑うのがここです。
初めて触る人が最初に戸惑うのがここです。
室谷代表取締役そうなんですよ。だから先に出力を短くする設計にする。
MYUUU の現場でも、返答の長さを絞るところから手を付けました。
MYUUU の現場でも、返答の長さを絞るところから手を付けました。
テキトー教師DotAI 認定講師順番が逆になる人が多くて。入力の節約から入って、出力で吹き飛ぶパターンです。
ピークはUTCの月〜金、日本時間だと2枠
室谷代表取締役ピークはUTCの月〜金で01:00-04:00と06:00-10:00。中国の祝日は除かれます。
日本時間に直すと10:00-13:00と15:00-19:00の2枠です。
日本時間に直すと10:00-13:00と15:00-19:00の2枠です。
テキトー教師DotAI 認定講師お昼を挟んで2回来るのが厄介で。12時台はオフピークなんですよね。
室谷代表取締役そこが抜けやすい。で、それ以外は全部オフピークで半額。
週末も半額です。
週末も半額です。
テキトー教師DotAI 認定講師夜間バッチを回す側からすると、この2枠を外すだけで単価が半分になる。日本時間に直した表を手元に置いておくといいですね。
同時実行数の2500と500、ここが効く使い方
室谷代表取締役見落とされがちなのが同時実行数の上限で、Flashが2500、Proが500です。
テキトー教師DotAI 認定講師あ、Proのほうが少ないんですね。性能が高いほうがたくさん並べると思い込んでいました。
室谷代表取締役ここは用途で効いてきます。大量のリクエストを並べるバッチなら、Flashの2500は素直に効く数字なんですよね。
単価だけでなく捌ける量で選ぶ話です。
単価だけでなく捌ける量で選ぶ話です。
7月時点の記事の数字をそのまま信じない
室谷代表取締役注意したいのが、7月時点の検証記事に出ている数字です。当時のV4-Flash-0731は入力$0.14、出力$0.28、キャッシュヒット$0.0028でした。
今の料金表とは前提が違います。
今の料金表とは前提が違います。
テキトー教師DotAI 認定講師検索で上に出てくる記事をそのまま見積もりに使うと、ズレた前提で設計しちゃうんですよ。当時の価格、と明示して読むのが安全ですね。
室谷代表取締役しかも当時はV4-Flash-Vision-Expがまだ動いていて、今は旧名のリクエストがV4.1-Flash-1017に転送されてFlashの料金で課金される。名前と課金の対応そのものが変わってるんですよ。
テキトー教師DotAI 認定講師そこは公式の料金ページで最新を見るのが確実ですね。数字は動く前提で、見積もりは都度取り直すくらいでちょうどいいと思います。
APIはどう呼び出す?モデル名・エンドポイント・最小のコード例
Base URLはOpenAI形式とAnthropic形式の2つ
室谷代表取締役まず接続先の話からなんですけど、Base URLはOpenAI形式が
https://api.deepseek.com、Anthropic形式が https://api.deepseek.com/anthropic の2本立てなんですよね。既存のSDKをそのまま向けられるのが効くところで。テキトー教師DotAI 認定講師ここで最初に戸惑うのが、どっちを使えばいいのか分からない点です。すでにOpenAI系のSDKで書いている人は前者、Claude向けの書き方を持っている人は後者、という選び方で大丈夫ですか。
室谷代表取締役そうですね、移行の話で言えば既存コードの差分が小さい方を選ぶのが正解です。書き直しが発生すると、そのぶん人件費が乗ってくるので。
テキトー教師DotAI 認定講師現場感覚で言うと、まずOpenAI形式で一度通してから、必要ならAnthropic形式を試す順番がつまずきにくいです。
modelに何を書くか——deepseek-flashとdeepseek-v4-pro
室谷代表取締役で、modelに何を書くか。今は
deepseek-flash と deepseek-v4-pro の2つが基本で、flashの実体は1017版なんですよ。テキトー教師DotAI 認定講師旧名の
deepseek-v4-flash や vision-exp もまだ受け付けてくれて、中身は1017で処理されるんですよね。古いコードがそのまま動いて驚く人が多いところです。室谷代表取締役ここは大きいポイントで、旧名で投げても課金はFlashの料金のまま。リネーム対応を後回しにできるのは、事業側からすると素直にありがたいです。
テキトー教師DotAI 認定講師最小のcurlとPythonで一度叩いてみる
室谷代表取締役最小の形はこんな感じです。まずはこれが通るかだけ確認する。
bash
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-flash",
    "messages": [{"role": "user", "content": "一文で自己紹介して"}],
    "max_tokens": 1024
}'PythonならOpenAIのSDKをbase_urlだけ向け替える形が短いです。パスやパラメータ名は公式クイックスタートの最新版に合わせてください。
python
from openai import OpenAI

client = OpenAI(api_key="...", base_url="https://api.deepseek.com")
res = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "一文で自己紹介して"}],
    max_tokens=1024,
)
print(res.choices[0].message.content)ここでmax_tokensをケチると本文が空で返る、という実測報告が以前の版のころにありましたよね。thinkingを使うときは余裕を持たせておく。
テキトー教師DotAI 認定講師初めて触る人がだいたい引っかかるのがそこです。思考トークンで枠を使い切ると本文が空になるので、まずは大きめに取って、返ってきた量を見てから絞るのが安全です。
JSON出力・Tool Calls・Visionの対応範囲
室谷代表取締役機能面だと、JSON出力・Tool Calls・Responses API・Anthropic API・Chat Prefix Completion(Beta)は両モデルとも共通で対応なんですよね。で、VisionだけはFlashのみ。
テキトー教師DotAI 認定講師画像を投げたいのにProを選んで詰まる、というのは現場でよく聞くパターンです。逆にFIM Completionはthinking時には使えないので、補完用途はそこだけ注意ですね。
室谷代表取締役構造で見ると、汎用はFlashに寄せて、重い推論だけProに回す形が組みやすい。同時実行数の上限も含めて、最初に設計へ入れておくべきところです。
テキトー教師DotAI 認定講師あとJSON出力は「JSONで返して」だけだと崩れることがあるので、欲しい項目を先に決めてから試すと安定します。
ベンチマークと実測レビュー、性能はどこまで信じていい?
公式モデルカードの数字を前版と並べる
公式モデルカード比較(V4.1-Flash → 1017)
| 指標 | V4.1-Flash | 1017 | 伸び幅 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | 大 |
| DeepSWE v1.1 | 74.2 | 77.0 | 微増 |
| ProgramBench | 20.3 | 29.1 | 大 |
| NL2Repo-Bench | 65.4 | 68.2 | 小 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | 中 |
| Apex Bench v1.1 | 64.6 | 72.1 | 大 |
室谷代表取締役先に数字を並べちゃいますね。1017は前版と比べてTerminal-Bench 4.0が31.2から42.3、ProgramBenchが20.3から29.1。
ターミナル操作まわりの伸びが目立つんですよ。
ターミナル操作まわりの伸びが目立つんですよ。
テキトー教師DotAI 認定講師数字だけ見ると「かなり賢くなった」に見えますよね。ただこれは公式モデルカードの同条件スコアなので、そのまま現場の体感には置き換わらないんです。
| 指標 | V4.1-Flash | 1017 |
|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 |
| DeepSWE v1.1 | 74.2 | 77.0 |
| ProgramBench | 20.3 | 29.1 |
| NL2Repo-Bench | 65.4 | 68.2 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 |
| Apex Bench v1.1 | 64.6 | 72.1 |
室谷代表取締役全部が大きく跳ねたわけじゃなくて、DeepSWEは74.2から77.0で微増なんですよね。で、参考としてK3、GLM-5.3、GPT-5.6 Sol、Opus 5のスコアも併記されてて、Opus 5が多くの項目で上にいる・・・
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんです。「全指標が上がった=何でも任せられる」ではない。
伸び幅が大きい領域とそうでもない領域が混ざってるので、自分の用途がどっち側かで見たほうがいいです。
伸び幅が大きい領域とそうでもない領域が混ざってるので、自分の用途がどっち側かで見たほうがいいです。
第三者検証:TODOアプリ生成に約5万トークン、3件のエラー
テキトー教師DotAI 認定講師コーディングの実測でよく引き合いに出されるのが、Spring Boot製のTODOアプリを作らせた検証です。生成に約5万トークンかかって、エラーが3件出た、という結果でした。
室谷代表取締役5万トークンって、出力単価で見れば金額は誤差なんですよ。問題はエラー3件を人間が直す工数のほうで、時給で換算するとそっちのほうがよほど高い。
安いから丸投げ、は短絡なんですよね。
安いから丸投げ、は短絡なんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのも同じ線引きです。「小さい関数単位ならかなり便利、アプリを丸ごと作らせるのはまだ怖い」。
この感覚に近いと思います。
この感覚に近いと思います。
室谷代表取締役ただしその検証は当時のV4-Flashでの話なので、1017でTerminal-Benchが伸びている以上、同じ結果になるとは限らない。古い実測を現在の評価にそのまま使うのは危ないですね。
エディタ統合でのコスト対性能はCursorの「DeepSeek V4.1 Flash」対応の記事で深掘りしてます。
エディタ統合でのコスト対性能はCursorの「DeepSeek V4.1 Flash」対応の記事で深掘りしてます。
Thinkingモードで本文が空になる罠と対処
室谷代表取締役実測で地味に刺さるのが、thinkingを切ったつもりが本文が空で返る件。当時の検証では、非thinking時にmax_tokensが足りないと思考トークンで枠を使い切り、本文が空になったと報告されてます。
テキトー教師DotAI 認定講師初めて触る人がこれに当たると「APIが壊れた」と思うんですよ。回避は整理するとこの3つです。
- thinkingを無効化する
- reasoning_effortをlowにする
- max_tokensを増やす
1017側では文脈長1M・max_tokens 256K以上が推奨されているので、余裕を持たせるのが無難ですね。
室谷代表取締役経営目線で言うと、この手の空レスポンスはリトライで吸収されがちで、気づかないまま課金だけ積み上がるんですよ。監視項目に入れておかないと後から効いてくる。
テキトー教師DotAI 認定講師あと当時の検証記事に出てくる料金は今の表より高いので、金額は現行の料金表に読み替えてください。数字の改善と現場の体感は、最後は自分のタスクで測るしかないです。
ローカルで動かせる?重み・推論エンジン・実測速度
重みはHuggingFaceで公開、FP8とFP4+FP8の2種類
室谷代表取締役前の章でベンチの話をしたので、ここは手元で動かす話を。V4-Flashの重み、HuggingFaceで公開されてるんですよね。
FP8 MixedのBase版と、FP4+FP8の混合精度版の2種類が配布されてます。
FP8 MixedのBase版と、FP4+FP8の混合精度版の2種類が配布されてます。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこなんですよ。「どっちを落とせばいいんですか」って必ず聞かれます。
手元のGPUがFP4を扱えるかどうかで変わるので、まず自分の環境を見る順番ですね。
手元のGPUがFP4を扱えるかどうかで変わるので、まず自分の環境を見る順番ですね。
室谷代表取締役ライセンスはリポジトリも重みもMITなんですよ。これは事業判断として地味に効くところで、社内ツールに組み込むとき法務の確認が軽くなる。
使うかどうかの決定が1週間早まるだけで、試作の回転が変わりますからね。
使うかどうかの決定が1週間早まるだけで、試作の回転が変わりますからね。
テキトー教師DotAI 認定講師ただ1017版の条件は公式ページで確認した方がいいですね。版が上がるとライセンス表記も配布形式も変わりうるので、そこは鵜呑みにしない方が安全です。
Transformers・vLLM・SGLang・Docker Model Runnerで動かす
室谷代表取締役動かす手段としては、Transformers、vLLM、SGLang、Docker Model Runnerあたりが想定されてる。あとは量子化されたモデルがOllama・LM Studio・llama.cpp向けにも多数出てるので、入口はかなり広いんですよね。
テキトー教師DotAI 認定講師現場感覚で言うと、初めて触る人は量子化版から入るのが現実的です。フルの重みをそのまま置こうとしてメモリで詰まる、というのを何度も見てます。
室谷代表取締役メモリの少ない環境で動かす道は別記事でかなり具体的に整理されてます。詳しくはDeepSeek V4.1-Flash-1017とは?Unslothが1-bit量子化で128GBローカル実行に対応で解説しています。
テキトー教師DotAI 認定講師あと推論時の推奨サンプリングがtemperature=1.0、top_p=1.0と決まってるので、そこを勘でいじらない方が出力は安定しますね。
RTX4060Tiで2.9 tok/s、M5 Maxで15〜25 tok/sという実測
室谷代表取締役で、速度なんですけど。ユーザーの検証報告では、RTX4060TiにRAM64GBという構成で2.9 tok/s、M5 Maxの128GB MacでDwarfStarという推論エンジンを使って15〜25 tok/sだった、と。
同じモデルでもここまで開くんですよ。
同じモデルでもここまで開くんですよ。
テキトー教師DotAI 認定講師これはGPUのメモリに載りきるか、あふれてCPU側に回るかの差なんですよね。数字だけ見ると「遅い」で終わりですが、中身は構成の話です。
室谷代表取締役2.9 tok/sは対話で使うにはかなりしんどい。常用するならAPIに投げた方が速いし安い、という判断に落ち着くケースが多いと思います。
ローカルは検証と実験用、という切り分けが現実的ですね。
ローカルは検証と実験用、という切り分けが現実的ですね。
テキトー教師DotAI 認定講師Think Maxを使いたい場面だと、V4-Flashのページでは文脈長384K以上が推奨されていて、そこまで確保すると余計に重くなります。試すなら短いプロンプトから段階的に、が現実的ですね。
Search・Fetch・Full-Suite App API、2026年11月の新機能
Search・Fetchが全ユーザー開放
室谷代表取締役10月17日のアップデート、モデル本体より周辺APIのほうが実務インパクト大きいんですよね。Web検索とFetchが全ユーザーに開放されたので、外部情報を取りに行く導線が公式で完結するようになった。
テキトー教師DotAI 認定講師現場でよく聞くのは「モデルが知らない情報をどう取ってくるか」なんですよ。検索を自前で繋ごうとすると、そこが最初の壁になるので。
室谷代表取締役しかもDeepSeek Harness・Claude Code・Codex経由のサーバーサイド呼び出しは、10月31日16:00 UTCまで無料だった。期限付きの無料開放は試すきっかけとして上手いやり方だと思います。
テキトー教師DotAI 認定講師期限があると一気に触りますね。ただ無料で動いてるうちは課金が見えないので、その後にいくらかかるかは先に把握しておいたほうがいいです。
1,000件あたり$0.75
室谷代表取締役検索もFetchも1,000件あたり$0.75。1件に割るとかなり小さいので、人が手で調べてる時間を時給で換算すると、まず負けることのほうが多いんですよね。
テキトー教師DotAI 認定講師実感として、検索って1回で終わらないんですよ。エージェントに調べさせると往復が増えて、件数がじわじわ膨らみます。
室谷代表取締役だから設計は呼び出し回数のほうが大事。だらだら検索させる実装は、そのまま請求書に出てくるので。
テキトー教師DotAI 認定講師たしかに。単価が安いからと回数を放置すると、逆に読めない数字になりますね。
Full-Suite App APIで何が増えたか
2026年10〜11月 周辺APIの主な動き
- 2026年10月17日Web検索・Fetch APIを全ユーザーに開放料金はどちらも1,000件あたり$0.75
- 2026年10月31日 16:00 UTCまでサーバーサイド呼び出しが無料(期間限定)DeepSeek Harness・Claude Code・Codex経由
- 2026年11月13日Full-Suite App APIを追加公開Web検索、ファイル入力、URL読み取り、モデルセーフティ、ASR、TTSを含む一套
室谷代表取締役11月13日にFull-Suite App APIが追加されて、Web検索に加えてファイル入力、URL読み取り、モデルセーフティ、ASR/TTSまで一通り載った。周辺機能が1か所にまとまってきた印象です。
テキトー教師DotAI 認定講師バラバラのAPIを繋ぎ合わせる手間が減るのは、初めて触る人にはかなり大きいんですよ。音声の入出力まで同じ導線で行けますし。
室谷代表取締役単価も個別に出ていて、ファイル解析・OCRが1,000ページあたり$0.225、TTSが1万字$0.45で期間限定の半額が$0.225、ASRが1時間$0.116で半額が$0.058。
テキトー教師DotAI 認定講師ページ単位、文字数単位、時間単位とバラバラなのが、見積もる側からすると一番混乱するところなんですよね。ここは表にしてから社内に共有したほうがいいです。
名前は変わる、だから公式のリリースノートを見る
室谷代表取締役この界隈、モデル名もAPIの顔ぶれも数か月で変わる。今回もdeepseek-flashの実体が差し替わって、旧名のリクエストは新しい版に転送される形になっている。
テキトー教師DotAI 認定講師初めて触る人は、少し前に書かれた記事のとおりに動かして噛み合わず戸惑うんですよ。基準を一次情報に置くしかないんですよね。
室谷代表取締役経営目線でも、社内の実装がどの版を指しているか把握していないと、コストも挙動も読めなくなる。名前は変わる前提で運用を組んでおくべきだと思います。
テキトー教師DotAI 認定講師ですね。機能が増えるほど、追いかける場所を1つに決めておくのが結局いちばん安上がりなんですよ。
リリースノートを定期的に眺める習慣だけで、だいぶ事故が減ります。
リリースノートを定期的に眺める習慣だけで、だいぶ事故が減ります。
よくある質問
Q1. OpenAI互換のSDKからそのまま呼べる?
室谷代表取締役既存のクライアントを流用できるかどうかは、移行コストに直結するんですよね。接続先とモデル名の2箇所を差し替えるだけで動くなら、検証のハードルは一気に下がります。
テキトー教師DotAI 認定講師現場でよく聞くのは「呼び出しの形は同じなのに、返ってくる内容の癖が違う」という戸惑いですね。パラメータの意味が同じとは限らないので、まず小さなプロンプトで挙動を見るのが早いです。
室谷代表取締役そうなんですよね。疎通確認だけで終わらせず、出力フォーマットの安定性まで見ておかないと、本番で静かに事故るんですよ。
Q2. 日本語の文章生成の品質はどう?
テキトー教師DotAI 認定講師初めて触る人がいちばん気にするのがここで。翻訳調になりやすいか、自然な日本語で返るかは、タスクの種類によって体感が変わるんですよ。
室谷代表取締役単価だけ見て切り替えると、あとから修正の手間が乗ってくるんですよね。時給で換算すると、直しのコストのほうが高くつくケースは普通にあります。
テキトー教師DotAI 認定講師たしかに。短い要約と長文の言い回しでは全然違うので、自分の用途の文章で試すのが結局いちばん正確です。
Q3. レート制限や障害のときはどう備える?
室谷代表取締役単一のモデルに全部を寄せる設計は、事業目線だとちょっと怖いんですよね。制限に当たった瞬間に処理が止まるなら、それは性能の問題じゃなくて可用性の問題なので。
テキトー教師DotAI 認定講師実装の話で言うと、リトライの回数と待ち時間を先に決めておく、失敗したら別のモデルに逃がす。この2つを最初から入れておくと後が楽です。
あとから足すと、だいたい漏れますから。
あとから足すと、だいたい漏れますから。
室谷代表取締役あとは失敗率をログで見ておくことですね。黙って劣化していくのが一番たちが悪いので。
Q4. 他のモデルと使い分けるべき?
テキトー教師DotAI 認定講師1本に絞る必要はないと思います。軽い処理は安いモデル、判断が難しいところだけ上位のモデル、という振り分けは現場でもよく見ます。
室谷代表取締役構造的に見ると、1社に固定する前提で組む時代はもう終わってるんですよね。ルーティングを自前で持つのか、抽象化する層を挟むのか、そこが設計の分かれ目になります。
テキトー教師DotAI 認定講師そうですね。ただ振り分けを増やすほど検証も増えるので、最初は2パターンくらいから始めるのがちょうどいいです。
Q5. コストの監視はどうやる?
室谷代表取締役MYUUU の現場だと、モデル名ごとにトークン量を集計できるようにしてます。名前が切り替わる前提でタグを切っておかないと、後から比較できなくなるんですよ。
テキトー教師DotAI 認定講師最初に戸惑うのが、思ったより入力側のトークンで費用が膨らむ点ですね。プロンプトを毎回長く貼っていると、じわじわ効いてきます。
室谷代表取締役キャッシュが効く部分と効かない部分を分けて考えると、ROI の見え方が変わりますね。
まとめ
室谷代表取締役名前がころころ変わるモデルを追いかけるのは、正直コストがかかるんですよね。だから「今どの名前が正なのか」を1箇所にまとめて管理する。
そこさえ決めておけば、切り替え自体は怖くないです。
そこさえ決めておけば、切り替え自体は怖くないです。
テキトー教師DotAI 認定講師現場感覚で言うと、動くコードを1本持っておくのが強いです。モデル名を差し替えて同じテストを流せれば、変更の影響がすぐ見えますから。
室谷代表取締役あとは性能の数字を信じすぎないことですね。ベンチが良くても、自社のタスクで勝つとは限らないので。
小さく試して、結果で判断するのが結局いちばん速いです。
小さく試して、結果で判断するのが結局いちばん速いです。
テキトー教師DotAI 認定講師そうですね。まず小さな検証から始めて、費用と出力の両方を見る。
そこで納得できたら本番に広げる、という順番が安心だと思います。
そこで納得できたら本番に広げる、という順番が安心だと思います。