GLM-5とは何か。どの企業がいつ出したモデルなのか
開発元のZ.ai(智谱AI)はどんな会社か
 室谷代表取締役
まず主語をはっきりさせておくと、GLM-5を作ったのは中国のZ.ai、中国名で智谱AIという会社です。日本だとモデル名だけが先に流通してて、開発元の顔が見えてないんですよね。
 テキトー教師DotAI 認定講師
現場でも「これどこの会社のモデルですか」から始まる人は多いです。名前だけ覚えてると、後から情報を追うときに出典をたどれなくなっちゃうんですよ。
室谷代表取締役ここ、業界構造として見るとわかりやすくて。モデルを作る層と、それをAPIやクラウドで売る層って分かれてるんですよ。
Z.aiは自分で作って自分でAPIも出す側なので、価格も提供条件も自社で決められる立場なんですよね。
Z.aiは自分で作って自分でAPIも出す側なので、価格も提供条件も自社で決められる立場なんですよね。
テキトー教師DotAI 認定講師なるほど、作る人と売る人が同じだと話が早い場面が多いと。そこが把握できてると、料金の話も読み解きやすくなりますね。
公開日とライセンス、オープンウェイトで出た意味
室谷代表取締役発表は2026年2月12日の公式ブログです。AWS Bedrockのモデルカードだと開始日が2月11日、EOLが2027年2月11日でステータスはアクティブになってます。
発表とクラウド反映で1日ずれるのはよくあることです。
発表とクラウド反映で1日ずれるのはよくあることです。
テキトー教師DotAI 認定講師その細かいズレ、初めて触る人が最初に戸惑うところなんですよ。「11日と12日、どっちが正しいの」って。
月単位で押さえておけば実用上は困らないです。
月単位で押さえておけば実用上は困らないです。
室谷代表取締役で、ここがGLM-5の一番デカい特徴で。重みがHugging FaceとModelScopeでMITライセンスの下に公開されてるオープンウェイトなんですよ。
自前でホストできる選択肢が残るってことです。
自前でホストできる選択肢が残るってことです。
テキトー教師DotAI 認定講師ライセンスが緩いと何が変わるかというと、社内の事情で「外のAPIには投げたくない」という案件でも検討の土俵に乗るんですよね。そこは現場感覚で大きいです。
名前の「GLM」と「5」が示しているもの
室谷代表取締役名前の話も少し。GLMはシリーズ名で、後ろの数字が世代を表す、という整理で読むのが素直なんですよね。
テキトー教師DotAI 認定講師ただ、番号がきれいに1つずつ進むわけじゃないんですよ。比較表に出てくるのはGLM-4.7で、その前にGLM-4.5があります。
飛び方があるので「数字が大きい方が新しい」くらいで見ておくのが安全です。
飛び方があるので「数字が大きい方が新しい」くらいで見ておくのが安全です。
室谷代表取締役そうなんですよね。5が付いた意味は「シリーズの次の大きな区切り」という受け取り方で、細かい中身は技術仕様の話になるので、そこは別で見た方がいいと思います。
テキトー教師DotAI 認定講師了解です。名前で迷ったら「シリーズ名+世代番号」で分解して読む、それだけで十分だと思います。
技術仕様はどうなっている?パラメータ数とコンテキスト長
744Bパラメータ・アクティブ40BのMoE構成とは
室谷代表取締役数字の話からいくと、GLM-5は744Bパラメータで、推論時に実際に動くのは40BだけのMoE構成なんですよね。前のGLM-4.5が355Bでアクティブ32Bだったので、器は倍以上に膨らんでるわけです。
テキトー教師DotAI 認定講師初めて触る人が戸惑うのがまさにそこなんですよ。「744B」って聞くと巨大なGPUが必須に見えるんですけど、動くのが40Bなら体感はそこまで重くない、という整理が要るんです。
室谷代表取締役これマジで大事で、総パラメータは「知識の棚の広さ」、アクティブは「一回に開ける冊数」なんですよ。棚を増やしても開く冊数を抑えれば、推論コストは跳ねない。
そこが設計判断なんですよね。
そこが設計判断なんですよね。
テキトー教師DotAI 認定講師なるほど、倉庫を大きくしてもフォークリフトの台数は増やさない、という話ですね。その喩えなら現場でも伝わります。
GLM-4.5から何がスケールしたのか
テキトー教師DotAI 認定講師学習データのほうも増えてるんですよね。事前学習が23Tトークンから28.5Tトークンへ、と。
パラメータだけじゃなくて読む量も増やしてるのがポイントで。
パラメータだけじゃなくて読む量も増やしてるのがポイントで。
室谷代表取締役そこは評価してて。モデル開発ってパラメータだけ盛ると学習コストが効いてこなくなるんですよ。
データを増やして、推論は軽くする。事業目線で見ても筋が通ってるなと。
データを増やして、推論は軽くする。事業目線で見ても筋が通ってるなと。
テキトー教師DotAI 認定講師現場でよく聞くのは「数字が大きくなった=遅くなった」という心配なんですけど、今回は狙いが逆なんですね。
室谷代表取締役そう。作る側のコストと使う側のコストを同時に下げにいく。
2026年のモデルの作り方って、そういう方向なんだろうなと思ってます。
2026年のモデルの作り方って、そういう方向なんだろうなと思ってます。
DeepSeek Sparse Attentionが効く理由
室谷代表取締役で、その推論を軽くする装置がDeepSeek Sparse Attention、DSAですね。長い文脈を全部見に行かず、必要なところだけ参照する。
注意の張り方を間引くイメージです。
注意の張り方を間引くイメージです。
テキトー教師DotAI 認定講師比喩で言うと、議事録を全部読み返すんじゃなくて、関係するページだけ付箋を貼っておく感じですか。
室谷代表取締役近いですね。コンテキストが長くなるほど効いてくるので、エージェントみたいに長い入出力を回す使い方ほど差が出る。
MYUUUの現場でも、長い前提を毎回食わせる運用はコストに直撃するんですよ。
MYUUUの現場でも、長い前提を毎回食わせる運用はコストに直撃するんですよ。
テキトー教師DotAI 認定講師それは実感ある人が多いと思います。長い資料を読ませると、料金も待ち時間も一気に増えますからね。
200Kコンテキスト・最大出力128Kで何が変わるか
テキトー教師DotAI 認定講師公表されている仕様だと、コンテキストが200Kトークンで、最大出力が128Kトークンなんです。出力をここまで長く取れるのは、エージェント用途では大きいですよね。
室谷代表取締役出力側が長いのは見落とされがちなんですけど、コードを丸ごと書き換えるみたいな作業だと効くんですよ。入力だけ長くても、返ってくる量が短いと仕事にならないので。
テキトー教師DotAI 認定講師たしかに。最初に戸惑うのが、入力の上限ばかり気にして出力の上限を見てないパターンなんですよ。
そこを分けて考えると選びやすくなります。
そこを分けて考えると選びやすくなります。
室谷代表取締役細かい数値や最新の仕様は公式やAWSのモデルカードで確認してほしいんですけど、設計思想としては「長く入れて、長く返す」。そこを押さえておけば十分かなと。
性能はどのくらい?Claude OpusやGPT-5.2との比較
GLM-5と主要モデルのベンチマーク比較
| ベンチマーク | GLM-5 | GLM-4.7 | Claude Opus 4.5 | GPT-5.2 | Gemini 3.0 Pro |
|---|---|---|---|---|---|
| SWE-bench Verified | 77.8 | 73.8 | 80.9 | 80.0 | - |
| Terminal-Bench 2.0 | 56.2〜61.1 | - | 57.9 | - | - |
| Vending Bench 2(最終資産) | 4,432.12ドル | 2,376.82ドル | 4,967.06ドル | - | 5,478.16ドル |
| HLE | 30.5 | - | - | - | - |
SWE-bench Verifiedで見るコーディング力
室谷代表取締役SWE-bench Verified、GLM-5が77.8なんですよ。Opus 4.5が80.9、GPT-5.2が80.0。
数字だけ並べると負けてるんですけど、この数ポイントの差をどう読むかで話が変わってくる・・・
数字だけ並べると負けてるんですけど、この数ポイントの差をどう読むかで話が変わってくる・・・
テキトー教師DotAI 認定講師たしかに。初めて触る人は「負けてるなら意味ないのでは」で止まりがちなんですけど、前のGLM-4.7が73.8なので、そこから着実に上がってはいるんですよね。
室谷代表取締役そうなんです。オープンウェイトのモデルがクローズドのトップにこの距離まで詰めてる、という事実のほうが業界的には重くて。
選択肢として普通に成立してるんですよ。
選択肢として普通に成立してるんですよ。
テキトー教師DotAI 認定講師現場感覚で言うと、77点と81点の差より「手元の環境で動かせるかどうか」で選んでる人のほうが多い気がします。
Terminal-Bench 2.0と長時間エージェント任務の差
室谷代表取締役Terminal-Bench 2.0をClaude Codeのハーネスで測った数字が56.2から61.1。Opus 4.5が57.9なので、検証版の上側だと並ぶか上回る計算になるんですよね。
テキトー教師DotAI 認定講師同じベンチマークで並べてくれてるのがありがたいですね。エージェントを長く走らせる系のタスクは、モデルの地力より「途中で投げ出さないか」が出やすいので。
室谷代表取締役まさにそこなんですよ。Z.aiも複雑なシステムエンジニアリングと長時間のエージェントタスクに最適化したと説明していて、単発のコード生成より何十ステップも回す前提の作りになってる。
うちの現場でも、そういうタスクは途中停止が一番コストになるので。
うちの現場でも、そういうタスクは途中停止が一番コストになるので。
テキトー教師DotAI 認定講師最初に戸惑うのがまさにそこですよね。1問解けるかより、10分走らせて壊れないか、という見方に変わる。
Vending Bench 2とHLEが示す「実務で稼ぐ力」
室谷代表取締役Vending Bench 2は1年分の自販機運営を模擬して最終資産額で競う指標で、GLM-5が4,432.12ドル。オープンソース勢では1位なんですよ。
Opus 4.5が4,967.06ドル、Gemini 3.0 Proが5,478.16ドル、GLM-4.7が2,376.82ドルなので、前世代からほぼ倍になってる。
Opus 4.5が4,967.06ドル、Gemini 3.0 Proが5,478.16ドル、GLM-4.7が2,376.82ドルなので、前世代からほぼ倍になってる。
テキトー教師DotAI 認定講師この指標、意味がすごく分かりやすいんですよ。正解を書く力じゃなくて、判断を積み上げて最後にどれだけ残ったか、なので。
室谷代表取締役経営目線で言うと、こういう数字のほうが導入判断に近いんですよね。ベンチマークの1点差に一喜一憂するより、任せて放置したときに収支がどう動くか。
テキトー教師DotAI 認定講師HLEが30.5というのも、難しい問題を考え切る地力の話で。現場では「この2つを場面で使い分ける」くらいの感覚がちょうどいいのかもしれないですね。
料金はいくら?API価格とコストパフォーマンスの話
APIは入力1ドル・出力3.2ドル、キャッシュは0.2ドル
室谷代表取締役まず数字からいきますね。Z.ai公式提供分がOpenRouterに載っている価格で、入力が100万トークンあたり1ドル、出力が3.2ドル。
キャッシュ読み込みは0.2ドルなんですよ。
キャッシュ読み込みは0.2ドルなんですよ。
テキトー教師DotAI 認定講師キャッシュの0.2ドル、初めて見る人はピンとこないかもしれないですね。同じ長いプロンプトを使い回すと、そこだけほぼ誤差みたいな値段になる、という理解で合ってます?
室谷代表取締役そう、読み込みが入力の5分の1。常用するワークフローほど効いてくるんですよね。
逆に毎回ゼロから長文を投げる使い方だと、この安さは活きてこない。
逆に毎回ゼロから長文を投げる使い方だと、この安さは活きてこない。
テキトー教師DotAI 認定講師たしかに。現場感覚で言うと、料金表だけ見て「安い」で終わる人と、キャッシュが効く形に組み替える人で、実際の請求額が別物になるんですよ。
中国国内BigModel.cnの料金体系を見てみる
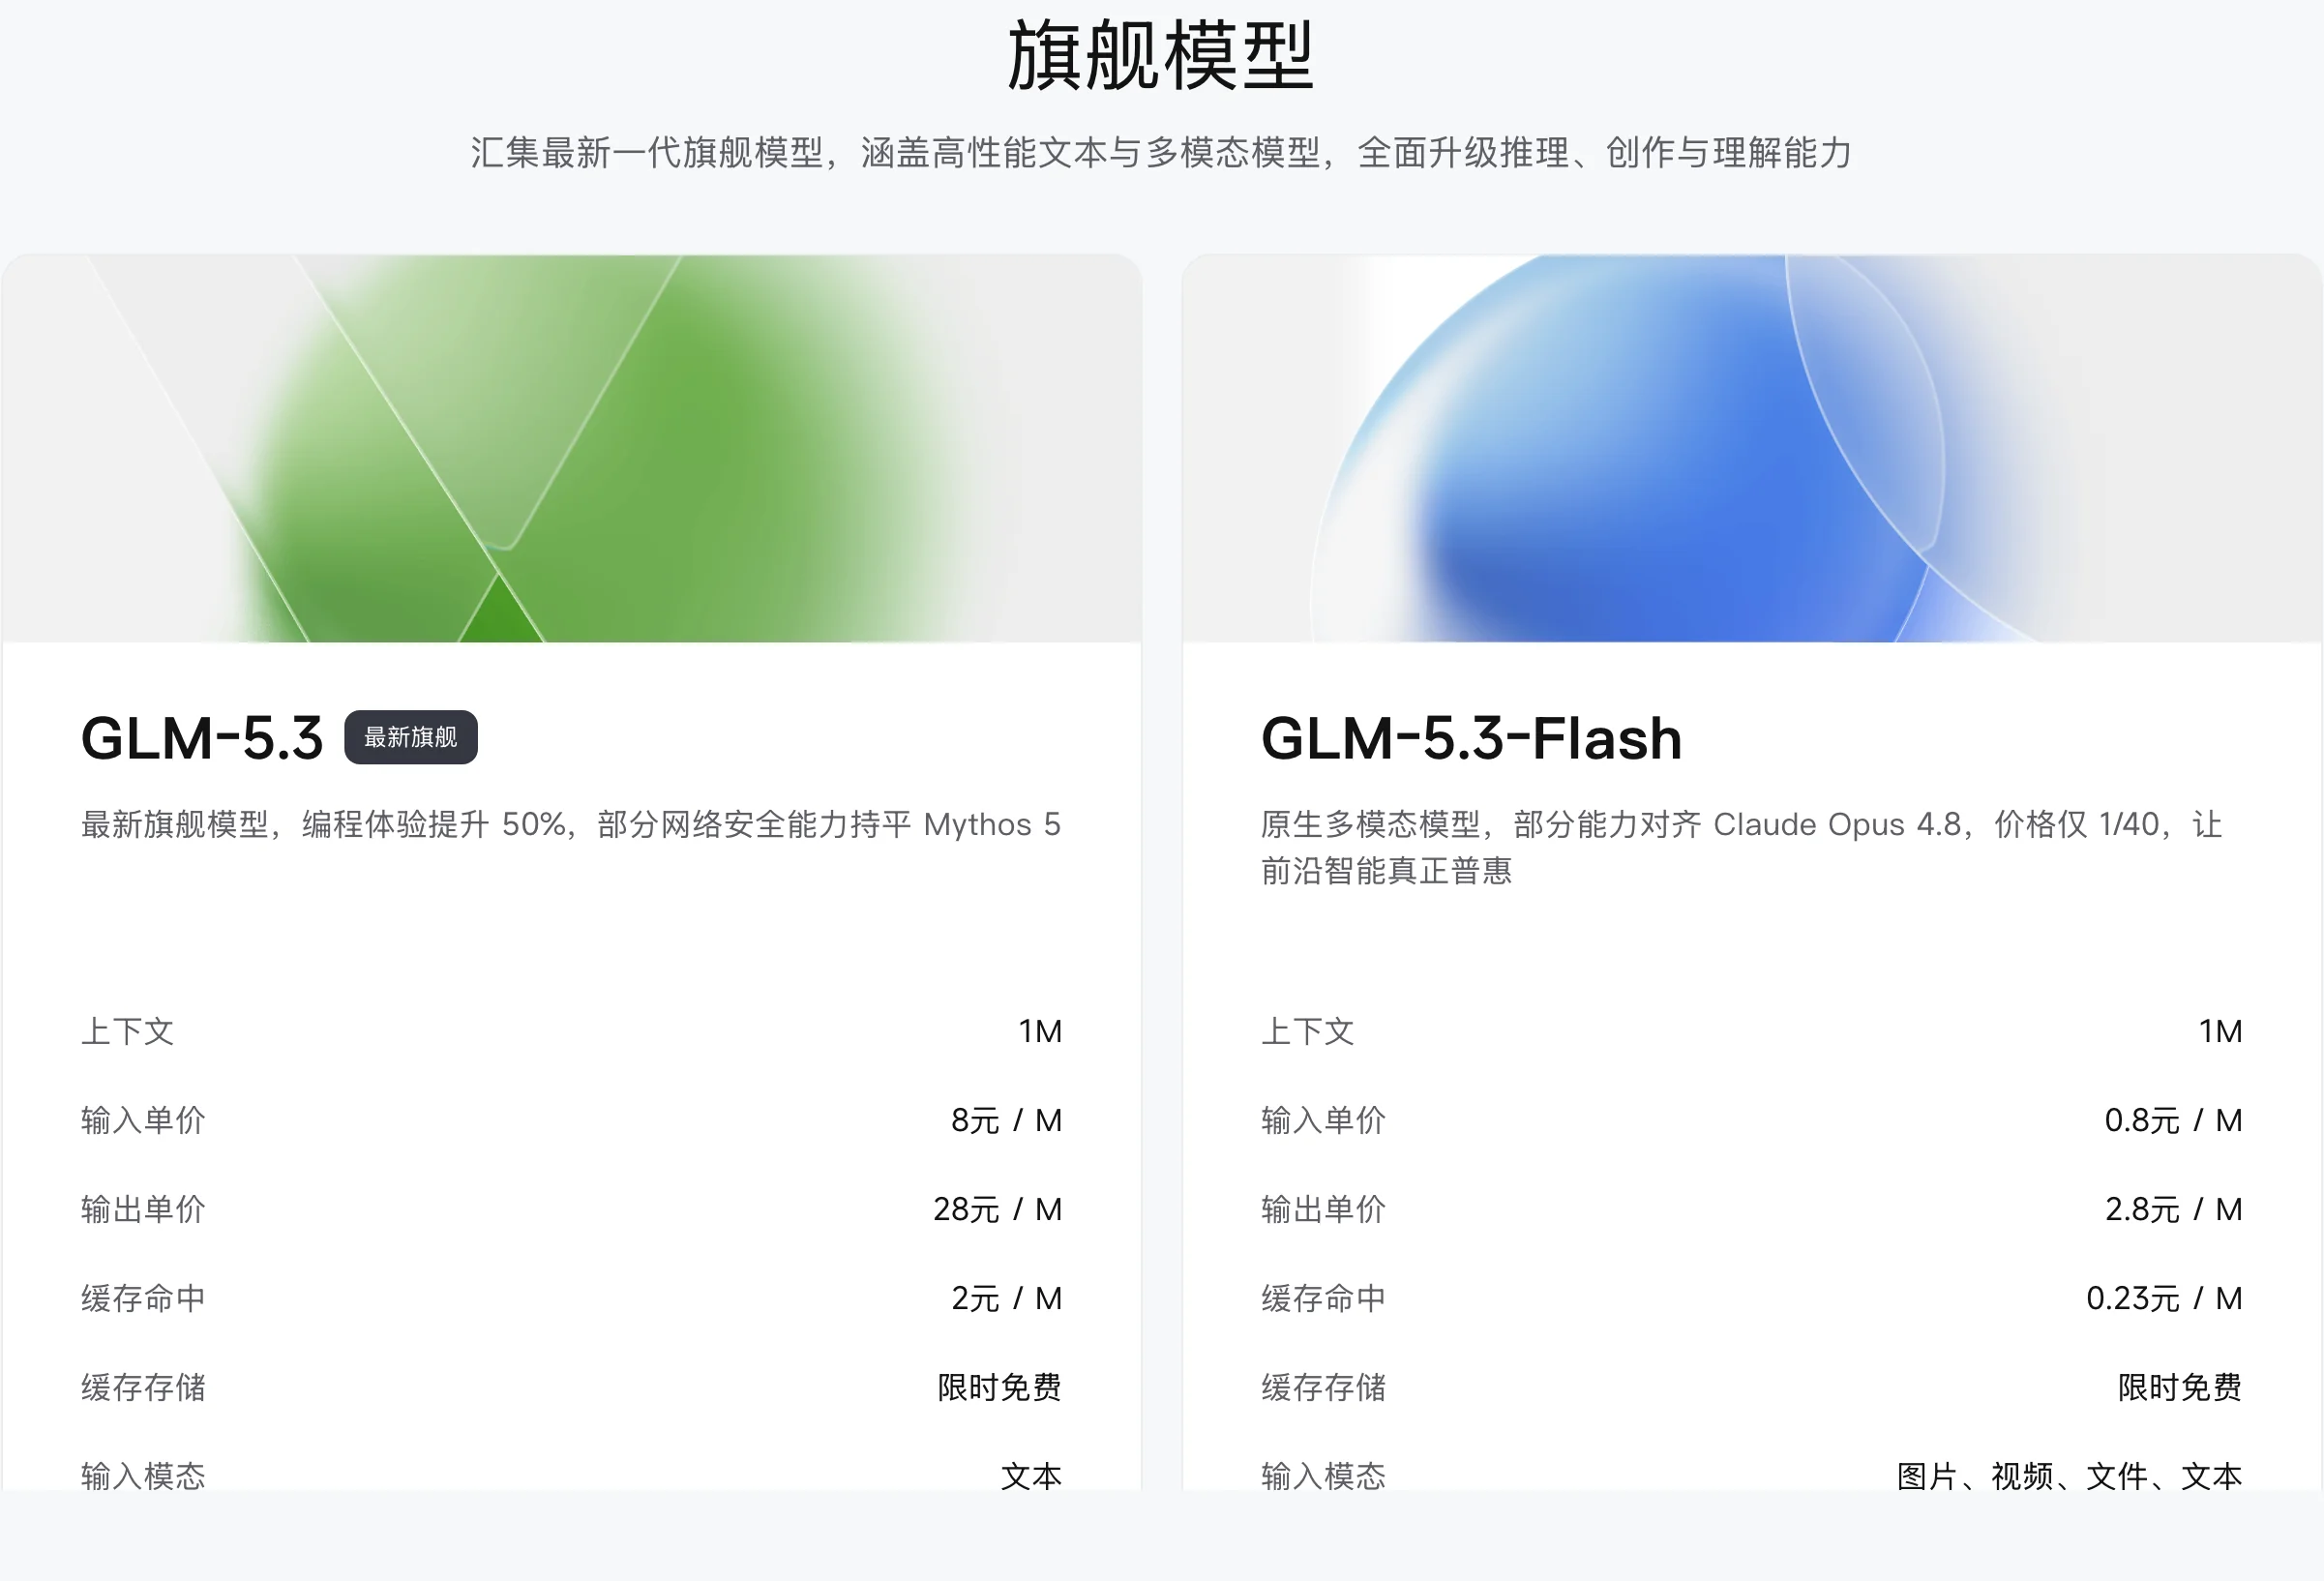
室谷代表取締役で、中国国内向けのBigModel.cnは人民元建てで別体系なんですよ。2026年11月時点の表だとこうなってます。
| モデル | 入力 | 出力 | キャッシュ命中 |
|---|---|---|---|
| GLM-5.3 | 8元 | 28元 | 2元 |
| GLM-5.3-Flash | 0.8元 | 2.8元 | 期間限定で半額 |
| GLM-5.2 | 8元 | 28元 | - |
| GLM-5.1 | 6〜8元 | 24〜28元 | - |
※いずれも100万トークンあたり。GLM-5.3はコンテキスト1M、マルチモーダル対応はFlash側。
テキトー教師DotAI 認定講師Flashの0.8元、桁がひとつ違うんですよね。マルチモーダルが載っててこの値段は、最初に見たとき記載ミスかと思いました。
室谷代表取締役ただし無料で使えるのはGLM-4.7-FlashとGLM-4.6V-Flashだけなので、旗艦を無料で回す前提は置かないほうがいい。あと元建ての数字はそのまま日本の感覚に置き換えられないので、api.z.aiとどっちの窓口で契約するかは先に決めた方がいいんですよね。
テキトー教師DotAI 認定講師そこ、最初に戸惑うのが「どっちの窓口の話なのか」なんですよ。中国国内向けの表を見て自分の請求額だと思うと、感覚がズレます。
GLM Coding Planのクォータはどう消費されるか
室谷代表取締役コーディングエージェント経由で使うと、従量課金じゃなくてCoding Planのクォータで見る人が多いんですけど、ここが曲者で。GLM-5はGLM-4.7よりプランのクォータ消費が多い、と明記されてるんですよ。
テキトー教師DotAI 認定講師同じ1回のやり取りでも減り方が違う、と。しかも今はポイント制で、平日14時から18時(UTC+8)のピークを外すと消費が通常の50%になるんですよね。
室谷代表取締役日本時間に直すと1時間ずれるので、19時を過ぎたあたりから安い側に入ってくる計算。回す時間帯をずらすだけで、同じプランでも走らせられる量が変わる。
経営目線で言うと、これは設備を増やす話じゃなくて運用設計で原価を下げるタイプの話なんですよ。
経営目線で言うと、これは設備を増やす話じゃなくて運用設計で原価を下げるタイプの話なんですよ。
テキトー教師DotAI 認定講師GLM-5はどこで使える?無料チャット・API・AWS Bedrock
GLM-5の利用経路と選び方
まずはchat.z.aiの無料チャットとエージェントモードで触る
室谷代表取締役入口の話からいきましょうか。一番ハードルが低いのは chat.z.ai の無料チャットなんですよね。
契約も課金もなしで、今日いきなり触れる。
契約も課金もなしで、今日いきなり触れる。
テキトー教師DotAI 認定講師そこ、初めて触る人が一番見落とすところなんですよ。「まず申し込んでから試す」だと思い込んでる。
順番が逆で、無料チャットで雰囲気を掴んでから払う話に進めばいいんです。
順番が逆で、無料チャットで雰囲気を掴んでから払う話に進めばいいんです。
室谷代表取締役エージェントモードは .docx とか .pdf、.xlsx をそのまま出せるので、実務文書で試すのが手っ取り早い。ROI で考えると、触って判断してから契約する方が絶対に安いんですよね。
テキトー教師DotAI 認定講師現場でよく聞くのは「何を試せばいいか分からない」なんですよ。社内の資料を1本書かせてみる、それが一番早いと思います。
api.z.ai・BigModel.cn・OpenRouter経由でAPIを叩く
室谷代表取締役自社のプロダクトに組み込むなら API ですね。api.z.ai、中国国内向けの BigModel.cn、あとは OpenRouter 経由でも叩けます。
テキトー教師DotAI 認定講師OpenRouter は価格が表に出てるのが分かりやすいです。入力が100万トークンで1.00ドル、出力が3.20ドル、キャッシュ読み込みが0.20ドルという掲載でした。
室谷代表取締役この帯だと、試作の段階で為替や請求の心配をしなくていい。構造的な話をすると、いまはモデル本体より「どこ経由で買うか」で手間も請求も変わるんですよ。
テキトー教師DotAI 認定講師たしかに。同じモデルでも経路が違えば請求の形もレスポンスの速さも変わりますから、最初に決めておくべきところですね。
AWS Bedrockのzai.glm-5を選ぶ(東京リージョンも可)
室谷代表取締役企業で使うなら AWS Bedrock です。モデルIDは zai.glm-5。
東京リージョンも対象なので、データの置き場所の話が社内でしやすいんですよね。
東京リージョンも対象なので、データの置き場所の話が社内でしやすいんですよね。
| 項目 | 内容 |
|---|---|
| モデルID | zai.glm-5 |
| エンドポイント | bedrock-runtime / bedrock-mantle |
| リージョン | 東京(ap-northeast-1)を含む複数 |
| 提供開始 | 2026年2月11日 |
| EOL | 2027年2月11日(現状はアクティブ) |
テキトー教師DotAI 認定講師ここ、けっこう効くんですよ。監査も契約もAWSの流れに乗るので、社内の稟議が通るスピードが全然違う。
室谷代表取締役ライフサイクルが読めるのも大きい。長期のシステムに埋めるなら、この期限は先に確認しておくべきなんです。
テキトー教師DotAI 認定講師公式チャネルと非公式サイトの見分け方
室谷代表取締役で、ここが今日いちばん伝えたいところ。検索すると glm5.app みたいなサイトが上に出るんですけど、あれは Z.ai 公式じゃなくて、独自の Starter・Plus・Enterprise のプランを並べてる再販・紹介サイトなんですよ。
テキトー教師DotAI 認定講師しかも GLM-5.5 みたいに、確認できないバージョン名まで載ってる。初めて触る人がここで契約すると、何を買ったのか分からなくなるんですよね。
室谷代表取締役公式は z.ai のチャット、api.z.ai か bigmodel.cn の API、あとは AWS Bedrock と OpenRouter。判断基準は運営元が Z.ai かどうか、それだけです。
テキトー教師DotAI 認定講師契約の前にそこだけ確認する。それで余計な出費も事故も避けられますから。
Claude Codeで使うには?ローカル実行はできるのか
Claude CodeでGLM-5を使う手順(Coding Plan経由)
- 1GLM Coding Planに登録z.aiで登録。Maxプランは即時利用可、それ以外は順次展開(当時の案内)
- 2設定ファイルを開く使っているコーディングエージェントの設定ファイルを開く
- 3モデル名を「GLM-5」に書き換えモデル名の欄を書き換えて保存する
- 4呼び出して動作確認Claude Code、OpenCode、Kilo Code、Roo Code、Cline、Droid などから呼び出す
GLM Coding Planに登録してモデル名を書き換える
- z.ai で GLM Coding Plan に登録する(Maxプランは即時利用可、それ以外のプランは順次展開という当時の案内)
- 使っているコーディングエージェントの設定ファイルを開く
- モデル名の欄を「GLM-5」に書き換えて保存する
- Claude Code、OpenCode、Kilo Code、Roo Code、Cline、Droid などから呼び出して動作を確認する
室谷代表取締役一番手軽なのは Coding Plan 経由なんですよね。設定ファイルのモデル名を書き換えるだけで、Claude Code からそのまま叩ける。
既存のワークフローを壊さずに載せ替えられるのが効くんですよ。
既存のワークフローを壊さずに載せ替えられるのが効くんですよ。
テキトー教師DotAI 認定講師初めて触る人が最初に戸惑うのが「名前を変えるだけで本当に動くのか」という点で。実は設定ファイル1行の話なので、拍子抜けする人もいます。
室谷代表取締役ただ、GLM-5 は GLM-4.7 よりプランのクォータ消費が多いと明記されてるんですよ。常用する前提なら、最初に減り方を見ておかないと後半で詰まる・・・
テキトー教師DotAI 認定講師現場でよく聞くのも「思ったより早く減る」という声です。料金体系と設定の細かいところはGLM Coding Planの料金・クレジット・Claude Code設定を最新情報で整理にまとめてあるので、そちらを見てもらうのが早いですね。
Hugging Faceから重みを取ってvLLMやSGLangで動かす
室谷代表取締役検証用途や社内の閉域で回したいなら、重みを取って自前でホストする方ですね。Hugging Face と ModelScope で MIT ライセンスで公開されてるので、社内規定の確認も進めやすい。
テキトー教師DotAI 認定講師ライセンスが明確なのは助かりますよね。ただ初めての人がハマるのが、重みのサイズで、素直に読み込むとメモリで詰まるんですよ。
まずは小さい構成で試す人が多いです。
まずは小さい構成で試す人が多いです。
室谷代表取締役配信まわりは vLLM が v0.19.0 以降、SGLang が v0.5.10 以降。KTransformers、Transformers、xLLM でも動く形になってます。
バージョン条件は更新されるので公式の手順で確認してもらうのが確実です。
バージョン条件は更新されるので公式の手順で確認してもらうのが確実です。
テキトー教師DotAI 認定講師ここで一度、自分たちの用途を整理したほうがよくて。検証なのか本番なのかで、用意するGPUの台数がまるで変わってきますからね。
NVIDIA以外のチップでも動くのはどこまで本当か
室谷代表取締役公開されてる対応先を見ると、Huawei Ascend、Moore Threads、Cambricon、Kunlun Chip、MetaX、Enflame、Hygon といった名前が挙がってるんですよね。NVIDIA 一択ではない、というのが素直な読み方です。
テキトー教師DotAI 認定講師ただ「対応している」と「同じように快適に動く」は別物で。現場でよく聞くのは、そこがごっちゃになって期待値が上がってしまう話です。
室谷代表取締役業界構造で言うと、調達できるチップが国や組織で違うので、選択肢が広いこと自体に価値があるんですよ。導入コストは結果的に実測でしか分からないので、PoCの範囲を先に決めておくのが現実的です。
テキトー教師DotAI 認定講師たしかに。まずは手元の1枚で動くかどうかを、公式の手順とバージョン条件を見ながら確かめるところからですね。
実際に使った人の評価と、正直な弱点
GLM-5の実機評価:強みと弱点
日本語の知識やコーディングはどう評価されているか
室谷代表取締役GLM-5の個人の実機レビューだと、コーディングやロールプレイ、日本の固有知識への回答力は高い、という評価なんですよね。ここは公式ベンチでは測りにくい部分なので、現場感覚として面白いなと。
数字だけ見ると見落とす層があると思います。
数字だけ見ると見落とす層があると思います。
テキトー教師DotAI 認定講師初めて触る人が驚くのもそこなんですよ。日本語の言い回しが不自然になりにくいので、翻訳調の文章を直す用途だと差が見えやすいですし、逆に専門用語の多い文書は別の確認が要ります。
室谷代表取締役経営目線で言うと、日本語の顧客向け文面を一から書かせるより、下書きを整える方が時短効果を感じやすい。コーディングも含めて、日本語の地力は素直に強いですね。
テキトー教師DotAI 認定講師たしかに。ただ「日本語が得意」と「複雑な推論が速い」は別なので、そこを混ぜると「思ったより速くない」という評価につながるんですよね。
複雑な推論で感じる速度の物足りなさ
室谷代表取締役一方で、個人の使用感として、出力トークン数が多い複雑な推論では、GLM-4.7より応答が遅いと感じる場面があったそうです。これは公式の性能値ではなく、あくまで実機レビューの印象です。
テキトー教師DotAI 認定講師現場感覚で言うと、考える量が増えるほど待ち時間が伸びるのは納得でして。短い回答なら快適でも、長い設計相談になると体感が変わるんですよ。
室谷代表取締役時短のつもりで使って待たされるなら、時給換算では地味に痛い。速さが正義の作業と、時間をかけて推論させたい作業を分けないと、評価を間違えますね。
テキトー教師DotAI 認定講師そうなんですよね。速いモデルと併用して、重い推論だけ任せる使い方が現実的だと思います。
速さが必要な反復作業は別モデルに逃がす。
速さが必要な反復作業は別モデルに逃がす。
それでも乗り換える価値がある人・ない人
室谷代表取締役乗り換える価値があるのは、日本語の実務文書やコーディング補助を日常で回していて、コストと日本語品質のバランスを取りたい人ですね。全部を置き換えるというより、用途を絞って試すのが現実的です。
テキトー教師DotAI 認定講師逆に、長い推論を大量に回す仕事で、待ち時間が許容できない人は、無理に一本化しない方がいいです。速いモデルを残したまま、日本語の下書きやコード補助だけ任せる。
室谷代表取締役経営判断でも同じで、ROIが出る業務から部分的に置き換える。いきなり全社的に切り替えると、待ち時間の不満だけが残るんですよね。
テキトー教師DotAI 認定講師最初から決め打ちせず、作業ごとに使い分ける。それが一番ハマりにくいと思います。
GLM-5.1から5.3へ。2026年11月時点の現在地
GLM-5系のリリース経緯と主な変化
- 2月12日GLM-5 リリースシリーズの起点
- 4月7日GLM-5.1 リリース長時間のエージェント実行に注力。最大8時間の自律実行が可能と発表。SWE-Bench Proで58.4を記録し、Opus 4.6の57.3を上回った
- 6月16日GLM-5.2 リリース5.3のベースモデルとなる
- 8月14日GLM-5.3 リリースベースモデルは5.2と同一で後処理のみ強化。Z.ai Code Benchで5.2比50%向上。thinking無効化オプションを廃止し、reasoning_effortのlow/high/max指定に移行
5.1・5.2・5.3でそれぞれ何が変わったのか
室谷代表取締役まず時系列を整理しておくと、GLM-5が2月12日に出たあと、4月7日に5.1、6月16日に5.2、8月14日に5.3というペースで来てるんですよね。半年で3回メジャー更新って、正直かなり速いペースです。
テキトー教師DotAI 認定講師しかも5.1は長時間のエージェント実行に振っていて、最大8時間の自律実行が可能と発表されてます。初めて触る人が一番驚くのがそこですね。
「そんなに走らせて大丈夫なの」という反応になります。
「そんなに走らせて大丈夫なの」という反応になります。
室谷代表取締役5.1はSWE-Bench Proで58.4を記録して、Opus 4.6の57.3を上回ったという発表なんですよ。で、5.3はベースモデルが5.2と同一で後処理だけ強化、Z.ai Code Benchで5.2比50%向上という建て付けなんです。
あと5.3からthinkingを無効化するオプションが廃止されて、reasoning_effortのlow/high/max指定に移行してます。
あと5.3からthinkingを無効化するオプションが廃止されて、reasoning_effortのlow/high/max指定に移行してます。
テキトー教師DotAI 認定講師5.3は土台を作り直したというより、仕上げを削ってる感じですね。5.2単体の中身はGLM-5.2とは何か|性能・料金とGLM-5.3登場後の現在地のほうに整理されているので、そちらを見ると流れがつながります。
セキュリティ分野で伸びた能力と開示の仕組み
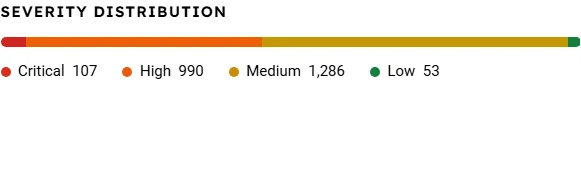
室谷代表取締役コーディングの数字だけ追ってると見落とすんですけど、5.3で伸びてるのはセキュリティ側なんですよね。中国国内の複数セキュリティチームと共同で269のOSSプロジェクトから2,436件、うち1,097件が中〜高深刻度の脆弱性を検出したと。
テキトー教師DotAI 認定講師Z.ai Security Disclosure Ledgerで開示状況まで出してるのが効いてますよね。現場感覚で言うと、脆弱性検出は「見つけました」で終わると信用されないんですよ。
どう報告して、どう直したかまで見える形になっているのが大きいです。
どう報告して、どう直したかまで見える形になっているのが大きいです。
室谷代表取締役事業目線で言うとここは地味に響く話で。脆弱性診断って人月の商売だったのが、モデルが検出を担うと見積もりの構造そのものが変わる。
社内のコード監査にどう組み込むかで、外注費の出し方が変わってきてます。
社内のコード監査にどう組み込むかで、外注費の出し方が変わってきてます。
テキトー教師DotAI 認定講師ただ、検出件数が多いことが自社コードの安全を意味するわけではないので。指摘をどう捌くかの体制とセットで考えたほうがいいですね。
さくらインターネットとフィックスターズ、国内から試す選択肢
室谷代表取締役国内で試す導線も、この秋で一気に現実的になってます。さくらインターネットが11月18日に「さくらのAIEngine」で5.3-Flashのパブリックプレビューを開始していて、画像も扱えるマルチモーダル対応、Chat Completions API対応、月3,000リクエストまで無償と案内されてます。
テキトー教師DotAI 認定講師最初に戸惑うのが、Flashが何なのか分からないところで。軽いほうのモデルだと捉えておけばよくて、触り始めの入り口としては十分です。
室谷代表取締役あとフィックスターズが11月20日に国内完結の推論サービス「Fixstars Inference Cloud」で5.3の提供を始めていて、100万トークンあたり入力10.49円・出力210円。データを国内に置きたい案件だと、このへんが現実解になってきます。
テキトー教師DotAI 認定講師中国国内向けの料金表だと5.3が入力8元・出力28元なので、円建てで国内完結になる分の差は安心料として見るかどうか、ですね。
glm5.appのような非公式サイトに注意する
室谷代表取締役で、ここが今日いちばん伝えたいところなんですけど。検索で上位に出てくるglm5.app、あれはZ.aiの公式サイトじゃないんですよ。
独自のStarter/Plus/Enterpriseの料金プランを出していて、GLM-5.5なんていう未確認のバージョン名まで載ってる。
独自のStarter/Plus/Enterpriseの料金プランを出していて、GLM-5.5なんていう未確認のバージョン名まで載ってる。
テキトー教師DotAI 認定講師初めて触る人は、それっぽいドメインなら普通に信じてしまいますからね。契約だけして中身が別物だった、では目も当てられないです。
室谷代表取締役だから入り口は公式に寄せたほうがよくて。チャットとサブスクはz.ai、APIはapi.z.aiかbigmodel.cn、あとはAWS BedrockとOpenRouter。
ここだけ押さえておけば変な回り道をせずに済みます。
ここだけ押さえておけば変な回り道をせずに済みます。
テキトー教師DotAI 認定講師料金も、先ほど見た表と公式ページを突き合わせれば整合が取れるので。見慣れないサイトは一度立ち止まる、それだけで事故はかなり減ります。
よくある質問
Q1. 商用利用はできる?ライセンスは何を見ればいい?
室谷代表取締役ここは先に切り分けた方がいいんですよね。モデル本体のライセンスと、API経由で使うときの利用規約は別物なので。
重みが配布されているタイプなら重みのライセンス、APIなら規約。両方見る必要があります。
重みが配布されているタイプなら重みのライセンス、APIなら規約。両方見る必要があります。
テキトー教師DotAI 認定講師初めて触る人が一番見落とすところですね。サービスに組み込んでから「商用は範囲外だった」と気づくパターン、現場でよく聞きます。
室谷代表取締役法人なら法務に投げる前に、自社のどこで使うかを決めた方が早いです。組み込み方によって確認すべき条項が変わるので。
テキトー教師DotAI 認定講師公式の表記をそのまま持っていくのが安全ですね。まとめ記事は版が古いことが多いので。
Q2. 日本語の指示でもちゃんと動く?コツはある?
テキトー教師DotAI 認定講師日本語だと指示の解釈がぶれやすいので、条件は箇条書きで渡すと安定します。長い一文でお願いするより効きますよ。
室谷代表取締役出力の形を先に縛るのも手ですね。JSONで返す、見出しは3つまで、みたいに決めると暴れにくい。
テキトー教師DotAI 認定講師あと専門用語はカタカナより英語のまま渡した方が意図が伝わります。翻訳の段階でズレるんですよね。
Q3. 入力したデータは学習に使われる?法人で導入するときの注意は?
室谷代表取締役これは契約形態で答えが変わるので、APIとチャット画面を分けて考えるべきなんですよ。無料で触るのと法人契約では扱いが違うことが多いので、そこは混同しない方がいい。
テキトー教師DotAI 認定講師現場感覚で言うと、まず「何を入れてはいけないか」を社内で決めるのが先ですね。設定より先にそこが抜けてて事故るケースを見ます。
室谷代表取締役あとは監査ログが取れるかどうか。個人で試す分には気にしなくていいですが、業務利用だと稟議の通過条件になりますから。
Q4. 更新が速いけど、本番ではバージョン固定できる?
室谷代表取締役できます。というか、固定しないと怖いんですよね。
呼び出し側でモデル名を明示しておくのが基本です。
呼び出し側でモデル名を明示しておくのが基本です。
テキトー教師DotAI 認定講師最初に戸惑うのが、固定したつもりが別の設定ファイルで上書きされていた、というパターンですね。
室谷代表取締役それと、いずれ古いモデルは提供終了になる前提で、呼び出し部分を1箇所にまとめておく。地味ですけど、これをやってるかどうかで乗り換えコストが全然違ってきます。
Q5. Claude向けに書いたプロンプトはそのまま使える?
テキトー教師DotAI 認定講師そのまま投げると別物になりますね。モデルごとに効く書き方が違うので、まず同じプロンプトで並べて走らせて、差分を直すのが早いです。
室谷代表取締役プロンプトを資産として持ってる会社ほど、ここでつまずくんですよ。「特定モデル向け」みたいにモデル名を書き込んじゃうと、後で動かなくなる。
テキトー教師DotAI 認定講師抽象化しておけば、乗り換えのたびに全部書き直さずに済みますからね。
まとめ
室谷代表取締役結局、性能の数字だけ追いかけても意思決定はできないんですよね。どこで使うのか、何を守るのか、乗り換えられる設計になっているのか。
そこが決まっていればモデルは入れ替え可能な部品でしかないです。
そこが決まっていればモデルは入れ替え可能な部品でしかないです。
テキトー教師DotAI 認定講師そうですね。最初の一歩は、いま自分がやってる作業を1つ選んで、同じプロンプトで並べて走らせてみる。
それで体感がはっきりします。
それで体感がはっきりします。
室谷代表取締役業務で使うなら、利用規約とデータの扱いを先に確認。ここを飛ばして評価を進めると、後で全部やり直しになりますから。
テキトー教師DotAI 認定講師評価シートをきれいに作るより、壊れても困らないところで小さく本番投入してみる方が早いこともあります。その方が現実的ですね。
室谷代表取締役触ってみて合わなければ、そこで乗り換えればいい。モデル選びは結婚じゃなくて取引なので、気軽に試すのが一番コスパいいです。