Qwen3.5とは何か。AlibabaのQwenチームが2026年2月に公開したオープンウェイトモデル
開発元はAlibabaのQwenチーム
 室谷代表取締役
Qwen3.5の話、まず誰が出しているかから整理しておきたいんですよね。AlibabaのQwenチームです。
オープンウェイトで配布まで含めて出してくるあたり、戦略がはっきりしているなと。
オープンウェイトで配布まで含めて出してくるあたり、戦略がはっきりしているなと。
 テキトー教師DotAI 認定講師
たしかに。初めて触る人は「QwenってAlibabaのモデルなんですね」というところから入る方が多いです。
ブランド全体が見えていないと、どの世代の話をしているのか迷子になりやすいんですよ。
ブランド全体が見えていないと、どの世代の話をしているのか迷子になりやすいんですよ。
室谷代表取締役テキトー教師DotAI 認定講師全体像を見てから3.5に戻ってくると、位置関係がすっと入りますね。
最初に公開されたのは397B-A17B
室谷代表取締役で、公式ブログによると2026年2月15日に最初のオープンウェイトとして397B-A17Bが出ています。総パラメータ397Bで、推論時に実際に動くのは17Bだけ。
この設計はコスト感覚に直結するんですよね。
この設計はコスト感覚に直結するんですよね。
テキトー教師DotAI 認定講師数字だけ見ると「397Bって何それ」ってなるんですよ。全部を動かしているわけじゃない、と説明するとだいたい皆さん納得されます。
Hugging Faceの表記だと403Bになっているので、そこも最初は戸惑いやすいところです。
Hugging Faceの表記だと403Bになっているので、そこも最初は戸惑いやすいところです。
室谷代表取締役業界構造で言うと、巨大なのを一発出してから小さいサイズを並べる方がエコシステムを取りやすい。公開の順番にも意味があるんですよ。
テキトー教師DotAI 認定講師最初の一発が旗艦、というのは看板として分かりやすいですね。
「Towards Native Multimodal Agents」が示す開発の狙い
テキトー教師DotAI 認定講師公式ブログのタイトルが『Towards Native Multimodal Agents』なんですよ。テキストだけでなく画像・動画を最初から統合して学習した、という宣言になっています。
室谷代表取締役後付けで視覚系を足すのではなく、最初から混ぜている。エージェントとして使う前提が透けて見える設計ですよね。
用途の幅が変わると思います。
用途の幅が変わると思います。
テキトー教師DotAI 認定講師現場でよく聞くのは「画像も扱えるんですか」という確認です。別シリーズを組み合わせなくていい、というのは最初の理解として大きいです。
室谷代表取締役狙いがスペック表ではなくブログのタイトルに出ているのは読みやすい。何を作りたいチームなのかが先に分かりますからね。
オープンウェイトで配布されていることの意味
室谷代表取締役重みが公開されている点は大きいです。Hugging Faceから取得できるので、社内環境に閉じた検証ができる。
経営目線で言うと、検証コストが読めるのがありがたいんですよね。
経営目線で言うと、検証コストが読めるのがありがたいんですよね。
テキトー教師DotAI 認定講師一方で、配布ページにLICENSEファイルが同梱されているので、そこは必ず見てくださいという話になります。モデルごとに条件が違う可能性がありますから。
室谷代表取締役そこは事業判断の部分なので飛ばさない方がいい。重みが取れる=何にでも使える、ではないですからね。
テキトー教師DotAI 認定講師まず触ってみて、商用を考える段階で条項を読む。その順番が現実的だと思います。
Qwen3と何が違うのか。テキスト専用からネイティブマルチモーダルへ
Qwen3はテキスト専用、画像は別シリーズだった
室谷代表取締役前の世代、Qwen3はテキスト専用のモデルで、画像を扱うのはQwen3-VLという別シリーズに分かれていたんですよね。ここが今回いちばん大きい差分で、中身はもう別物になってます。
テキトー教師DotAI 認定講師そこ、最初に戸惑うのがまさにこの部分で。「画像はどのモデルに投げればいいんですか」で手が止まるんですよ。
前世代の細かい違いはQwen3とは?119言語・8モデルの違いとローカル実行、ライセンスの注意点にまとまってます。
前世代の細かい違いはQwen3とは?119言語・8モデルの違いとローカル実行、ライセンスの注意点にまとまってます。
室谷代表取締役経営の目線で言うと、モデルが2系統に分かれてるだけで選定・評価・コスト管理が二重になるんですよ。地味ですけど、そこは現場の工数に効いてきます。
画像も動画も、最初から学習に混ぜる設計
室谷代表取締役公式が掲げてるのが「Towards Native Multimodal Agents」。あとから画像対応を足すのではなく、画像も動画も最初から学習に混ぜている。
これがネイティブマルチモーダルと呼ばれてる所以です。
これがネイティブマルチモーダルと呼ばれてる所以です。
テキトー教師DotAI 認定講師後付けの翻訳機能と、最初から二言語で育った人の違いに近いですね。前者は翻訳の段で情報が落ちる。
後者は最初から同じ土俵で扱える。
後者は最初から同じ土俵で扱える。
室谷代表取締役各社がこの設計に寄せてきてる構造があって、テキストと視覚を別々に積む路線はじわじわ減っていくんだろうなと。モデルを組み合わせる側の負担が減る方向です。
言語は119から201、語彙は150kから250kへ
室谷代表取締役数字も変わってて、対応言語・方言が119から201に、語彙数が150kから250kに広がってます。多言語のトークン効率は10〜60%改善したと。
テキトー教師DotAI 認定講師語彙が増えると、同じ文章が少ないトークンで収まるんですよ。長い文章を入れたときの消費が変わってくるので、体感で出やすいところです。
室谷代表取締役トークン効率が10〜60%改善って、API課金の世界だとそのまま単価に効く数字なんですよね。機能が増えたというより、原価が下がる方向の改善です。
Gated Delta NetworksとスパースMoEのハイブリッド
テキトー教師DotAI 認定講師ここが一番ハードル高いところで。Gated Delta NetworksにスパースMoE、さらにGated Attentionを混ぜたハイブリッド構成と言われても、名前の時点で拒否反応が出るんですよ。
室谷代表取締役ベースはQwen3-Next系のアーキテクチャですね。397B-A17Bは総パラメータ397B(Hugging Face表記で403B)のうち、推論時に実際に使うのは17Bだけ。
ここで速度とコストを抑えてる。
ここで速度とコストを抑えてる。
テキトー教師DotAI 認定講師ただ「17Bしか使わないなら17Bモデルと同じ軽さ」と勘違いする人が多い。推論時も全パラメータをメモリに載せる必要があるので、必要メモリは別で見ないといけません。
室谷代表取締役生成速度は32kでQwen3-Maxの8.6倍、256kで19.0倍という実測が出てます。長い文脈を回すほど差が開くので、エージェントを並走させる使い方だと効いてくる数字です。
0.8Bから397B-A17Bまで8系統。どのサイズを選べばいいのか
8系統のラインナップ、まず並べてみる
室谷代表取締役サイズ展開、全部で8系統なんですよ。0.8B、2B、4B、9B、27Bまでが単一のDenseモデル。
その上にMoEが3つ、35B-A3B、122B-A10B、397B-A17Bという並びなんですね。
その上にMoEが3つ、35B-A3B、122B-A10B、397B-A17Bという並びなんですね。
テキトー教師DotAI 認定講師数字だけ追うと「27Bの次が35B、その次がいきなり122B」で跳ねるので、初めて触る人はそこで固まります。前世代の並びと比べたい人はQwen3とは?119言語・8モデルの違いとローカル実行、ライセンスの注意点を見ると整理しやすいですよ。
室谷代表取締役しかも35B-A3Bの「A3B」、活性3Bって書いてあるので9Bより軽いのかと錯覚するんですよ。ここが罠で・・・
テキトー教師DotAI 認定講師表記の読み方から説明が要るタイプですね。
「活性3B」につられてメモリを見積もると失敗する
室谷代表取締役MoEは推論で使うパラメータが3Bでも、全パラメータをメモリに展開する必要があるんです。35B-A3Bは36Bぶん、122B-A10Bは125Bぶん、397B-A17Bは403Bぶんの置き場所が要る。
テキトー教師DotAI 認定講師現場でよく聞くのが「3Bなら8GBで足りますよね」なんですよ。速度は活性ぶん、メモリは総量ぶん、と分けて考える必要があります。
室谷代表取締役MYUUUでも検証の見積もりがここで崩れたことがあって。GPU台数の話に直結するので、最初に総パラメータで線を引くのが正解なんですよね。
テキトー教師DotAI 認定講師逆にDense側は素直で、9Bなら9B、27Bなら27Bぶんの重さだと見ればいい。
FP8・GPTQ-Int4の量子化版とGGUFはどう使い分けるか
8系統モデルのメモリ・量子化対応比較
| モデル | 総パラメータ | 量子化版(FP8/Int4) | GGUF | 位置づけ |
|---|---|---|---|---|
| 0.8B | 0.8B | — | — | Dense |
| 2B | 2B | — | — | Dense |
| 4B | 4B | — | — | Dense |
| 9B | 9B | — | — | Dense |
| 27B | 27B | ○ | — | Dense |
| 35B-A3B | 36B | ○ | — | MoE |
| 122B-A10B | 125B | ○ | — | MoE |
| 397B-A17B | 403B | ○ | — | MoE・組織向け |
室谷代表取締役手持ちのマシンで動かす話になると量子化版の出番で。397B・122B・35B・27Bには、省メモリ用のFP8とGPTQ-Int4がどちらも用意されてるんですよ。
テキトー教師DotAI 認定講師27Bクラスでも選択肢があるのは大きいですね。FP8は精度を残したいとき、Int4はとにかくVRAMを空けたいとき、という分け方になります。
室谷代表取締役さらにGGUFですね。Ollamaやllama.cpp向けにサードパーティ配布されているもので、VRAMの小さいPCだとこれが現実的な選択肢になる。
テキトー教師DotAI 認定講師Base版と通常版の違いも地味に効きます。作り込みたいならBase、そのまま使うなら通常版、と目的で分かれます。
397B-A17Bは個人のPCではなく組織の推論基盤向け
室谷代表取締役一番上の397B-A17Bは、総403Bを載せる前提なので個人のPCの話じゃないんですよね。組織の推論基盤として置くもの。
テキトー教師DotAI 認定講師ここは無理せず、まず小さいサイズで試して、物足りない領域だけ上げていく人が多いです。
室谷代表取締役経営目線で言うと、上位サイズは「賢さ」より「置き場所のコスト」で決まる。ROIで見れば、27Bで足りる業務を先に切り出して、足りないところだけ上げる順番が現実的です。
テキトー教師DotAI 認定講師サイズ選びって性能表の勝負じゃなくて、載るかどうかの勝負なんですね。
ローカルで動かすには何が必要か。OllamaからvLLMまで
手軽に試すならGGUFから
まずは道具を入れる流れを整理しておきます。
- 配布ページでGGUF形式のファイルを探し、サイズと量子化の種類を確認する
- Ollamaかllama.cppを手元の環境に用意する
- 落としたファイルを読み込ませて起動する
- 短いプロンプトで応答を確認し、重ければ軽い量子化のものに切り替える
室谷代表取締役触ってみるだけなら、GGUFをOllamaかllama.cppで回すのが一番早いんですよね。GGUFはサードパーティ配布ですけど、手元のPCで動くサイズが選べるのが大きいです。
テキトー教師DotAI 認定講師最初に戸惑うのがファイル名の量子化の表記なんですよ。数字が小さいほど軽い代わりに精度は落ちるので、まず動くことを優先したほうがいいですね。
室谷代表取締役検証のためにクラウドGPUを借りると時間課金が地味に効いてくるので、手元で回せるなら試行回数を増やせるのが強いです。後継の3.8系列をGGUFで試す話はUnslothの「Qwen3.8-Flash-Next GGUF」とは?で解説しています。
本番用途はvLLM・SGLang、パーサー指定を忘れずに
室谷代表取締役ちゃんと回すならvLLMかSGLangです。モデルカードに起動コマンドが載っていて、ほかにTransformersやKTransformers、Docker Model Runnerも選択肢として挙がってます。
テキトー教師DotAI 認定講師ここで引っかかる人が多いのがパーサーの指定なんですよ。reasoning-parserにqwen3、ツール呼び出しを使うならtool-call-parserにqwen3_coderを入れないと、思考の出力や関数呼び出しがうまく扱えません。
室谷代表取締役それ、地味に効きますよね。中身のモデルは同じなのに、周辺の設定だけで「使えない」と判定されちゃう。
テキトー教師DotAI 認定講師現場感覚で言うと、性能を比べるより起動オプションでつまずいてる時間のほうが長いんですよ。
VRAMとメモリの必要量はどう見積もるか
室谷代表取締役MoEは活性パラメータが小さく見えるけど、推論時も全パラメータをメモリに展開する必要があるんですよね。だから35B-A3Bの「3B」だけ見て余裕と判断すると詰みます。
テキトー教師DotAI 認定講師たしかに。実際に必要な量はサイズと量子化の種類で変わるので、モデルカードの記載を見てから決めるのが確実です。
室谷代表取締役自前で立てるとGPUは固定費になるので、24時間回し続けるのか検証だけなのかで選び方が変わります。検証だけなら量子化で軽くするほうが合理的なんですよね。
FP8とGPTQ-Int4は397B・122B・35B・27Bのいずれにも用意されてます。
FP8とGPTQ-Int4は397B・122B・35B・27Bのいずれにも用意されてます。
テキトー教師DotAI 認定講師最初から一番大きいのを落とすと、ダウンロードだけで日が暮れますからね。
既定のthinkingモードと、切るときの設定
室谷代表取締役Qwen3.5は既定がthinkingモードで、
テキトー教師DotAI 認定講師ここが厄介で、思考モードのままinstruct向けの温度を入れると出力が荒れるんですよ。推奨値が分かれていて、thinkingはtemperature=1.0、top_p=0.95、top_k=20、presence_penalty=1.5。
instructはtemperature=0.7、top_p=0.8あたりです。
instructはtemperature=0.7、top_p=0.8あたりです。
室谷代表取締役なるほど。同じモデルでも、モードごとに設定を分ける前提なんですね。
テキトー教師DotAI 認定講師切ったつもりでサンプリング設定だけ残ってる、みたいなのが一番もったいないです。
性能とベンチマークはどの程度か。GPT-5.2やClaude 4.5 Opusと比べてどうなのか
397B-A17Bのスコアはフロンティア勢と並ぶ水準
Qwen3.5とフロンティア勢のベンチマーク比較
| 指標 | Qwen3.5 397B-A17B | Qwen3.5 27B | GPT-5.2 | Claude 4.5 Opus | Gemini-3 Pro |
|---|---|---|---|---|---|
| MMLU-Pro | 87.8 | 86.1 | — | — | — |
| GPQA | 88.4 | 85.5(Diamond) | — | — | — |
| LiveCodeBench v6 | 83.6 | — | — | — | — |
| SWE-bench Verified | 76.4 | 72.4 | — | — | — |
| HLE | 28.7 | — | 35.5 | — | 37.5 |
室谷代表取締役数字の話からいくと、Qwen3.5の397B-A17BはMMLU-Proが87.8、GPQAが88.4、LiveCodeBench v6が83.6、SWE-bench Verifiedが76.4。公式ブログの表ではGPT-5.2やClaude 4.5 Opus、Gemini-3 Proと同じ帯に並べて出されてるんですよね。
テキトー教師DotAI 認定講師たしかに、初めて見ると「オープンウェイトでここまで来たのか」となる数字ですね。ただ発表側の表は得意な項目を並べるのが普通なので、同じ列で横に読むのが大事なんですよ。
室谷代表取締役そこは業界構造として効いてくる話で。フロンティアと同水準の数字がオープンウェイトで配られるなら、API課金を前提にしたプロダクト設計が崩れるんですよ。
MYUUUでも内製に寄せる比率を上げてます。
MYUUUでも内製に寄せる比率を上げてます。
27BがQwen3-235B-A22Bクラスを上回る項目がある
テキトー教師DotAI 認定講師小さいサイズも見ておきたいんですよ。27BのモデルカードだとMMLU-Pro 86.1、SWE-bench Verified 72.4、GPQA Diamond 85.5で、Qwen3-235B-A22Bや同クラスの他モデルを上回る項目が並んでます。
室谷代表取締役27Bが前世代の大型に勝つ項目がある、と。これは素直に効く話で、推論コストの見積もりが変わりますからね。
パラメータ数と必要メモリの話は別として、性能あたりのコストで選べる幅が広がる。
パラメータ数と必要メモリの話は別として、性能あたりのコストで選べる幅が広がる。
テキトー教師DotAI 認定講師現場感覚で言うと、「大きいのを1台」より「小さいのを用途別に置く」方が回る場面が増えてる印象です。最初に戸惑うのが、サイズの違う数字を同じ表で横並びに比べてしまうところで。
日本語の実力は数字だけでは判断しにくい
室谷代表取締役日本語はどうなんですか。数字を見ても判断しづらいところですよね。
テキトー教師DotAI 認定講師そうなんですよね。今回は対応言語・方言が119から201に増えて、語彙数も150kから250k、多言語のトークン効率が10〜60%改善と書かれています。
日本語もその底上げの範囲で良くなっている、という読み方が正確だと思います。
日本語もその底上げの範囲で良くなっている、という読み方が正確だと思います。
室谷代表取締役つまり日本語専用に鍛えたわけではなくて、多言語の拡大の一部として入っている、と。なら自社の文書を数百件流して測るのが一番早いんですよ。
ベンチの点数で会議を回すより安く済みますし。
ベンチの点数で会議を回すより安く済みますし。
テキトー教師DotAI 認定講師そこは同感で、社内文書で試すのが結局いちばん確実です。漢字の語彙や敬語の扱いは、公開ベンチの数字には出てこないので。
HLEのように苦手な指標もある
テキトー教師DotAI 認定講師苦手な指標の話もしておくと、HLEは397B-A17Bが28.7で、GPT-5.2の35.5、Gemini-3 Proの37.5にやや劣るんですよ。全部の指標で勝つ、という表ではないんですよね。
室谷代表取締役なるほど。じゃあ「どのタスクで負けるか」を見て、自分の用途と重なる指標を探すのが実務的ですね。
コーディングならSWE-benchとLiveCodeBench側を見る、みたいに。
コーディングならSWE-benchとLiveCodeBench側を見る、みたいに。
テキトー教師DotAI 認定講師そうですね。HLE w/ CoTでは27B系がGPT-5-miniを上回る数字も出ているので、指標ひとつで弱いと決めるのも早計で。
最後は手元で試すのが確実です。
最後は手元で試すのが確実です。
コンテキスト長はどこまで使えるのか。262kネイティブと1M拡張の違い
262kはネイティブ、1Mは拡張という別物
262kネイティブと1M拡張の違い
室谷代表取締役スペック表だけ眺めると「1Mまで入る」って書いてあるので、それ前提でシステムを組もうとする人が出てくるんですけど。ここは2段階に分けて読まないといけない部分で・・・
テキトー教師DotAI 認定講師たしかに。Qwen3.5はネイティブで262,144トークン、そこから先はYaRNのRoPEスケーリングで最大1,010,000トークンまで伸ばせる、という構造なんですよ。
最初から1M動くわけではないんです。
最初から1M動くわけではないんです。
室谷代表取締役つまり拡張は「設定して広げる」もの。デフォルトの延長線上にある数字じゃないんですね。
テキトー教師DotAI 認定講師そうなんです。ここを取り違えると、長い文書をそのまま突っ込んで「あれ、途中から精度が落ちる」と感じることになります。
広げればいい、ではない理由
テキトー教師DotAI 認定講師現場でよく聞くのは「長く入れておけば安心」という発想なんですけど、コンテキストは詰めれば詰めるほど拾う精度が落ちる領域があります。
室谷代表取締役経営目線で言うと、入力トークンはそのままコストに直結するので、業務システムだと「全部突っ込む」設計はまず却下するんですよね。読み込み量が読めないものは運用に乗らないので。
テキトー教師DotAI 認定講師モデルカードにも、長文脈のタスクでは思考能力を保つために128K以上を推奨、という記載があります。逆に言えば、どこまでも積めばいいという話ではないんですよね。
室谷代表取締役262kの中でどう収めるかを先に設計して、足りないときだけ広げる。順番はそっちだということです。
ホスト版はデフォルトが100万トークン
室谷代表取締役一方でAPI側のQwen3.5-Plusは、最初から100万トークンのコンテキストウィンドウなんですよ。ここはオープンウェイト側と前提がかなり違います。
テキトー教師DotAI 認定講師そこを混同する人が多いんですよ。手元で27Bを動かすのと、Model Studio経由でPlusを呼ぶのでは、コンテキストの初期値がそもそも別物ですから。
室谷代表取締役自前運用なら262k前提、APIなら1M前提。同じ名前のモデル群でも、設計の出発点を変えないと事故るんですよね。
MYUUUでも用途ごとにどっちを基準にするか先に決めてます。
MYUUUでも用途ごとにどっちを基準にするか先に決めてます。
テキトー教師DotAI 認定講師長文を扱う案件かどうかで、そもそも選ぶサイズも変わってきますしね。
無料で使えるのか、料金はいくらか。ライセンスで確認すべきこと
まずは無料のチャットUIで3モードを触る
室谷代表取締役最初に気になるのが、どこまで無料で触れるのかという点なんですよね。Qwen Chat なら無料で、auto・thinking・fast の3モードから選んで試せます。
課金の前にここで感触を見るのが一番早いです。
課金の前にここで感触を見るのが一番早いです。
テキトー教師DotAI 認定講師初めて触る人は「登録していきなり請求が来るのでは」と身構えるんですが、その心配は要らないんですよ。3モードの切り替えで挙動がけっこう変わるので、同じ質問を投げ比べるだけで違いが見えます。
室谷代表取締役同じプロンプトを3モードで流す、という使い方が一番安く学べる。経営目線で言うと、検証コストがゼロで済むのは普通に大きいんですよね。
テキトー教師DotAI 認定講師Qwen3.5-PlusをAPIで呼ぶ手順とリージョンごとのベースURL
- Alibaba Cloud Model Studio(Bailian)でAPIキー(DASHSCOPE_API_KEY)を発行する
- 使うリージョンを決める(北京/シンガポール/米国バージニアでベースURLが異なる)
- OpenAI互換のChat Completions APIに、モデル名
qwen3.5-plusを指定してリクエストを送る - 応答を確認し、必要ならツール呼び出しの設定を足す
室谷代表取締役自社の処理に組み込むならAPIなんですが、流れはこの4ステップで足ります。Qwen3.5-Plusはデフォルトで100万トークンのコンテキストウィンドウを持っているので、長い資料をそのまま渡す前提で設計できるんですよ。
テキトー教師DotAI 認定講師最初に戸惑うのが、リージョンでベースURLが変わる点なんですよ。北京・シンガポール・米国バージニアで別物なので、コピペ元を間違えると認証で止まります。
公式ドキュメントの値を確認してください。
公式ドキュメントの値を確認してください。
室谷代表取締役モデル名の指定も地味に効きます。
ここは乗り換えコストの話に直結しますね。
qwen3.5-plus を渡す形で、OpenAI互換で叩けるから既存コードの差分が小さい。ここは乗り換えコストの話に直結しますね。
テキトー教師DotAI 認定講師手元で試す段階と、サービスに載せる段階を分けて考えると混乱しにくいです。まずはキー1本で1リクエスト通すところから。
Web検索やCode Interpreterを自動で呼び出す仕組み
テキトー教師DotAI 認定講師ここが面白いところで、API側にWeb検索とCode Interpreterが組み込まれていて、モデルが自分で必要と判断して自動で呼び出すんですよ。利用者が「検索して」と毎回指示する前提じゃなくなります。
室谷代表取締役自前で検索APIを繋いでオーケストレーションを組む工数を考えると、時給換算でかなり差が出ます。パイプラインをわざわざ作る前提が崩れるわけです。
テキトー教師DotAI 認定講師ただ、勝手に呼ばれるのが困る場面もあるので、いきなり本番に置かず小さいタスクで挙動を見るのがおすすめです。何を呼んだかログで追えるようにしておくと安全です。
商用利用は配布ページのLICENSEを必ず確認する
室谷代表取締役オープンウェイトだから何でも自由、という話ではないんですよね。配布ページにはLICENSEファイルが同梱されているので、使うモデルごとに中身を確認する。
サイズごとに条件が違う可能性があるので、まとめて判断しない方がいいです。
サイズごとに条件が違う可能性があるので、まとめて判断しない方がいいです。
テキトー教師DotAI 認定講師ここは質問が多いところで、「無料で使える=商用OK」と短絡しがちなんです。配布ページとモデルカードをセットで見る癖をつけると事故が減ります。
室谷代表取締役事業に組み込むなら、法務に投げる一手間を惜しまない方がいい。後から揉めるコストの方がよほど高いので。
2026年11月時点でQwen3.5を選ぶべきか。Qwen3.8やQwen4-Maxとの比較
既にQwen3.6・3.8系とQwen4-Maxが公開されている
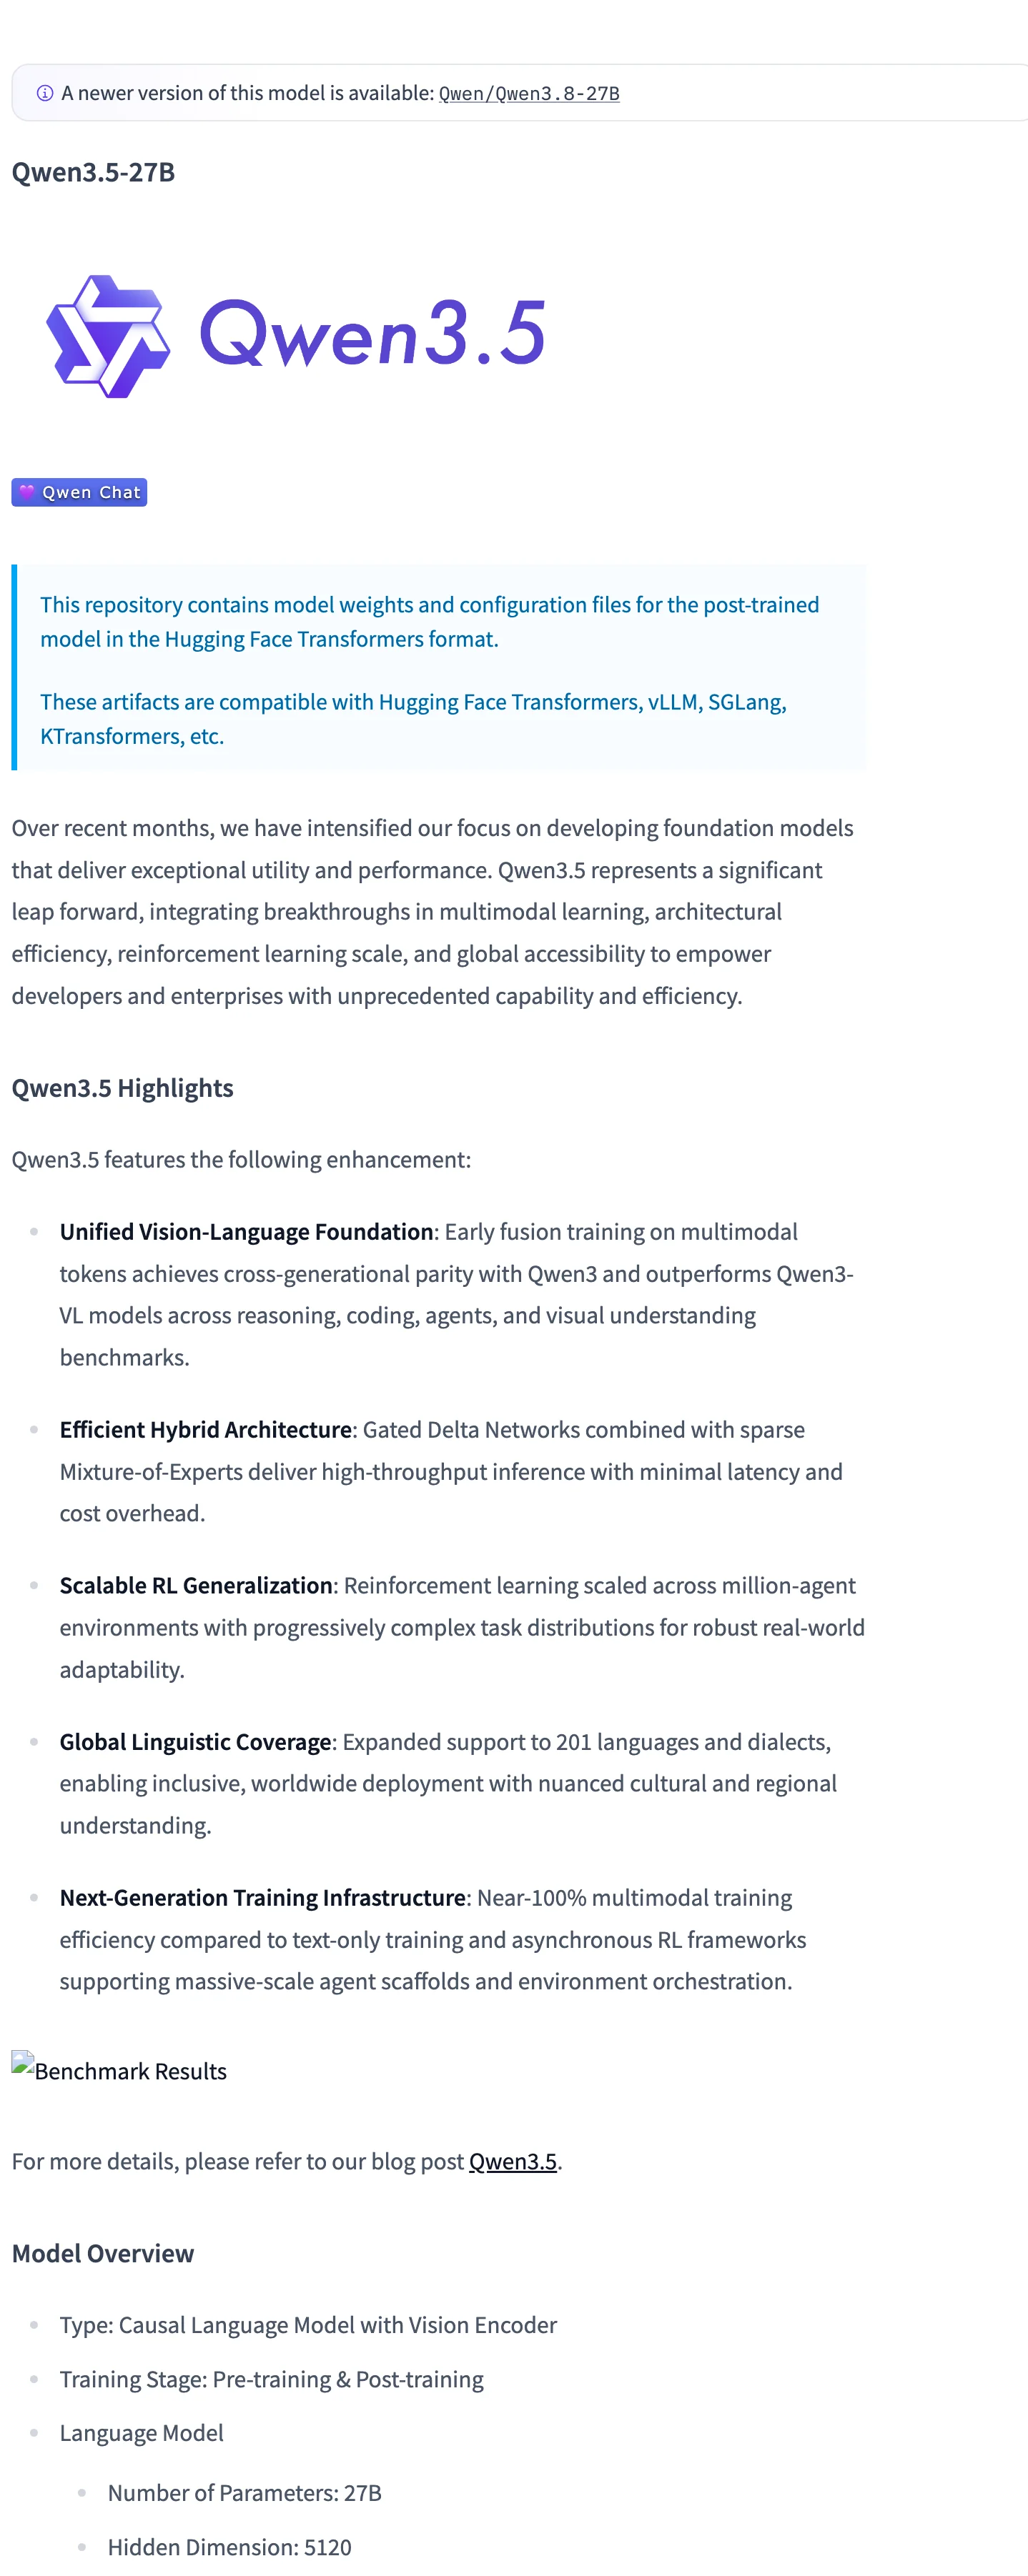
室谷代表取締役Qwen公式のResearchページ、2026年11月16日付の最新記事がQwen4-Maxなんですよ。2.4兆パラメータで100万トークンコンテキスト。
つまりQwen3.5は、もう最新世代じゃないんですよね。
つまりQwen3.5は、もう最新世代じゃないんですよね。
テキトー教師DotAI 認定講師モデルカードを見ても「新しいバージョンがあります」という案内が出てますからね。初めて触る人は「これが今の一番新しいんですか」と戸惑うんですよ。
室谷代表取締役2月に397B-A17Bが出てから、世代の回るスピードが速すぎるんですよ。経営目線で言うと、モデル選定を人の記憶に頼る体制がもう限界なんですよね。
詳しくはAlibabaの「Qwen4」とは?Qwen4-MaxがToken Planでプレビュー提供開始で解説しています。
詳しくはAlibabaの「Qwen4」とは?Qwen4-MaxがToken Planでプレビュー提供開始で解説しています。
テキトー教師DotAI 認定講師現場感覚でも、半年前の前提で話すと普通にズレますからね。
Model Studioの推奨はqwen4-max、qwen3.7-plus、qwen3.8-flashに移っている
テキトー教師DotAI 認定講師Alibaba Cloud Model Studioのモデル一覧は2026年11月16日更新で、テキスト生成の推奨がqwen4-max、qwen3.7-plus、qwen3.8-flashに変わってるんですよ。
室谷代表取締役qwen3.5-plusはAPIプラットフォームの一覧には残ってるけど、推奨の枠からは外れてる、と。これは「消えた」じゃなくて「推奨の座を譲った」なんですよね。
テキトー教師DotAI 認定講師そこ、混同しやすいんですよ。すでに動いてるコードが止まる話ではないので。
室谷代表取締役ベンダーが推奨枠を最新に寄せるのは構造上自然なんですよ。ただ現場は「じゃあ今すぐ乗り換えるべきなのか」で止まる。
ここが今回の論点ですね。
ここが今回の論点ですね。
それでもQwen3.5に残る価値は何か
室谷代表取締役無料で試せるし、オープンウェイトも出てる。397B-A17Bは活性17BでSWE-bench Verifiedが76.4ですから、性能は今でも実用水準なんですよね。
テキトー教師DotAI 認定講師重みが公開されているぶん、すでに検証済みの構成を持ってる人にとっては、そのまま使い続けられるのが大きいんですよ。
室谷代表取締役時給で換算すると、載せ替えの検証に何十時間も投げるより、動いてるワークロードはQwen3.5のまま回して、新規だけ上位に寄せる方が割に合うんですよね。
テキトー教師DotAI 認定講師全部捨てなくていい、という整理ですね。そこが一番つまずきやすいところで。
新規導入でどれを選ぶかの判断基準
テキトー教師DotAI 認定講師新しくAPIから入るなら、まずModel Studioの推奨一覧から選ぶのが無難なんですよ。qwen4-max、qwen3.7-plus、qwen3.8-flashが並んでますから。
室谷代表取締役逆に自前で重みを持ちたいなら、Qwen3.8系列の配布状況を確認してから決める。Qwen3.5の重みも残ってるので、並べて比較はできるんですよね。
テキトー教師DotAI 認定講師最初に戸惑うのが、世代とサイズを同時に比べようとして混乱するパターンなんですよ。世代を先に決めて、その中でサイズを選ぶ順番がいいですね。
室谷代表取締役あとライセンスは世代が変わっても同じで、配布ページのLICENSEを必ず見る。ここだけは省略しない方がいいです。
よくある質問
Q1. Qwen3.5は日本語の文章作成に向いていますか?
室谷代表取締役日本語の品質って、用途によって結構差が出るんですよね。ビジネス文書で使うなら、自社の文例をいくつか食わせて試すのが一番早いです。
テキトー教師DotAI 認定講師初めて触る人は、デモの派手さだけ見て期待しすぎちゃうことが多いんですよ。日本語は敬語や固有名詞の扱いを、短い文章で先に確認するといいと思います。
室谷代表取締役あと、いきなり本番に置くんじゃなくて、校正にかかってる時間がどれだけ減るかで見る。ROIで判断した方が現実的です。
Q2. Qwen3.5を業務システムに組み込むとき、最初に何を確認すべきですか?
テキトー教師DotAI 認定講師現場でよく聞くのは、出力の安定性と失敗したときの逃げ道です。同じ入力でも毎回同じ感じで返るか、変な形式で返ってきたときに止められるか。
室谷代表取締役そうですね。レスポンスの遅さも業務だとじわじわ効くので、許容できる待ち時間を先に決める。
MYUUUの現場でも、速さとコストはセットで見てます。
MYUUUの現場でも、速さとコストはセットで見てます。
テキトー教師DotAI 認定講師最初に戸惑うのが、モデルの性能だけ見て運用の監視を後回しにしちゃうことなんですよ。ログを残す設計にしておくと後で楽です。
Q3. Qwen3.5のファインチューニングはできますか?
室谷代表取締役できるかどうかは公式の対応状況を見るのが確実なんですよね。まずはプロンプトと検索でどこまで行くかを試す。
テキトー教師DotAI 認定講師たしかに。現場感覚で言うと、いきなり学習させるより、失敗例を集めてから判断する方がハマりにくいです。
室谷代表取締役学習コストも馬鹿にならないので、費用対効果で見た方がいいです。
Q4. Qwen3.5の推論速度は気にした方がいいですか?
室谷代表取締役対話で使うなら体感、バッチ処理ならスループット。使い方で見る数字が変わるんですよね。
テキトー教師DotAI 認定講師初めて触る人は、ベンチマークの点数だけ見がちなんですけど、実際は待ち時間が長いと使われなくなるんですよ。
Q5. Qwen3.5を社内利用するとき、セキュリティで注意する点は?
室谷代表取締役オンプレかAPIかで前提が変わるので、データがどこを通るかは先に確認したいですね。
テキトー教師DotAI 認定講師社内でよくあるのが、入力に顧客情報を入れていいのかの線引きが曖昧なまま始まっちゃうケースです。ルールを先に決めると事故が減ります。
室谷代表取締役あと、出力をそのまま使わずに人が確認する工程を残す。これがないと、責任の所在がふわっとします。
まとめ
室谷代表取締役Qwen3.5、結局は万能選手じゃなくて、サイズと用途で選ぶモデルなんですよね。Qwen3.8やQwen4-Maxがある今は、最新だけ追うより目的で選ぶ。
テキトー教師DotAI 認定講師たしかに。最初に戸惑うのが、モデル名の多さで止まっちゃうことなんですよ。
まず小さく試して、日本語とコストを見る。
まず小さく試して、日本語とコストを見る。
室谷代表取締役MYUUUの現場では、いきなり大きなモデルを本番に置かず、検証用の小さな環境から始めます。
テキトー教師DotAI 認定講師読むだけより、触った方が早いです。公式のモデルカードを見て、自分の用途で一つ試すところからでいいと思います。